<?xml version="1.0" encoding="utf-8"?>
<?xml-stylesheet href="/feeds/atom-style.xsl" type="text/xsl"?>
<feed xmlns="http://www.w3.org/2005/Atom">
    <id>https://lainbo.dev/</id>
    <title>Lainbo's Blog</title>
    <updated>2026-09-25T16:50:31.312Z</updated>
    <generator>Astro-Theme-Retypeset with Feed for Node.js</generator>
    <author>
        <name>Lainbo</name>
        <uri>https://lainbo.dev/</uri>
    </author>
    <link rel="alternate" href="https://lainbo.dev/"/>
    <link rel="self" href="https://lainbo.dev/atom.xml"/>
    <rights>Copyright © 2026 Lainbo</rights>
    <entry>
        <title type="html"><![CDATA[域名邮箱转到 Gmail 被丢垃圾邮件？用 Gmail API 把邮件直接写进收件箱]]></title>
        <id>https://lainbo.dev/posts/domain-email-to-telegram-bot/</id>
        <link href="https://lainbo.dev/posts/domain-email-to-telegram-bot/"/>
        <updated>2026-09-26T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[自己写了个 Synopsis，邮件原件存进 Gmail，Telegram 里看中文摘要]]></summary>
        <content type="html"><![CDATA[<p><img src="https://lainbo.dev/_astro/domain-email-to-telegram-bot.xYUuN6cE_22C6Uj.webp" alt="" /></p>
<h2>从转发到 Gmail 说起</h2>
<p>我的域名邮箱一直用 Cloudflare Email Routing 收信，最开始直接转发到 Gmail。配置很简单，用了一阵才发现很多正规平台的邮件都没收到：npm 的验证码、HSBC 的通知，甚至 Apple 的邮件。Cloudflare 的日志显示已经转发成功，最后在 Gmail 的垃圾邮件里找到了它们。</p>
<p>问题出在转发这个动作上。Cloudflare 收下邮件后，会用自己的服务器把它再投递一次给 Gmail。在 Gmail 看来，这封邮件自称来自 HSBC，却是 Cloudflare 的服务器送来的。Gmail 只能靠原始的 DKIM 签名和它对这条链路的信任来判断真假，判断不准的就进了垃圾邮件。</p>
<h2>换成 mail2telegram 之后</h2>
<p>后来我换成了 <a href="https://github.com/TBXark/mail2telegram">mail2telegram</a>，这篇文章的旧版本写的就是它的部署教程。邮件交给 Cloudflare Worker 处理，直接推送到 Telegram Bot。为了长期保存，我还配了 <code>FORWARD_LIST</code>，让它把邮件顺便备份到 Gmail。</p>
<p>这个备份在 Worker 里调用的是 <code>message.forward()</code>，本质上还是 Cloudflare 把邮件再投递一遍，和最开始的转发走同一条路。Telegram 这边的问题解决了，备份那边的老问题还在。</p>
<p>让我决定换掉它的是 Steam 的邮件。大概是 Steam 发信那边的某项配置有问题，这些邮件在转发时直接被 Cloudflare 拦了下来，Gmail 里根本收不到。以前进了垃圾箱，至少还能翻出来，这回连备份都没有。</p>
<p>只要备份还靠「再发一次」，就得看中间每一环的脸色：从发件方的认证配置到 Cloudflare 的检查，再到 Gmail 的反垃圾策略，哪一环不认，邮件就到不了。所以我决定备份这一步干脆不发信。</p>
<h2>换个思路：用 Gmail API 直接写入</h2>
<p>Gmail API 有一个 <a href="https://developers.google.com/workspace/gmail/api/reference/rest/v1/users.messages/insert"><code>users.messages.insert</code></a> 接口，官方文档是这么描述的：</p>
<blockquote>
<p>Directly inserts a message into only this user's mailbox similar to IMAP APPEND, bypassing most scanning and classification. Does not send a message.</p>
</blockquote>
<p>意思是它和 IMAP 的 APPEND 类似，把一封邮件直接放进这个用户自己的邮箱，跳过大部分扫描和分类，也不会发出任何邮件。</p>
<p>这正是我要的。Worker 收到邮件后拿到原始字节，用 OAuth 授权调用这个接口，把邮件写进 Gmail 收件箱。整个过程没有 SMTP 投递，没有 SPF、DKIM 要过，Gmail 也不会像对待外来邮件那样审查它，拒收和进垃圾箱都无从谈起。</p>
<p>写进去的是完整的原始邮件，邮件头、正文和附件都在，在 Gmail 里打开和正常收到的邮件一样。邮件时间取自它自己的 <code>Date</code> 头，在收件箱里的排序也是对的。</p>
<h2>Synopsis</h2>
<p>按这个思路，我从零写了 Synopsis，运行在 Cloudflare Workers 上，已经开源：</p>
<p>::github{repo="lainbo/synopsis"}</p>
<p>它把域名邮件完整备份到 Gmail，同时在 Telegram 私聊里发一条中文摘要。</p>
<pre><code>flowchart TD
    A[域名收到邮件] --&gt; B[Cloudflare Email Routing 交给 Worker]
    B --&gt; C[Gmail API 写入原始邮件]
    C -- 成功 --&gt; F[AI 生成中文摘要并推送到 Telegram]
    C -- 失败 --&gt; D[依次尝试 Cloudflare Email Sending 和 Resend 发送原件]
    D -- 成功 --&gt; F
    D -- 都失败 --&gt; E[Telegram 告警，Cloudflare 稍后重新投递]
</code></pre>
<h3>Telegram 里能做什么</h3>
<p>每封邮件到了之后，Bot 会发来一条摘要：</p>
<ul>
<li>第一行写着这封邮件发到了哪个地址。给不同网站注册时用不同的别名，一眼就能看出是哪家来的信。</li>
<li>验证码邮件会把验证码单独放一行，点一下就能复制。</li>
<li>其他邮件是一段 30 到 60 字的总结，最后一行用 🟢、🟡、🔴 标出需不需要处理、有多急。邮件里有退订入口的，还会顺带提醒可以退订。</li>
<li>点「原文」可以在 Telegram 里直接看正文，看完点「返回摘要」切回来。</li>
<li>点「删邮件+消息」会把 Gmail 里的这封邮件移进垃圾箱，同时删掉这条 Telegram 消息，适合处理用完就没用的验证码邮件。</li>
</ul>
<p>摘要可以用三种 AI 服务，任选一种：OpenAI 兼容接口、OpenRouter 和 Gemini。默认提示词会把描述性的内容都转成简体中文，验证码、金额和单号这类需要原样复制的内容保持不变。</p>
<h3>备份优先</h3>
<p>写这个项目时，我让原件备份排第一，摘要和通知晚一点也没关系。</p>
<ul>
<li>Gmail 写入失败时（比如授权过期），会依次尝试 Cloudflare Email Sending 和 Resend，往另一个邮箱发一封带 <code>original.eml</code> 附件的邮件，同时在 Telegram 告警。这两个兜底都是可选项，但建议至少配一个。</li>
<li>AI 出错或者 Telegram 发送失败，都不会影响已经完成的备份。摘要失败时 Bot 会发一条占位消息，说明原件已经备份。</li>
<li>通知没发出去的邮件，定时任务每 5 分钟检查一次，按记录的状态补发。</li>
</ul>
<p>兜底走的还是发信那条路，只在 Gmail API 出问题时临时顶上，日常备份靠的一直是 Gmail API 写入。</p>
<h2>部署</h2>
<p>完整步骤和每个配置项的说明都在仓库的 <a href="https://github.com/lainbo/synopsis#readme">README</a> 里，这里只讲大致流程和几个容易踩坑的地方。</p>
<h3>准备</h3>
<ul>
<li>一个接入 Cloudflare 的域名，会用到 Email Routing、Workers 和 KV</li>
<li>一个用来收备份的 Gmail 账号，以及你自己在 Google Cloud 创建的 OAuth 客户端</li>
<li>一个 Telegram Bot</li>
<li>OpenAI 兼容接口、OpenRouter、Gemini 三选一的 API key</li>
<li>Node.js 22 以上和 pnpm</li>
</ul>
<h3>1. 安装依赖，创建 KV</h3>
<pre><code>git clone https://github.com/lainbo/synopsis.git
cd synopsis
pnpm install --frozen-lockfile
cp wrangler.example.jsonc wrangler.jsonc
cp .dev.vars.example .dev.vars
pnpm exec wrangler login
pnpm exec wrangler kv namespace create MAIL_KV
pnpm exec wrangler kv namespace create MAIL_KV --preview
</code></pre>
<p>把得到的两个 KV ID 填进 <code>wrangler.jsonc</code>。</p>
<h3>2. 拿到 Gmail 的 refresh token</h3>
<p>这是整个部署里最麻烦的一步。</p>
<ol>
<li>在 <a href="https://console.cloud.google.com/">Google Cloud Console</a> 新建项目，启用 Gmail API。</li>
<li>在 Google Auth Platform 里配置应用，受众选 External，<strong>然后把发布状态切到 Production</strong>。一直停在 Testing 状态的话，refresh token 通常 7 天就会过期，备份也就跟着断了。</li>
<li>创建 Web application 类型的 OAuth 客户端，授权重定向 URI 填 <code>https://developers.google.com/oauthplayground</code>。</li>
<li>打开 <a href="https://developers.google.com/oauthplayground/">OAuth Playground</a>，在右上角的设置里勾选 <strong>Use your own OAuth credentials</strong>，填入刚才的 client ID 和 client secret，Access type 选 Offline。</li>
<li>在 Step 1 填入下面两个 scope 并授权，账号选用来收备份的那个 Gmail：</li>
</ol>
<pre><code>https://www.googleapis.com/auth/gmail.insert
https://www.googleapis.com/auth/gmail.modify
</code></pre>
<ol>
<li>在 Step 2 点 <strong>Exchange authorization code for tokens</strong>，保存 <code>refresh_token</code>。</li>
</ol>
<p><code>gmail.insert</code> 用来写入邮件，<code>gmail.modify</code> 用来查询邮件状态和移进垃圾箱，Telegram 里的删除按钮靠的就是它。</p>
<h3>3. 创建 Telegram Bot</h3>
<p>在 BotFather 里用 <code>/newbot</code> 创建 Bot，保存好 token。然后用自己的账号给 Bot 发一条 <code>/start</code>，再读出自己的私聊 ID，仓库的 <a href="https://github.com/lainbo/synopsis/blob/main/docs/telegram-setup.md">Telegram 设置文档</a> 里有现成的脚本。最后随机生成一串字符作为 <code>TG_WEBHOOK_SECRET</code>，只能用字母、数字、下划线和短横线。</p>
<h3>4. 写入 Secrets，选择 AI 服务</h3>
<p>生产环境的密钥都用 <code>wrangler secret put</code> 写入，不要写进配置文件：</p>
<pre><code>pnpm exec wrangler secret put GMAIL_CLIENT_ID
pnpm exec wrangler secret put GMAIL_CLIENT_SECRET
pnpm exec wrangler secret put GMAIL_REFRESH_TOKEN
pnpm exec wrangler secret put TG_BOT_TOKEN
pnpm exec wrangler secret put TG_CHAT_ID
pnpm exec wrangler secret put TG_WEBHOOK_SECRET
</code></pre>
<p>AI 服务在 <code>wrangler.jsonc</code> 的 <code>vars</code> 里选择。以 Gemini 为例：</p>
<pre><code>{
  "SUMMARY_PROVIDER": "gemini",
  "GEMINI_MODEL": "你要用的模型 ID"
}
</code></pre>
<p>再写入对应的密钥：</p>
<pre><code>pnpm exec wrangler secret put GEMINI_API_KEY
</code></pre>
<p>选 OpenAI 兼容接口或 OpenRouter 时，把变量名换成 <code>OPENAI_*</code> 或 <code>OPENROUTER_*</code> 就行。用第三方的 OpenAI 兼容服务，还要填 <code>OPENAI_BASE_URL</code>。</p>
<p>兜底发信（Cloudflare Email Sending、Resend）的配置见 README 的「邮件兜底」一节。</p>
<h3>5. 部署，接上 Telegram 和邮件路由</h3>
<pre><code>pnpm run deploy
</code></pre>
<p>部署完成后：</p>
<ol>
<li>按 README 注册 Telegram webhook，地址是 <code>https://&lt;你的 Worker 地址&gt;/telegram/webhook</code>，<code>secret_token</code> 填刚才的 <code>TG_WEBHOOK_SECRET</code>。</li>
<li>在 Cloudflare 控制台打开域名的 <strong>电子邮件路由</strong>，把 Catch-all（或者某个指定地址）的操作改成 <strong>发送到 Worker</strong>，选择 <code>synopsis</code>。</li>
<li>往域名邮箱发一封普通邮件和一封带附件的邮件，确认 Gmail 收件箱里有原件、附件能打开，Telegram 收到了摘要，「原文」和「返回摘要」都能用。</li>
</ol>
<h2>使用前要知道的</h2>
<ul>
<li>只支持一个 Gmail 账号，Telegram 也只能本人私聊使用。</li>
<li>Telegram 里的原文是纯文本，长邮件会截断，完整排版和附件要去 Gmail 看。</li>
<li>生成摘要需要把邮件内容发给你选的 AI 服务，验证码之类的敏感信息也在里面，选服务商时要考虑这一点。</li>
<li>正文缓存默认保留 7 天，过期后 Telegram 里的按钮就用不了了，邮件本身还在 Gmail 里。</li>
<li>「返回摘要」会重新调用一次 AI，会产生额外费用。</li>
</ul>
<h2>总结</h2>
<p>换成 Synopsis 之后，域名邮件都会出现在 Gmail 收件箱里，包括之前被拦下的 Steam 邮件。Telegram 负责第一时间告诉我来了什么邮件、要不要处理，Gmail 负责长期保存。</p>
<p>如果你也在用 Cloudflare Email Routing 转发到 Gmail，又被垃圾邮件或者转发失败困扰，可以试试这个项目。</p>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2025-10-21T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Alist 事件后，我如何用 Deno 解决 Koofr WebDAV 在国内的访问难题]]></title>
        <id>https://lainbo.dev/posts/koofr-deno/</id>
        <link href="https://lainbo.dev/posts/koofr-deno/"/>
        <updated>2025-06-12T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[Alist 风波后换到 Koofr，再用 Deno 反代解决国内同步困难]]></summary>
        <content type="html"><![CDATA[<p><img src="https://lainbo.dev/_astro/koofr-deno.agOjgA_4_1s3x9h.webp" alt="" /></p>
<p>最近，知名的开源项目 Alist 发生了一系列风波，引发了社区对供应链安全的广泛担忧。这件事对我个人而言，不仅是一个安全警示，更是一个契机，让我重新审视了长期以来依赖自建服务的策略。</p>
<p>我使用 Alist，<strong>主要看重的是其强大的 WebDAV 服务和多用户权限功能，而不是他能挂一堆网盘上去</strong>，它让我在自己的服务器上轻松地搭建起了个人数据同步中心。但这次事件让我意识到，**自建服务除了要面对潜在的供应链风险（项目本身、作者提供的回调API等），**其稳定性也完全受限于我们自己的服务器和运维能力，强如DMIT，上个月也因为大楼的疑似火警，宕机了几个小时，我们购买的服务器，其SLA更是无法与专业的服务商相提并论。因此，我决定寻找一个由专业团队维护、提供原生WebDAV支持的云存储服务作为替代。</p>
<h3><strong>寻找替代方案：从自建到专业服务</strong></h3>
<p>我的选型标准很明确：<strong>可靠的专业服务、良好的隐私策略、以及原生的 WebDAV 支持。</strong></p>
<ul>
<li><strong>坚果云</strong> 是一个优秀的选择，可惜但在免费套餐下，每月1GB的上传和3GB的下载流量，对于需要频繁同步的WebDAV场景来说，限制较大。</li>
<li>随后，我注意到了 <strong>Koofr</strong>。这是一家欧洲的服务商，以注重用户隐私而闻名。其免费套餐相当有诚意：
<ul>
<li>10 GB 存储空间</li>
<li>不限制单文件大小</li>
<li>支持 WebDAV</li>
<li>每日 50 GB 的公开分享带宽</li>
<li>可以挂载OneDrive和Google Drive</li>
</ul>
</li>
</ul>
<p>这些特性几乎完美满足了我所有的需求，尤其是原生WebDAV支持，免去了自行部署和维护的麻烦。</p>
<h3><strong>新的问题：网络延迟与访问速度</strong></h3>
<p>然而，在将我的 WebDAV 客户端指向 Koofr 后，一个新的问题出现了。由于其服务器位于欧洲，使用本地网络直接访问的连接质量非常不稳定，<strong>WebDAV 的传输速度长期维持在几十KB/s，这让文件同步几乎无法正常进行。</strong></p>
<p>放弃如此契合的服务实在可惜，我需要一个更轻量、高效的解决方案。</p>
<h3><strong>解决方案：利用 Deno Playground搭建轻量级中继</strong></h3>
<p>此时，我想起了之前编写的一个部署在 Deno 上的反向代理脚本，这个脚本原先是为了代理那些连通性比较差的AI的API用的，能代理这些AI，也就能代理Koofr！</p>
<p>Deno 的 Playground 运行在谷歌云上，虽然是谷歌云但是使用本地网络访问起来速度很不错，它的免费额度（每月100万次请求，100GB出站流量）也非常充裕。</p>
<p>我的想法是，将这个脚本稍作修改，让他支持Koofr 的 WebDAV代理。所有本地到Koofr的请求，都先经过Deno Deploy的节点进行转发，从而绕开不佳的国际链路，实现加速效果。</p>
<h3><strong>核心代码如下</strong></h3>
<p>改造的核心是增加对 Koofr 域名的代理，并特殊处理 WebDAV 的 <code>PROPFIND</code> 方法。因为 WebDAV 客户端在列出目录时，响应的XML文件中包含了文件的URL路径。代理必须将这些路径从目标服务器的路径（如 <code>/dav/Koofr/file.txt</code>）重写为代理服务器的路径（如 <code>/koofr/dav/Koofr/file.txt</code>），客户端才能正确识别。</p>
<pre><code>import { serve, type ServeHandlerInfo } from "https://deno.land/std@0.224.0/http/server.ts";

// 定义路径到目标URL的映射
// 键是代理服务器接收到的路径前缀，值是对应的目标服务器基础URL
const pathMappings: Record&lt;string, string&gt; = {
  '/anthropic': 'https://api.anthropic.com',
  '/gemini': 'https://generativelanguage.googleapis.com',
  '/openai': 'https://api.openai.com', // 目标是根路径
  '/openrouter': 'https://openrouter.ai/api', // 目标本身有路径 /api
  '/xai': 'https://api.x.ai',
  '/telegram': 'https://api.telegram.org',
  '/discord': 'https://discord.com/api',    // 目标本身有路径 /api
  '/groq': 'https://api.groq.com/openai',   // 目标本身有路径 /openai
  '/cohere': 'https://api.cohere.ai',
  '/huggingface': 'https://api-inference.huggingface.co',
  '/together': 'https://api.together.xyz',
  '/novita': 'https://api.novita.ai',
  '/portkey': 'https://api.portkey.ai',
  '/fireworks': 'https://api.fireworks.ai/inference', // 目标本身有路径 /inference
  '/koofr': 'https://app.koofr.net',
};

// 从环境变量 "PORT" 获取端口号，如果未设置则默认为 8000
const port = parseInt(Deno.env.get("PORT") || "8000");

console.log(`代理服务器正在启动，监听端口: &lt;http://localhost&gt;:${port}`);

// 启动HTTP服务器，为每个请求调用回调函数
serve(async (req: Request, _connInfo: ServeHandlerInfo) =&gt; {
  const incomingUrl = new URL(req.url); // 解析入站请求的URL
  const incomingPathname = incomingUrl.pathname; // 获取入站请求的路径部分

  // 创建包含安全相关头部的 Headers 对象
  const createSecureHeaders = (contentType?: string): Headers =&gt; {
    const headers = new Headers();
    if (contentType) {
      headers.set('Content-Type', contentType);
    }
    headers.set('X-Content-Type-Options', 'nosniff');
    headers.set('X-Frame-Options', 'DENY');
    headers.set('Referrer-Policy', 'no-referrer');
    return headers;
  };

  if (incomingPathname === '/' || incomingPathname === '/index.html') {
    return new Response(null, {
      status: 404,
      headers: createSecureHeaders()
    });
  }

  if (incomingPathname === '/robots.txt') {
    return new Response('User-agent: *\\nDisallow: /', {
      status: 200,
      headers: createSecureHeaders('text/plain')
    });
  }

  let targetBaseUrlString: string | undefined;
  let matchedPrefix: string | undefined;

  for (const prefix in pathMappings) {
    if (incomingPathname.startsWith(prefix)) {
      targetBaseUrlString = pathMappings[prefix];
      matchedPrefix = prefix;
      break;
    }
  }

  if (!targetBaseUrlString || !matchedPrefix) {
    console.warn(`[${new Date().toISOString()}] 未找到路径映射: ${incomingPathname}`);
    return new Response("未找到: 此路径没有代理映射。", {
      status: 404,
      headers: createSecureHeaders('text/plain')
    });
  }

  const parsedTargetBaseUrl = new URL(targetBaseUrlString);
  // suffixPath 是入站请求路径中，匹配掉代理前缀后的剩余部分。
  // 例如：incomingPathname = "/openrouter/v1/chat", matchedPrefix = "/openrouter" -&gt; suffixPath = "/v1/chat"
  // 例如：incomingPathname = "/openai/foo", matchedPrefix = "/openai" -&gt; suffixPath = "/foo"
  // 例如：incomingPathname = "/openrouter", matchedPrefix = "/openrouter" -&gt; suffixPath = ""
  const suffixPath = incomingPathname.substring(matchedPrefix.length);

  // --- 路径拼接逻辑 ---
  // 1. 规范化基础URL (`baseForNewUrl`)
  //    目标是确保如果 parsedTargetBaseUrl 本身有路径 (其 pathname 不是根路径"/")，
  //    那么 baseForNewUrl 的字符串表示应该以 "/" 结尾，以便 new URL() 正确地追加相对路径。
  let baseForNewUrl = parsedTargetBaseUrl.href; // 初始为映射中定义的URL的href字符串
                                               // e.g., "&lt;https://api.openai.com/&gt;" or "&lt;https://openrouter.ai/api&gt;"

  // 检查 parsedTargetBaseUrl.pathname:
  // - "&lt;https://api.openai.com&gt;" -&gt; pathname is "/"
  // - "&lt;https://openrouter.ai/api&gt;" -&gt; pathname is "/api"
  // - "&lt;https://openrouter.ai/api/&gt;" -&gt; pathname is "/api/"
  if (parsedTargetBaseUrl.pathname !== '/' &amp;&amp; !baseForNewUrl.endsWith('/')) {
    // 如果目标URL的路径不是根目录，并且其href不以'/'结尾 (例如 "&lt;https://host.com/path&gt;")
    // 则在其末尾添加'/'，使其变为 "&lt;https://host.com/path/&gt;"
    baseForNewUrl += '/';
  }
  // 现在 baseForNewUrl 对于有路径的基础URL，其路径部分会以'/'结尾 (如 "&lt;https://host.com/path/&gt;")
  // 对于根路径的基础URL，它可能是 "&lt;https://host.com/&gt;" 或 "&lt;https://host.com&gt;" (URL构造函数都能正确处理)

  // 2. 规范化要追加的路径 (`pathForNewUrl`)
  //    目标是确保从 suffixPath 得到的路径是一个相对路径（不以 "/" 开头）。
  let pathForNewUrl = suffixPath;
  // - suffixPath = "/v1/chat" -&gt; pathForNewUrl = "v1/chat"
  // - suffixPath = "v1/chat"  -&gt; pathForNewUrl = "v1/chat" (不变)
  // - suffixPath = ""        -&gt; pathForNewUrl = "" (不变)
  if (pathForNewUrl.startsWith('/')) {
    pathForNewUrl = pathForNewUrl.substring(1);
  }

  // 3. 构建最终的目标URL
  //    使用规范化的 baseForNewUrl 和 pathForNewUrl。
  //    例如:
  //    - req: /openai/v1/chat -&gt; target: &lt;https://api.openai.com&gt;, suffix: /v1/chat
  //      base: "&lt;https://api.openai.com/&gt;" (或 "&lt;https://api.openai.com&gt;"), path: "v1/chat"
  //      -&gt; new URL("v1/chat", "&lt;https://api.openai.com/&gt;") -&gt; &lt;https://api.openai.com/v1/chat&gt;
  //    - req: /openrouter/v1/chat -&gt; target: &lt;https://openrouter.ai/api&gt;, suffix: /v1/chat
  //      base: "&lt;https://openrouter.ai/api/&gt;", path: "v1/chat"
  //      -&gt; new URL("v1/chat", "&lt;https://openrouter.ai/api/&gt;") -&gt; &lt;https://openrouter.ai/api/v1/chat&gt; (正确!)
  //    - req: /openrouter -&gt; target: &lt;https://openrouter.ai/api&gt;, suffix: ""
  //      base: "&lt;https://openrouter.ai/api/&gt;", path: ""
  //      -&gt; new URL("", "&lt;https://openrouter.ai/api/&gt;") -&gt; &lt;https://openrouter.ai/api/&gt;
  const finalTargetUrl = new URL(pathForNewUrl + incomingUrl.search, baseForNewUrl);
  // --- 路径拼接逻辑结束 ---

  const headersToProxy = new Headers(req.headers);
  headersToProxy.set("Host", finalTargetUrl.host); // 使用最终目标URL的主机名

  // 删除不应被代理的 "hop-by-hop" 头部
  headersToProxy.delete("X-Forwarded-For");
  headersToProxy.delete("X-Real-IP");
  headersToProxy.delete("Forwarded");
  headersToProxy.delete("Via");

  const proxyReq = new Request(finalTargetUrl.toString(), {
    method: req.method,
    headers: headersToProxy,
    body: req.body,
    redirect: "manual", // 代理服务器不应自动处理重定向
  });

  try {
    const proxyRes = await fetch(proxyReq);

    // --- WebDAV 路径重写逻辑 ---
    // 检查是否为需要重写响应体的特定请求。
    // 针对 Koofr WebDAV 的场景：当请求方法为 PROPFIND (WebDAV用于列出目录内容的方法)
    // 且请求路径前缀为 /koofr 时，我们需要修改响应内容。
    if (matchedPrefix === '/koofr' &amp;&amp; req.method === 'PROPFIND') {
      const contentType = proxyRes.headers.get('Content-Type') || '';
      // 确保我们只修改XML响应，这是WebDAV列表的格式。
      if (proxyRes.ok &amp;&amp; (contentType.includes('application/xml') || contentType.includes('text/xml'))) {
        const originalBodyText = await proxyRes.text();

        // `suffixPath` 是目标服务器上的路径, 例如 "/dav/Koofr/webdav"
        // `incomingPathname` 是客户端请求代理服务器的完整路径, 例如 "/koofr/dav/Koofr/webdav"
        // 目标服务器返回的XML内容中包含了大量的 `suffixPath`。
        // 我们需要将它们全部替换为 `incomingPathname`，以便客户端能构建正确的URL。
        // 例如，将 XML 中的 href="/dav/Koofr/webdav/file.zip" 替换为 href="/koofr/dav/Koofr/webdav/file.zip"。

        // 使用 String.prototype.replaceAll() 进行全局替换。
        // 增加一个安全检查，避免 `suffixPath` 为 "/" 时替换掉所有根路径。
        if (suffixPath &amp;&amp; suffixPath.length &gt; 1) {
          const rewrittenBody = originalBodyText.replaceAll(suffixPath, incomingPathname);

          const responseHeaders = new Headers(proxyRes.headers);
          // 因为我们修改了响应体，原有的 'Content-Length' 头不再准确，
          // 需要删除它，以便Deno/HTTP服务器自动重新计算。
          responseHeaders.delete('Content-Length');

          // 为代理响应添加/确保我们自己的安全头部
          responseHeaders.set('X-Content-Type-Options', 'nosniff');
          responseHeaders.set('X-Frame-Options', 'DENY');
          responseHeaders.set('Referrer-Policy', 'no-referrer');

          // 返回修改后的响应
          return new Response(rewrittenBody, {
            status: proxyRes.status,
            statusText: proxyRes.statusText,
            headers: responseHeaders,
          });
        }
      }
    }
    // --- WebDAV 路径重写逻辑结束 ---

    // 对于所有其他请求，或者不满足上述重写条件的请求，执行原始的透传逻辑。
    const responseHeaders = new Headers(proxyRes.headers);

    // 从目标服务器的响应中删除 hop-by-hop 头部
    responseHeaders.delete("Transfer-Encoding");
    responseHeaders.delete("Connection");
    responseHeaders.delete("Keep-Alive");
    responseHeaders.delete("Proxy-Authenticate");
    responseHeaders.delete("Proxy-Authorization");
    responseHeaders.delete("TE");
    responseHeaders.delete("Trailers");
    responseHeaders.delete("Upgrade");

    // 为代理响应添加/确保我们自己的安全头部
    responseHeaders.set('X-Content-Type-Options', 'nosniff');
    responseHeaders.set('X-Frame-Options', 'DENY');
    responseHeaders.set('Referrer-Policy', 'no-referrer');

    return new Response(proxyRes.body, {
      status: proxyRes.status,
      statusText: proxyRes.statusText,
      headers: responseHeaders,
    });

  } catch (error) {
    console.error(`[${new Date().toISOString()}] 请求目标URL时出错 ${finalTargetUrl.toString()}:`, error);
    return new Response("网关错误: 连接上游服务器时出错。", {
      status: 502,
      headers: createSecureHeaders('text/plain')
    });
  }

}, { port });

</code></pre>
<h3><strong>部署步骤</strong></h3>
<p>部署过程非常简单，且完全免费：</p>
<ol>
<li>访问 <code>https://dash.deno.com</code> 并使用 GitHub 账号登录。</li>
<li>点击 <strong>New Playground</strong>，将完整的代理代码粘贴进去。</li>
<li>点击 <strong>Save &amp; Deploy</strong>。部署完成后，Deno会提供一个格式为 <code>https://[project-name].deno.dev</code> 的公开域名。</li>
</ol>
<h3><strong>如何使用</strong></h3>
<p>假设你获得的域名是 <code>https://my-proxy.deno.dev</code>。</p>
<p>现在，在你使用的任何WebDAV客户端中，将服务器地址从：
<code>https://app.koofr.net</code> 替换为 <code>https://my-proxy.deno.dev/koofr</code></p>
<p>例如，完整的WebDAV访问URL将从 <code>https://app.koofr.net/dav/Koofr</code> 变为 <code>https://my-proxy.deno.dev/koofr/dav/Koofr</code>。</p>
<p>配置完成后，Koofr的WebDAV访问速度得到了质的提升，文件同步恢复了应有的流畅。</p>
<h3><strong>总结</strong></h3>
<p>最终，这个 “<strong>Koofr + Deno</strong>” 的组合方案，让我以零成本的方式，获得了一个兼具<strong>高可靠性、隐私保护和高速访问</strong>的个人WebDAV服务。
Deno肯定会积极维护自己的Playground，谷歌云的SLA也很不错，即使这两个挂了，我们还是可以使用Koofr自己本身的链接进行不那么高速的同步，只有Koofr自己挂了才可能无法同步，健壮性应该是比自建Alist作为webdav方案要强很多</p>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2025-06-12T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[B站播放优化——禁用PCDN]]></title>
        <id>https://lainbo.dev/posts/bilibili-play-optimization/</id>
        <link href="https://lainbo.dev/posts/bilibili-play-optimization/"/>
        <updated>2025-01-07T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[千兆宽带看 B 站还卡顿，试试禁用 PCDN]]></summary>
        <content type="html"><![CDATA[<p><img src="https://lainbo.dev/_astro/bilibili-play-optimization.Be3oy-kc_Z27WFVq.webp" alt="" /></p>
<p>最近突然意识到，为什么自己的千兆宽带，播放B站都会卡顿，尤其是一些小up主上传的高清素材，拖动进度条播放的体验非常差，经过一些搜索才发现，原来是被分配到了比较差的cdn导致的。</p>
<h2>先放结论</h2>
<p>不论用什么方法，代理软件的分流也好，Adguard也好，软件无所谓，用任何你熟悉的方式，屏蔽以下3个域名后缀</p>
<pre><code>mcdn.bilivideo.com
mcdn.bilivideo.cn
szbdyd.com

</code></pre>
<p>比如</p>
<pre><code>// Clash
DOMAIN-SUFFIX,mcdn.bilivideo.com
DOMAIN-SUFFIX,mcdn.bilivideo.cn
DOMAIN-SUFFIX,szbdyd.com

</code></pre>
<pre><code>// adguard
||*pcdn*.biliapi.net^$important
||mcdn.bilivideo.com^$important
||mcdn.bilivideo.cn^$important
||szbdyd.com^$important

</code></pre>
<h2>原因解释</h2>
<p>B站的服务商 CDN有这几种，在PC网页端我们可以在视频中右键-&gt;视频统计信息，可以看到我们当前的视频使用的CDN信息</p>
<p><img src="https://i0.hdslb.com/bfs/article/1843ae33293405852e9be59be2768ea830109107.png" alt="" /></p>
<ol>
<li><code>upos-sz-mirror****.bilivideo.com</code>，看域名应该是服务商方案，质量好
<ul>
<li>腾讯：cos,cosb,coso1,coso2,bos</li>
<li>金山：ks3,ks3b,ks3c,ks32</li>
<li>七牛：kodo,kodob</li>
<li>华为：hw,hwb,uphw,js</li>
<li>阿卡迈（海外）：akamai</li>
</ul>
</li>
<li>自建 CDN (?)，质量尚可
<code>cn-****-dx-v-**.bilivideo.com</code>，可能是 B 站的自建服务器其中可以看到省份和城市首字母缩写</li>
<li>MCDN，质量差，P2P 节点，B站为了省钱搞的
<code>xxxxx(ip地址).mcdn.bilivideo.comxy99x999x99x99xy.mcdn.bilivideo.cn</code>
查了一圈只在京东云发现了 <a href="https://docs.jdcloud.com/cn/mcdn/product-overview">MCDN</a>，可能是京东云无线宝相关？也可能是京东云+无线宝相互配合？
怀疑 MCDN 包含无线宝的原因是 IP 段为家宽段</li>
<li>PCDN，质量极差，P2P 节点，B站为了省钱搞的
<code>*******.v1d.szbdyd.com</code>
到这就完全看脸了，各个地区上行带宽不可控，你连接到的节点与你的距离不可控，极端环境下甚至无法顺利播放 1080+</li>
</ol>
<p>我们要做的就是屏蔽掉那些质量很差的CDN，让B站误以为我们连不上这些CDN，从而去连接高质量的CDN（对于B站来说更贵的流量费用）</p>
<p><img src="https://i0.hdslb.com/bfs/article/edf37a5f548191f8b29317e1e4b8c58330109107.png" alt="" /></p>
<h2>参考资料</h2>
<ol>
<li><a href="https://www.v2ex.com/t/830394#r_11310794">话说我宽带网速都有挺好 有 1000M，但为啥用 Chrome 系浏览器看 B 站经常缓冲不过来？ - V2EX</a></li>
<li><a href="https://v2ex.com/t/834673">怎么能让 B 站 CDN 不分发 mcdn.bilivideo.cn 节点呢？ - V2EX</a></li>
<li><a href="https://github.com/xiaye13579/BBLL/issues/654#issuecomment-2203501383">能关掉万恶的PCDN和MCDN吗? · Issue #654 · xiaye13579/BBLL</a></li>
</ol>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2025-01-07T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[中银香港汇丰办卡开户行程及攻略]]></title>
        <id>https://lainbo.dev/posts/apply-hong-kong-bank-card/</id>
        <link href="https://lainbo.dev/posts/apply-hong-kong-bank-card/"/>
        <updated>2024-10-31T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[去香港开汇丰和中银香港账户的完整攻略，从准备材料到实地办理]]></summary>
        <content type="html"><![CDATA[<p><img src="https://lainbo.dev/_astro/apply-hong-kong-bank-card.BCtQCBbj_1dsKal.webp" alt="" /></p>
<p>以下为线下教程，现在越来越多的开户转到线上App，本文仅做记录当时线下开户流程</p>
<h2>为什么要去香港银行开户？</h2>
<p>去香港开户最大的好处莫过于资产自由。香港没有外汇管制，是自由港，这意味着全世界所有的货币都可以在香港自由地流通和兑换，千里之行始于香港，「有没有」比「好不好」更重要。</p>
<h2>我带了什么</h2>
<ol>
<li>
<p>地址证明：招商银行信用卡账单作为地址证明，使用「掌上生活」App获取，要最近一个月的。</p>
<blockquote>
<p>获取方式如下</p>
<p><img src="https://i0.hdslb.com/bfs/article/03663951c5e1a542150f73af2280565230109107.png" alt="" /></p>
</blockquote>
</li>
<li>
<p>投资经验证明：支付宝出具的2份材料作为投资经验证明，使用「支付宝」App获取，点开最后一步后，支付宝有2栏，分别是资产证明 和 交易明细，这2个都要。</p>
<blockquote>
<p>我是因为真的没有买股票，所以我用的支付宝的资料，按理说券商的投资月结单是更稳妥的选择，但要确保这个单据上面的信息，能证明这是你投资的（比如身份证号、姓名），支付宝的单据上面有姓名和身份证号，还有骑缝章，挺正规</p>
<p><img src="https://i0.hdslb.com/bfs/article/6bb6d81ccf5941725e8b7eafa282cfbe30109107.png" alt="" /></p>
</blockquote>
</li>
<li>
<p>纳税记录：用于证明收入来源，使用「个人所得税」App获取，时间范围选一年即可。</p>
<blockquote>
<p>获取方式如下</p>
<p><img src="https://i0.hdslb.com/bfs/article/52a3673c290a8032a349df12ba67a9b130109107.jpg" alt="" /></p>
</blockquote>
</li>
<li>
<p>工资卡银行的工资流水：找自己工资卡的银行打印一下工资部分的流水即可，用于证明收入的合法性。</p>
</li>
<li>
<p>港币现金，汇丰没有要求存多少金额，只是要求存一些进去，中银香港要求存1000港币。</p>
</li>
<li>
<p>身份证、港澳通行证。</p>
</li>
<li>
<p>入境小票：入境香港时，闸机/人工 会给你一个小白票</p>
</li>
<li>
<p>一个确保能在香港收到短信的手机和手机卡，最简单有效的方式，打你的运营商人工客服，给他说你要到境外旅游，确认一下自己这个手机号能否在境外收到短信，他就会帮你确认国际漫游这些服务是否开启。如果你到了香港（比较里面的地方，不是刚进口岸）发现自己的通信好像不正常，首先尝试重启手机，重启无果找个商场/店铺/银行蹭一下wifi，通过网络联系自己运营商的在线客服解决。</p>
</li>
</ol>
<h2>预约</h2>
<p>除非你一大早银行还没开门就站那里等，否则一定要预约，预约成功代表你在这个时间点的前后15分钟，共30分钟的时间段内，有着很高的服务优先级，基本上是只要没人约在你前面，那下一个一定就是你。</p>
<p>我本次前往银行，专门注意了一些walk in前往的人需要等待的时间。</p>
<p>汇丰银行11:00的时候，有人取了号，大堂经理告诉他你这个号最快可能需要等待3小时</p>
<p>中银香港13:32的时候，我去手动取了个号，取到了90号，当前叫号叫到30+号</p>
<p>所以一定要预约</p>
<h2>分行选择</h2>
<p>汇丰：元朗分行</p>
<blockquote>
<p>预约链接
由于汇丰是提前30天可以预约，一定要先约汇丰，基于汇丰的预约日期去约中银香港</p>
</blockquote>
<hr />
<p>中银香港：元朗青山道分行</p>
<blockquote>
<p>预约链接
提前7天可以预约
中银香港抢号的方案：用网页版预约，而不是小程序，提前2分钟进入预约界面（不能提前多了，如果提前很久打开网页，最后提交可能会失败，再重新填写信息大概率无法选到你想要的时间）</p>
<ol>
<li>
<p>先选好证件类型，点「继续」跳转到信息填写页面，填好上面的基本信息（建议在23:59完成这一步）</p>
</li>
<li>
<p>在00:00之前，下面的预约日期、预约时间、分行区域那些都是没法选择的，因为他们可能都被预约完了，我们要在00:00之后立刻去抢下一天的号，可以通过在00:00后来回切换下图的选项，来刷新出新一天的号，而不是刷新网页，刷新网页就慢了。（给程序员：下方select的数据，是上方这个radio在change的时候获取回来的，确保00:00之后change一下让他发起新一天的请求，你就能最快的选到后一天的预约了）</p>
<p><img src="https://i0.hdslb.com/bfs/article/95b27550c788d6bf10ac594f369588b030109107.png" alt="" /></p>
</li>
</ol>
</blockquote>
<p>这两个银行就是马路对面的关系，距离很近</p>
<p><img src="https://i0.hdslb.com/bfs/article/9a52b81cb7b22140194a79acc01d47c230109107.png" alt="" /></p>
<p><strong>银行预约成功后的结果，截图保存在手机上，到时候出示给工作人员。尤其是汇丰的二维码，到了现场需要扫码</strong></p>
<h2>建议提前下载的App</h2>
<ol>
<li>HSBC HK Mobile Banking（汇丰的App）</li>
<li>BOCHK中银香港（中银香港的App）</li>
<li>BoC Pay（一个中银香港类似于支付宝的App，实际作用不大，但是银行要指导你使用）</li>
<li>ZA Bank（众安银行，一个虚拟银行，可以申请实体Visa卡，卡比较好看）</li>
<li>天星银行（一个虚拟银行，港币人民币的汇率很不错）</li>
<li>LongBridge（长桥，投资港股用的）</li>
<li>Citymapper（导航用的，出了口岸就可以开始用这个）</li>
<li>OpenRice（香港版大众点评）</li>
</ol>
<h2>行程</h2>
<p>本次行程过口岸后，大部分的导航都是「Citymapper」这个导航App负责的，界面有点糙但是很好用。</p>
<p>我们预约的是周五，预约的汇丰11:00，中银香港14:00。</p>
<p>这两个分行都在元朗，所以周四下午到了深圳，在口岸附近找了个地方住下，计划周五从深圳湾口岸前往。</p>
<p>周五上午我们从深圳湾口岸出发（高德导航记得选择深圳湾口岸的“出境”，我没点这个直接给我导航到人家办公楼去了XD）</p>
<p>跟着大部队走就进入到口岸内部，入境香港，把小白票装好，出来后就是公交站</p>
<p>我前往的方案是「B2P」-「屯马线」。B2P过关后的公交站很好找，15分钟一趟的双层巴士，B2P先坐1站到「天盛苑」，下车就是港铁的「天水围」站，港铁坐1站到「朗屏」下车，再步行去汇丰，这个过程我们花了32分钟左右。<em>但是如果是出行计算时间，我建议用最差情况去算，也就是说你就当自己倒霉到公交前脚刚走，你后脚到公交站，这种最差情况大约需要50分钟</em></p>
<p>「B2P」公交站的背面贴了一个微信的乘车码小程序二维码，可以扫一下就用这个乘车（不是境内的「乘车码」小程序，而是「搭車碼」小程序），如果你想提前开通好，把这一段文字在微信里发给你的文件传输助手，然后点击，也能打开。 #小程序://搭車碼/1u3lyPjD4fLSzst</p>
<p><img src="https://i0.hdslb.com/bfs/article/393e94405fe40c186172cbccbf3d811730109107.png" alt="" /></p>
<p>香港公交你需要手动按铃司机才知道你要下车，不按铃他不会主动停车，但是B2P第一站一定会有一大堆人要下车，所以这点倒不用担心。</p>
<p><img src="https://i0.hdslb.com/bfs/article/42d94a71c58732b7f239ff246acf8f5d30109107.png" alt="" /></p>
<p>到了汇丰，发现时间还早，工作人员看了我们11:00的预约，让你们10:45过来扫二维码取号（他扫你，扫的是预约时截图保存的二维码），坐着等待的过程中，连上银行的wifi，把ZA Bank和天星办了，刚好检测了一下自己手机卡接受短信是否正常</p>
<p>这里有个小坑，就是ZA Bank、天星这样的，他需要定位在香港才能开，有小伙伴反馈如果去的分行在香港的地理位置比较偏（比如天水围），是开不了的，得往香港中间走走才行。我们选择的这两个分行没有这样的问题。</p>
<p>上午办完卡，在OpenRice（香港版大众点评）找了个叫做巨昇冰室的地方吃了顿饭，吃好后坐了一会儿继续去中银香港办卡</p>
<p>到了中银香港，时间也还算早，我记得是13:32，里面都是人，我还尝试去取了个号，90号，当时才叫到30+号，暗自庆幸我们预约了。问了一下工作人员，表示自己在网上预约了14:00的开户，工作人员找了一下文件问到“xxx是吧”，我说是，“那行你扫一下这个二维码，填一下信息”，这就其实已经开始开户了，填完信息后把我转交给另一个同事，她来完成后续的工作，中银香港问的问题就多很多了，详细开户过程会在后面写。</p>
<p>关键的办卡行程其实到这里就结束了，有预约的情况下半天就够，两个银行的预约中间留够时间间隔，免得因为第一个银行办理过久，耽误了第二个银行的办理，过号5个就失去优先权了。</p>
<h2>汇丰办卡过程</h2>
<p>预约的二维码扫过后，会有粤语叫号，还好我朋友会粤语，把我推进了那个指定的办理房间，如果你不懂粤语，请紧盯电子叫号的牌子。</p>
<p>开始开户，开户过程的问的问题，取决于负责你的那个工作人员</p>
<p>“身份证件出示一下”——我：（掏出身份证，港澳通行证，小白票）</p>
<p>“开户用来做什么”——我：“准备用来投资港股”</p>
<p>“给我一下你的地址”——我：（掏地址证明）——“不用不用，你给我说就行”</p>
<p>“你来做一下这个测试”——是一个类似投资人风险承受能力评估的问卷，既然要投资，肯定要选一些比较进取的选项，嘴上说着投资港股，实际上选的全是保本<strong>可不行</strong>。</p>
<p>然后就是一些个人信息，如实回答即可，比如工作单位，公司做什么的，你的岗位是什么</p>
<p>签了几个字</p>
<p>下卡</p>
<p>整个过程都是他在平板上操作，一共30多分钟，我一直盯着人家感觉不太好，就掏手机玩，整个过程比较丝滑，可能是我这个工作人员看到我直接掏了一大包材料出来懒得问了。但是朋友也是11:00的汇丰预约，感觉他那边没有那么好说话，<strong>他那边还问了“你准备买哪个港股”，“你准备投多少钱用来买股票？”</strong></p>
<p>汇丰的卡密码是会随机给你分配一个默认的，想要改密码需要第二天在ATM取款机上改（过晚上0:00就可以）</p>
<h2>中银香港办卡过程</h2>
<p>首先身份证、港澳通行证、小白票递给她</p>
<p>要了纸质地址证明，我先给了招商银行的信用卡账单<strong>纸质版本</strong>，她提出要看邮箱里的<strong>pdf版本</strong>，还核对了email的发件人是不是真的是招商银行，核对了pdf和纸质版是否完全一样。</p>
<p>看了纸质工资流水，个人所得税App申请的纳税证明，确认了我的工作信息（其实她也没有要这个证明，一般情况下口述即可，我求稳就用这两个材料来证明了）</p>
<p>“有没有股票交易经验”——“没有股票的交易经验，支付宝上买过基金，这里是支付宝开具的相关证明”（递上面说的2个支付宝生成的材料，我支付宝上定投的基金，所以流水很多，她也看的很认真）</p>
<p>“为什么要选港股”——“我选港股不是因为最近的几次大涨（证明自己不是想投机而是想投资），而是因为我看好港股的xxxxx（不好写出来，自行发挥，总之就是夸）”</p>
<p>“你打算怎么买港股”——“我之前了解到有长桥可以买，刚下载还没注册，如果能顺利下卡，也会去了解一下咱们银行App怎么去操作这些，看哪一个更方便使用”</p>
<p>“月收入多少？婚否？总资产是否超过36万？”（朋友那边是直接问有多少资产，不过我们都没有被验资）</p>
<p>一些个人信息问题问完之后就下卡了，又转交给了另一个员工，教我使用中银的App —— BOCHK中银香港 和 BoC Pay。</p>
<p>下卡后，会给一个单据，这个单据上有卡号，需要去ATM上先存钱，第一次存钱<strong>只能手动输入号码来存</strong>，插卡是不认的，我存了1000港币进去。退卡</p>
<p>然后要等一会儿，我们去附近上了个厕所再回来取款机前面，插卡-查询余额-退卡，这才完成了整个流程。为什么要去上厕所，因为存了之后立刻去查，卡是不认的，可能他后台需要时间来更新一下吧，中间大概等个3、5分钟就可以了</p>
<h2>ZA Bank、天星、汇丰蓝狮子、长桥</h2>
<p>ZA Bank和天星是定位在香港，才可以开户，需要在香港的核心区域才能开。</p>
<blockquote>
<p>核心区域如下</p>
<p><img src="https://i0.hdslb.com/bfs/article/d007a470b091d66a2843b51aa3d24b0730109107.jpg" alt="" /></p>
</blockquote>
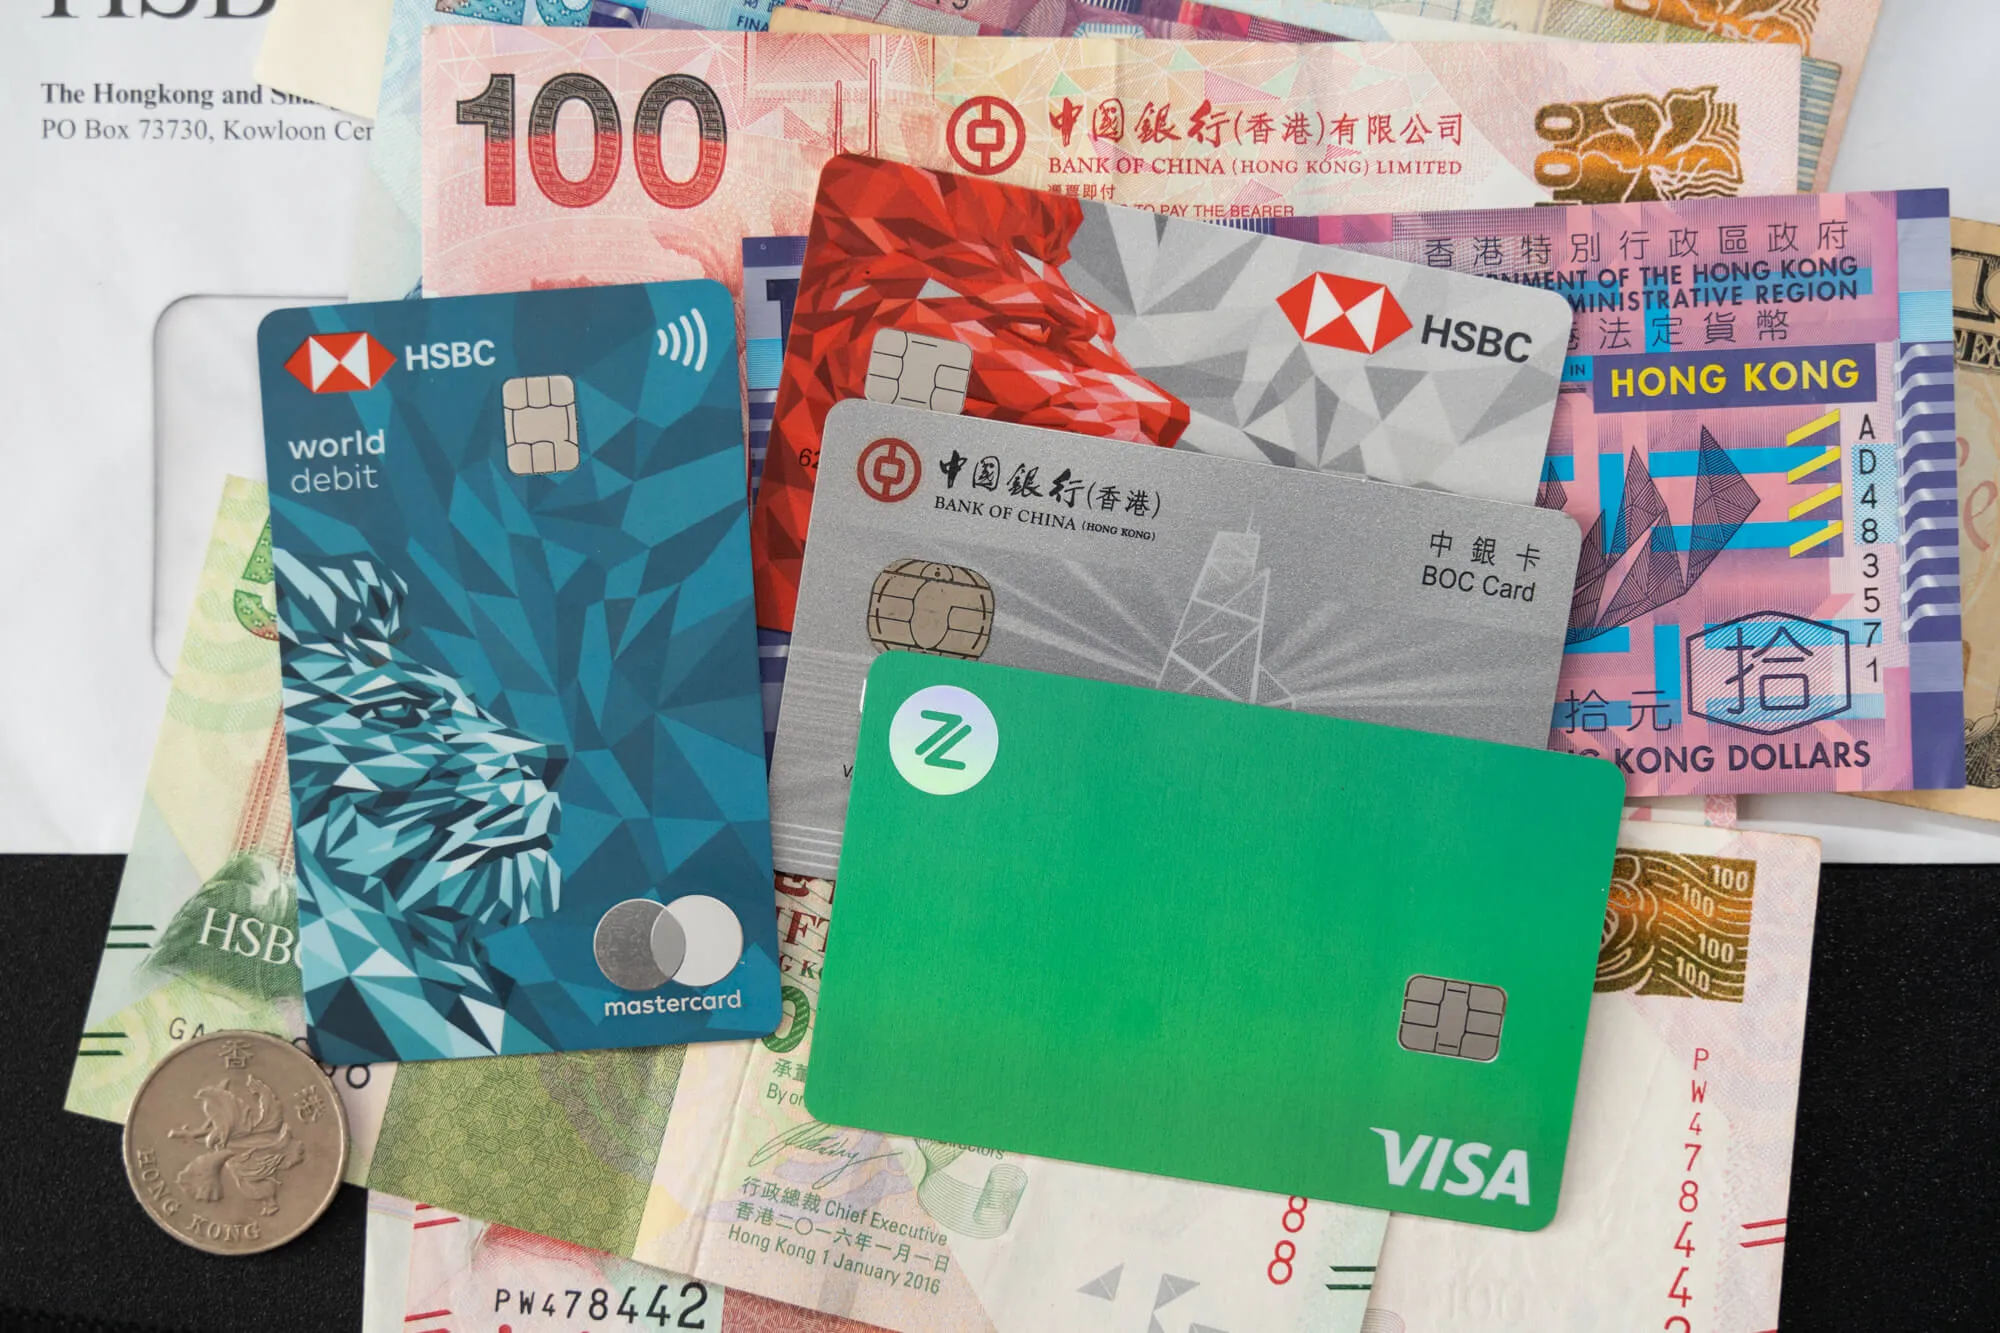
<p>ZA Bank是纯为了他的卡，比较好看，需要审核通过后自己在App申请，需要支付35港币的邮费，珠海发货，是一张Visa扣账卡（算是补齐一下香港Visa卡吧）</p>
<p>天星银行是港币人民币的汇率比较好的银行，小米旗下的，可以作为一个中转的地方，只有账户没有卡（境内我们都是银行卡就是账户号，香港账户号是账户号，卡号是卡号，分离的）</p>
<p>汇丰蓝狮子是一张汇丰的万事达扣账卡，用来消费的，我们申请下来的汇丰红狮子卡是不好网上消费的，因为他没有CVV，这张蓝狮子在你拥有红狮子后，可以在App中无门槛直接申请（App首页 - 借记卡 - 第一张蓝狮子 - 申请），EMS特快从深圳发货，有这张卡就能更方便的网上购物使用了，消费时扣的是你账户里的钱。</p>
<p>如果需要投资港美股，现在更推荐盈透，一个成立了40多年的美国券商，各项费率比那些充斥着aff的长桥、富途、老虎更好，全套中国身份即可开户，回家找个教程慢慢开即可，不用人在香港。</p>
<h2>一个提示</h2>
<p>如果中银香港让你选「自在理财」还是「智盈理财」账户，请选后者智盈理财，选这个还可以在App上申请一张万事达的扣账卡，比蓝狮子好用</p>
<p>借用一下罗磊博客中的图，最后我们会办理下来这些卡</p>
<p><img src="https://i0.hdslb.com/bfs/article/c098fa953993cad958d1ae4855f29db130109107.png" alt="" /></p>
<p>希望对你有帮助。</p>
<h2>参考资料</h2>
<ol>
<li><a href="https://gapis.money/blogs/hk-bank-cards-guide">出海人去香港办银行卡最全攻略| 信息差</a></li>
<li><a href="https://luolei.org/how-to-open-a-bank-account-in-hongkong-2024">香港银行开户：2024 年更新 | 中银、汇丰、众安开户经验分享 | 罗磊的独立博客</a></li>
<li><a href="https://iwanlab.com/trip-to-hong-kong-for-opening-bank-accounts/">【经验分享】还算顺利的香港开卡之旅——中银香港、汇丰香港、招商永隆、ZA Bank及其他虚拟银行 - 咕咕鸽</a></li>
<li><a href="https://dr.leviding.com/docs/finance/open-a-bank-account-boc-hk">中银香港 | 数字居民社区</a></li>
<li><a href="https://www.hsbc.com.hk/content/dam/hsbc/hk/docs/accounts/applyaccount-note-sc.pdf">汇丰香港地址证明要求</a></li>
<li><a href="https://www.bochk.com/dam/bochk/desktop/interface/AC_Open_sc.pdf">中银香港地址证明要求</a></li>
</ol>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2024-10-31T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[你的优化线路服务器是大小包吗？]]></title>
        <id>https://lainbo.dev/posts/fake-network-routing/</id>
        <link href="https://lainbo.dev/posts/fake-network-routing/"/>
        <updated>2024-09-21T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[选境外服务器时，如何识破商家测试 IP 的大小包把戏]]></summary>
        <content type="html"><![CDATA[<p><img src="https://lainbo.dev/_astro/fake-network-routing.CZ_fH0Eh_Z15fvR4.webp" alt="" /></p>
<p>在选择服务器时，一些商家会宣称自己有多么多么好的线路，晚高峰稳定之类的，并且给出一个优秀的24小时延迟测试图，然而这真的靠谱吗？</p>
<p><img src="https://i0.hdslb.com/bfs/article/00a4eec9c66859cb6a64edc21cbcbc7e30109107.png" alt="" /></p>
<h2>什么是"大小包"？</h2>
<p>"大小包"指的是一些VPS服务商根据数据包大小采用不同的网络路由策略：</p>
<ul>
<li>小包：通常走优化过的路由，这也是服务商常常宣传的线路。</li>
<li>大包：可能会走未经优化的路由，导致性能下降，但是服务商成本低。</li>
</ul>
<p>用个更通俗的方式解释
MTU简单说就是一辆卡车的大小，你数据包相当于包裹，卡车大自然可以装大包裹，卡车小我也可以把大包裹拆分成小包裹发，只是效率低一些而已</p>
<p>但是现在商家，给你小包裹走高速路，大包裹走土路，你ping测路由都是小包裹，你以为是走高速，等你买来真正开始使用，才发现走是土路</p>
<h3>一个走「土路」的香港服务器路由示意图</h3>
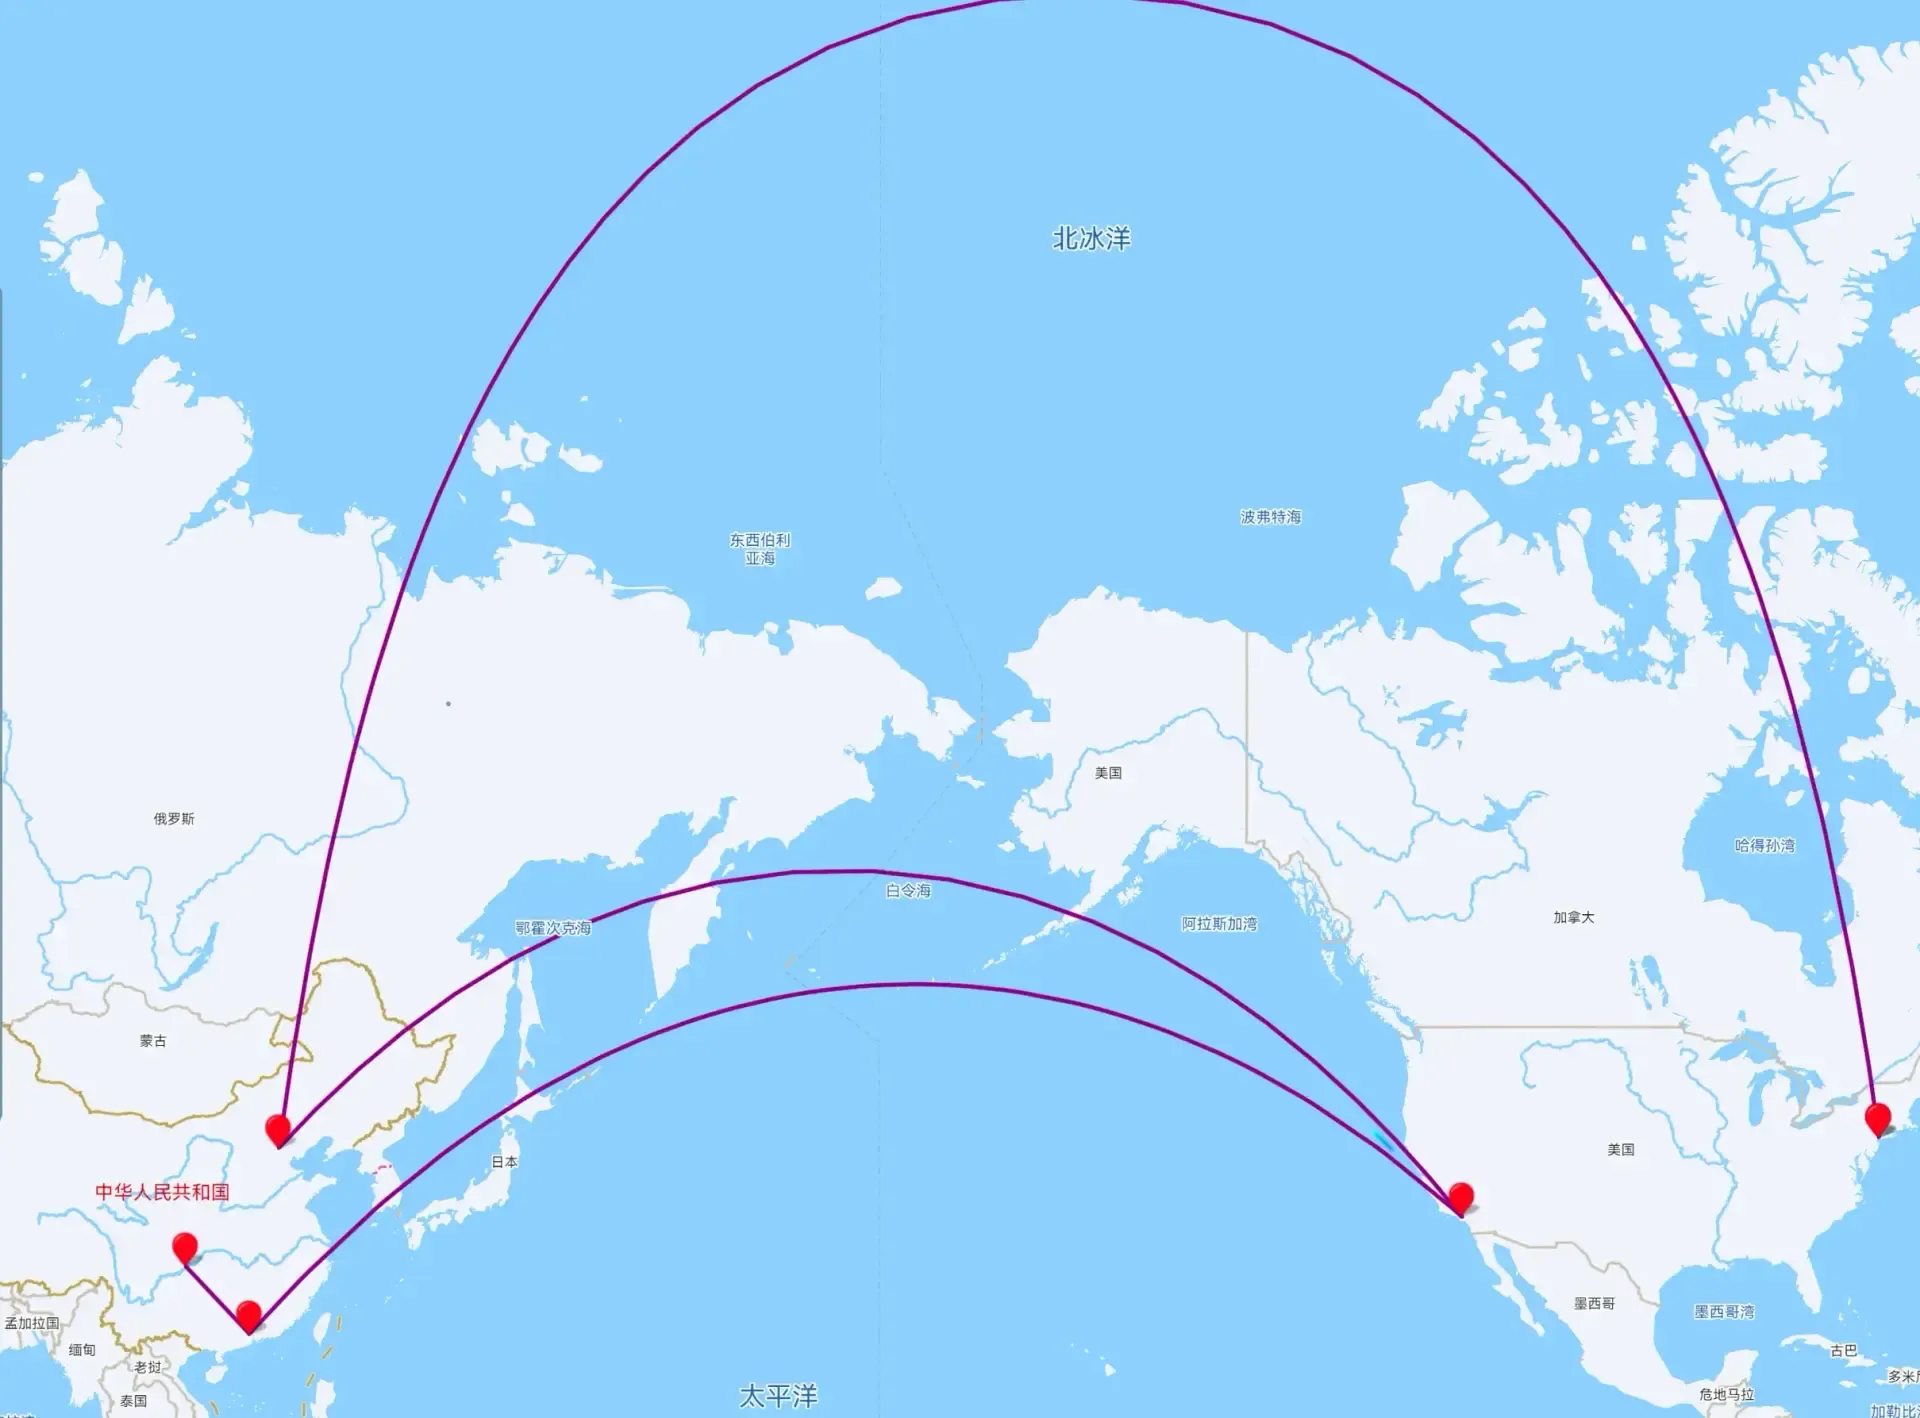
<p>去香港明明可以广州出口直连香港，他硬是往美国跑了一圈</p>
<p><img src="https://i0.hdslb.com/bfs/article/58e116ae93d0b38699d7914f2d6c404430109107.png" alt="" /></p>
<h3>一个走「高速路」的香港服务器国际路由示意图</h3>
<p>直接广州出口连香港，没有任何绕路</p>
<p><img src="https://i0.hdslb.com/bfs/article/4317639c84d3f0390a8741821a72624530109107.png" alt="" /></p>
<h2>为什么ping测试可能具有欺骗性</h2>
<p>大小包的服务商会在你传输小数据包（ping服务器）的时候，让你直连走上面的高速路，一开始正式使用（正常使用往往都是大包），就让你走土路。如果服务商黑心，你去ping是ping不出来实际体验的</p>
<h2>如何检测大小包</h2>
<p>我们可以使用<a href="https://github.com/nxtrace/NTrace-core">nexttrace工具</a>来检测VPS是否存在大小包路由问题。以下是具体步骤：</p>
<ol>
<li>
<p>安装nexttrace：</p>
<pre><code>curl nxtrace.org/nt | bash
</code></pre>
</li>
<li>
<p>运行测试命令：</p>
<pre><code>nexttrace --tcp --psize 12 202.96.209.133:80 &amp;&amp; nexttrace --tcp --psize 1452 202.96.209.133:80
</code></pre>
<p>这个命令会向位于上海电信的IP地址发送两次测试：</p>
<ul>
<li>第一次发送12KB的小包</li>
<li>第二次发送1452KB的大包</li>
</ul>
</li>
<li>
<p>比较两次输出结果，观察路由是否相同。<strong>如果路由不同，那么很可能存在大小包问题</strong></p>
</li>
</ol>
<h2>注意事项</h2>
<p>提一下打包为什么是1452KB这个数字，因为过于大的包体积可能超过超过了以太网帧的体积。可以看看网卡的MTU，用过大的包没有意义，数据包会被切片的。</p>
<p>1452字节的包大小，这是考虑了各种网络协议开销后的比较合适的选择：</p>
<pre><code>1452字节 = 1518(以太网帧大小)-18字节(帧头尾)-8字节(可能存在的拨号信息)-20字节(IP信息)-20字节(TCP协议头)

</code></pre>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2024-09-21T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Obsidian使用Cloudflare R2（S3兼容）在多个设备同步]]></title>
        <id>https://lainbo.dev/posts/obsidian-cloudflare-r2-sync/</id>
        <link href="https://lainbo.dev/posts/obsidian-cloudflare-r2-sync/"/>
        <updated>2024-09-09T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[用 Cloudflare R2 的免费额度和 Remotely Save 多端同步 Obsidian]]></summary>
        <content type="html"><![CDATA[<p><img src="https://lainbo.dev/_astro/obsidian-cloudflare-r2-sync.BaJe7OGM_uyjfR.webp" alt="" /></p>
<p>Obsidian作为一款强大的笔记软件，深受知识工作者的喜爱。然而，其官方的Sync同步服务价格不菲，年费最低也要48美元。对于预算有限的用户来说，这可能是一笔不小的开支。</p>
<p>有一个更经济实惠的替代方案：结合Cloudflare的R2存储服务和Obsidian的Remotely Save插件。R2是一个兼容S3的对象存储服务，其免费额度足够个人使用。R2有10GB的存储空间，外加每月100万次A类操作和1000万次B类操作，数据传出完全免费。这意味着对于大多数Obsidian用户来说，同步笔记可能完全不需要花费任何费用。</p>
<h2>价格</h2>
<h3>Obsidian官方价格</h3>
<table>
<thead>
<tr>
<th>功能</th>
<th>Sync 标准版</th>
<th>Sync 高级版</th>
</tr>
</thead>
<tbody>
<tr>
<td>价格</td>
<td>4美元/月，按年计费</td>
<td>8美元/月，按年计费</td>
</tr>
<tr>
<td>仓库数量</td>
<td>1个</td>
<td>10个</td>
</tr>
<tr>
<td>总存储空间</td>
<td>1GB</td>
<td>10GB</td>
</tr>
<tr>
<td>最大文件大小</td>
<td>5MB</td>
<td>200MB</td>
</tr>
<tr>
<td>历史记录</td>
<td>1个月</td>
<td>12个月</td>
</tr>
<tr>
<td>设备数量</td>
<td>无限</td>
<td>无限</td>
</tr>
<tr>
<td>共享仓库</td>
<td>支持</td>
<td>支持</td>
</tr>
</tbody>
</table>
<h3>Cloudflare免费额度价格</h3>
<table>
<thead>
<tr>
<th></th>
<th>免费</th>
</tr>
</thead>
<tbody>
<tr>
<td>总存储空间</td>
<td>10 GB / 月</td>
</tr>
<tr>
<td>A类操作</td>
<td>100万次 / 月</td>
</tr>
<tr>
<td>B类操作</td>
<td>1000万次 / 月</td>
</tr>
</tbody>
</table>
<p>对于Obsidian用户来说
A类操作：同步过程中的文件上传和修改数据
B类操作：下载和读取文件内容</p>
<h2>创建Cloudflare相关服务</h2>
<h3>1. 使用Cloudflare的前置条件</h3>
<ol>
<li>有一个Cloudflare账号</li>
<li>这个账号绑定了支付的卡片（中国境内的Visa、Master、AMEX经过测试都可以，银联借记卡不太清楚，可以尝试一下。如果银联借记卡不行，可以通过Cloudflare→绑PayPal→绑境内借记卡实现）</li>
</ol>
<h3>2. 申请Cloudflare的R2</h3>
<ol>
<li>打开 <a href="https://dash.cloudflare.com/?to=/:account/r2/new">https://dash.cloudflare.com/?to=/:account/r2/new</a></li>
<li>页面会要求你设置一个存储桶的名字，我这里输入了<code>obsidian-sync</code> （记住这个一会儿要用），你可以输入你想要的名字</li>
<li>下面的「位置」「默认存储类」保持默认</li>
<li>点击创建存储桶</li>
</ol>
<h3>3. 获取存储桶的服务地址</h3>
<ol>
<li>打开刚刚创建的存储桶的详情页，记得中间的存储桶名字换成你刚刚起的名字
https://dash.cloudflare.com/?to=/:account/r2/default/buckets/<code>这里换成你的存储桶名字</code>/settings</li>
<li>在这个页面找到「存储桶详细信息」-「S3 API」，你会找到一个形如
https://xxxxxxxxxxxxx.r2.cloudflarestorage.com/<code>你的存储桶名字</code> 的链接</li>
<li>复制这个链接，然后移除最后的名字部分
即：https://xxxxxxxxxxxxx.r2.cloudflarestorage.com 就是我们要的服务地址（记住这个一会儿要用）</li>
</ol>
<h3>4. 创建一个Cloudflare API Token</h3>
<ol>
<li>打开 <a href="https://dash.cloudflare.com/?to=/:account/r2/api-tokens/create">https://dash.cloudflare.com/?to=/:account/r2/api-tokens/create</a></li>
<li>这个页面上来会要求你起一个名字，名字随意，你能认出来就好</li>
<li>权限这里，选择「<strong>管理员读和写</strong>」，其他不变</li>
<li>点击创建 API 令牌</li>
<li>复制「访问密钥 ID」「机密访问密钥」（记住这个一会儿要用）</li>
</ol>
<h2>在Obsidian里面使用</h2>
<ol>
<li>
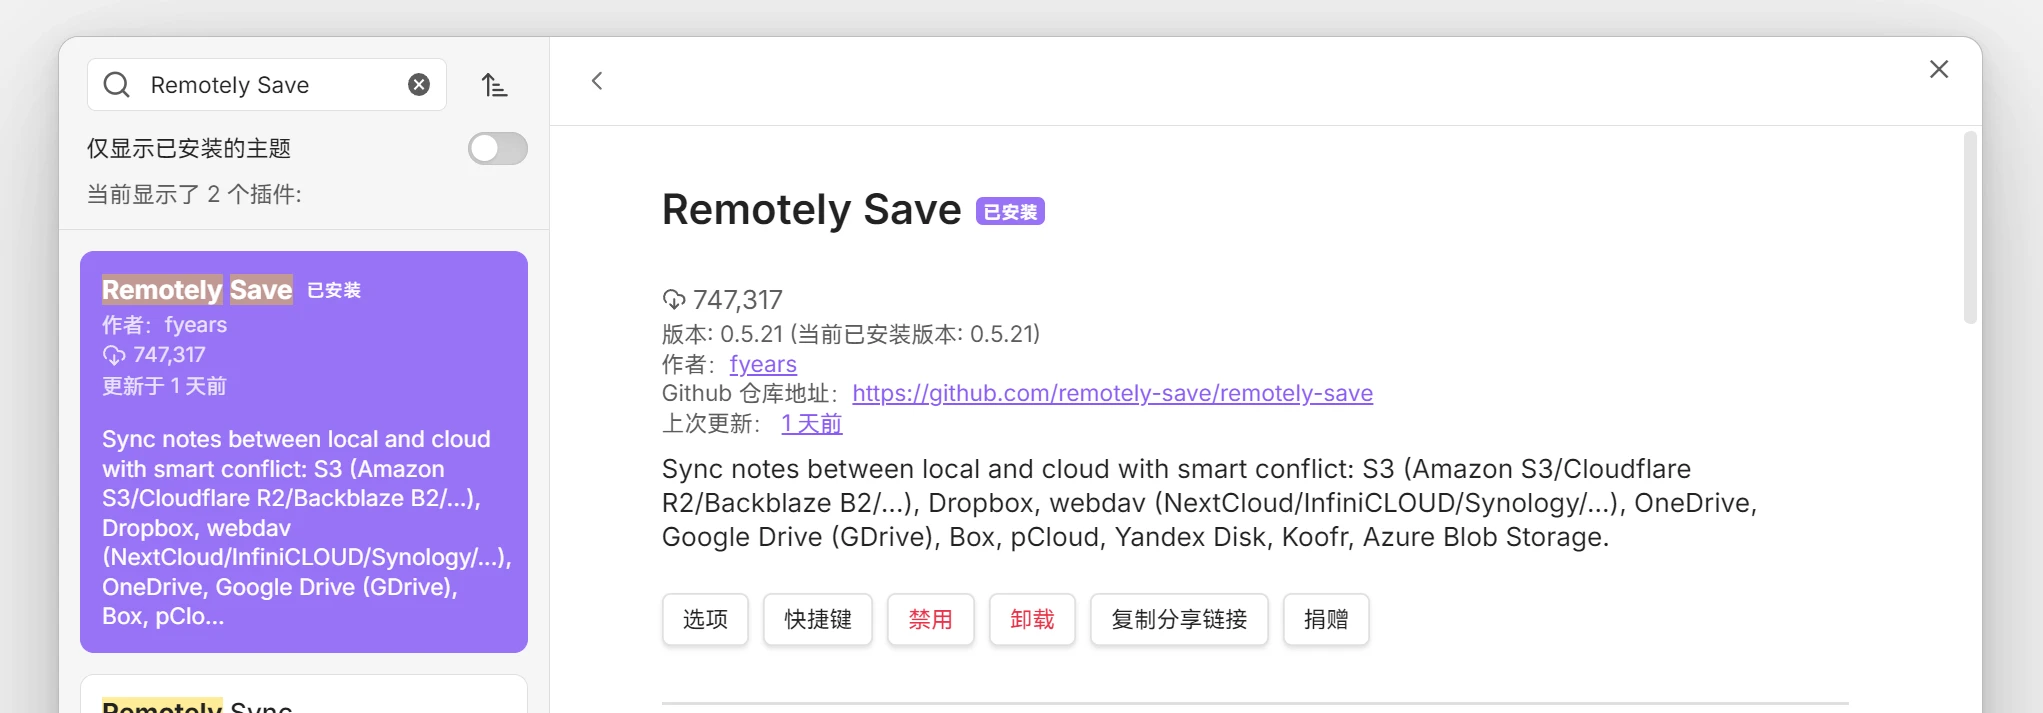
<p>下载安装并启用 Remotely Save 插件</p>
<p><img src="https://i0.hdslb.com/bfs/article/4a8ab23b66c5ed653633b3608dadf56430109107.png" alt="" /></p>
</li>
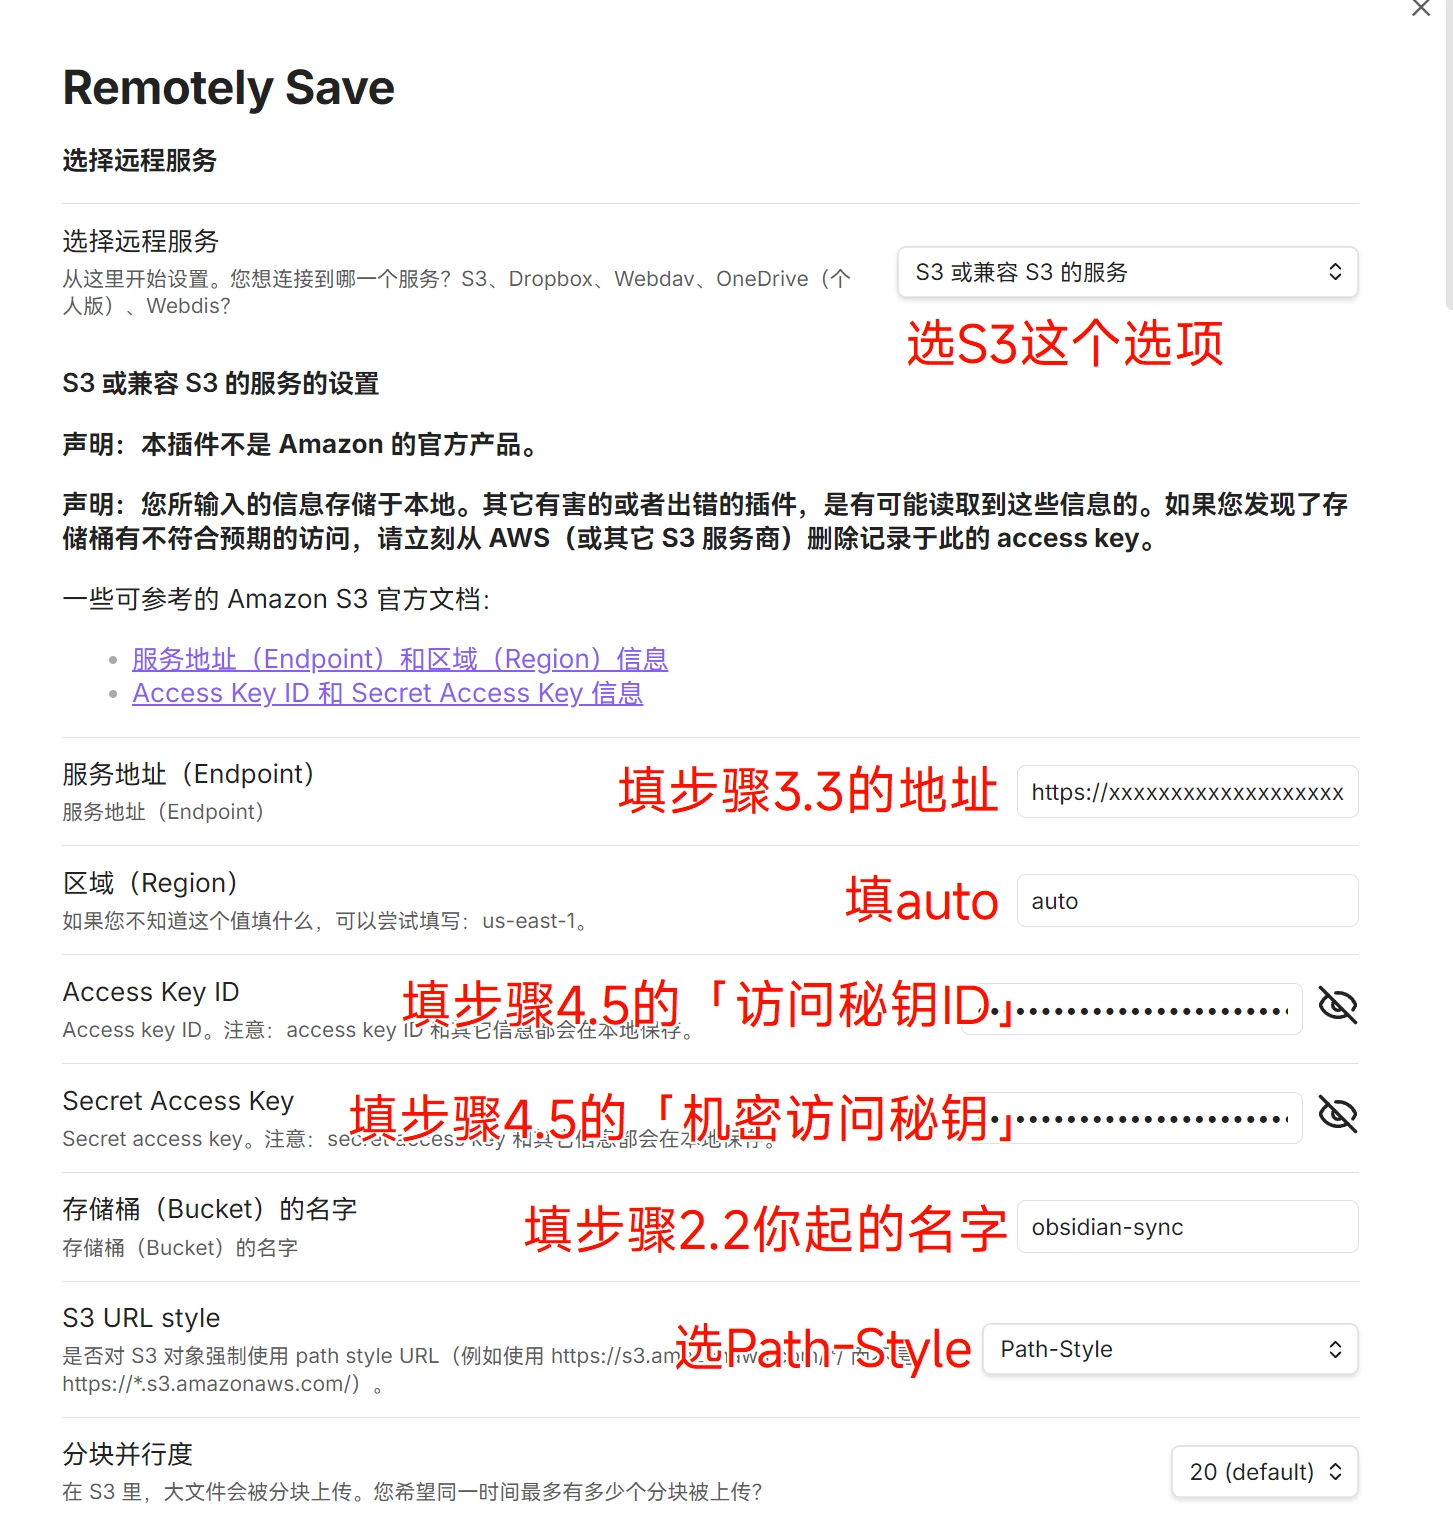
<li>
<p>按下图的方式填入，没有提到的保持默认</p>
<p><img src="https://i0.hdslb.com/bfs/article/fde33f79a8d1f21dc57d764a455dc9be30109107.png" alt="" /></p>
</li>
<li>
<p>PC和移动端的同步
移动端需要先安装并启动这个Remotely Save插件，<strong>Vaults的名字要和PC上完全一样</strong>
在手机上粘贴PC生成的链接，点确定即可</p>
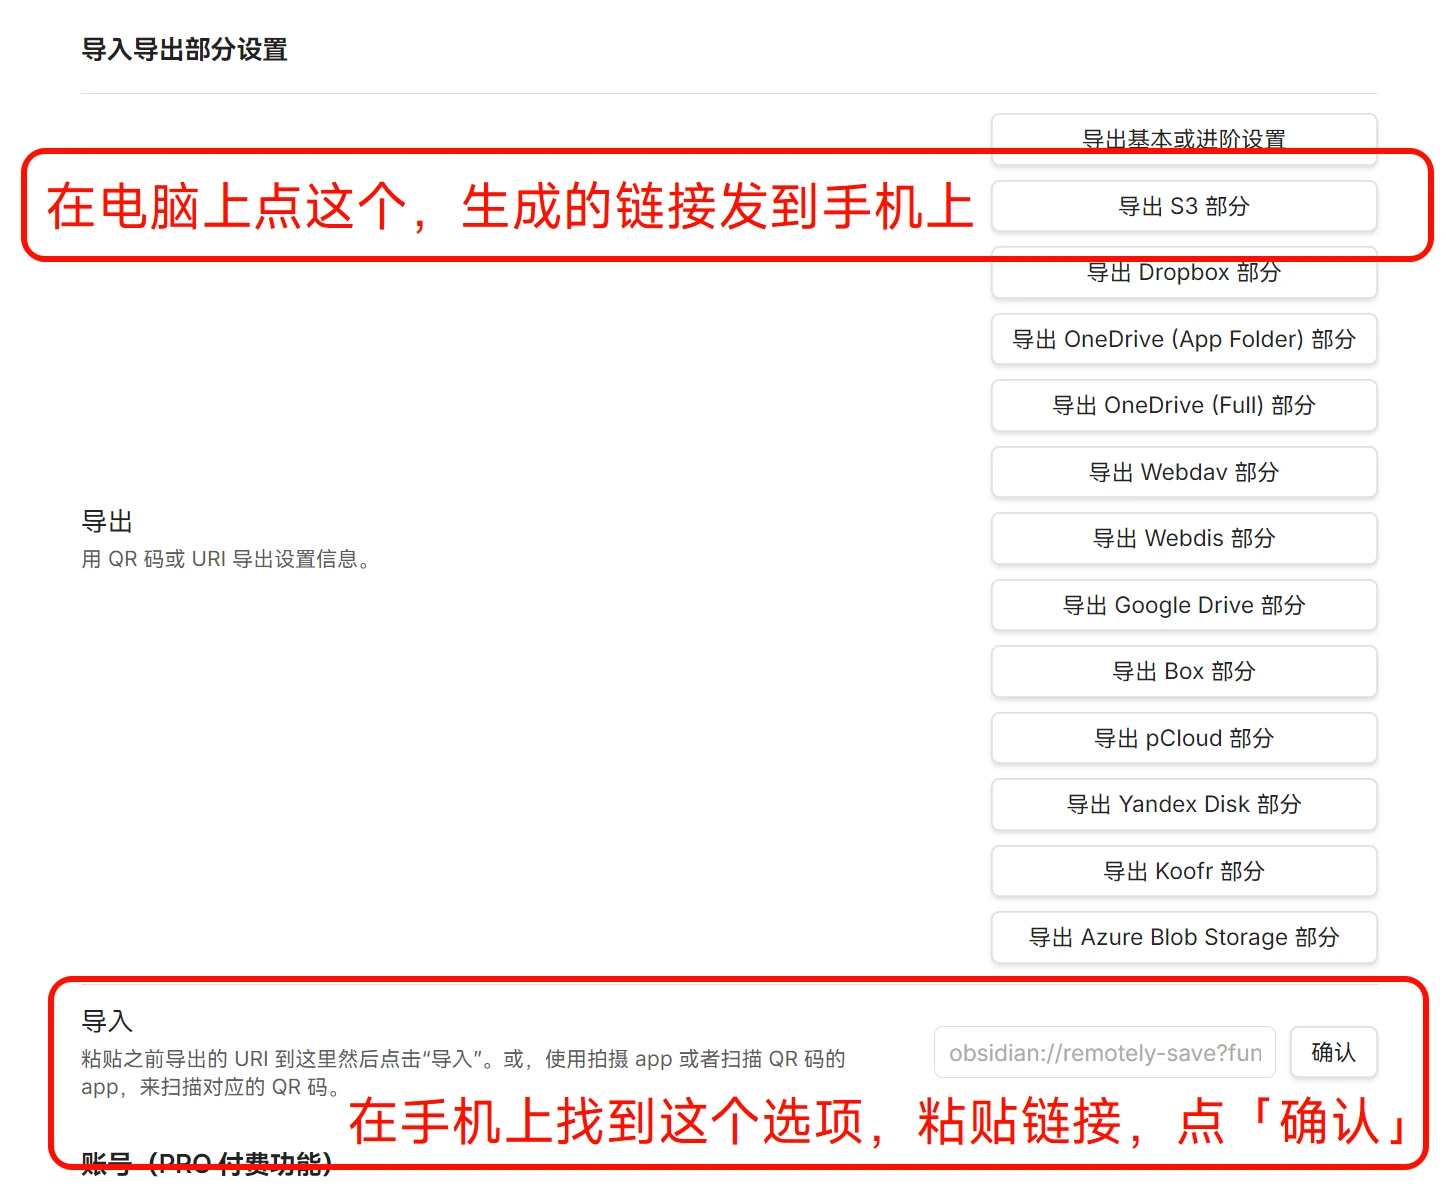
<p><img src="https://i0.hdslb.com/bfs/article/2cb5340cd5e4d0b46ce21050e22e4a4030109107.png" alt="" /></p>
</li>
</ol>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2024-09-09T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[《The Almanack of Naval Ravikant（纳尔瓦宝典）》TL;DR]]></title>
        <id>https://lainbo.dev/posts/summary-the-almanack-of-naval-ravikant/</id>
        <link href="https://lainbo.dev/posts/summary-the-almanack-of-naval-ravikant/"/>
        <updated>2024-09-02T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[《纳瓦尔宝典》的太长不看版，讲如何积累财富、获得幸福]]></summary>
        <content type="html"><![CDATA[<p><img src="https://lainbo.dev/_astro/summary-the-almanack-of-naval-ravikant.B5TnEebW_1yUv2X.webp" alt="" /></p>
<p>书籍信息：<a href="https://book.douban.com/subject/35876121/">豆瓣读书</a></p>
<h2>特定知识</h2>
<p>特定知识无法被传授，但可以通过学习获得。</p>
<p>它关乎什么使你成为独一无二的存在。想想那些你信手拈来，却让旁人刮目相看的本领，在"做你自己"这件事上，没人能与你匹敌。<strong>特定知识需要你去追寻内心真正的好奇和热情，而非盲从当下的热点趋势</strong>。</p>
<p>人生的大部分时光，都花在寻觅最需要你的人和事上。</p>
<h2>未来的工作与无限学习</h2>
<p>最好的工作，不是由他人指派，也不是凭学历获得。</p>
<p>它们是自由市场中永不止步的学习者创造性才智的结晶。要想获得财富，最重要的本领就是成为一个终身学习者。你必须掌握如何去学习任何你想要掌握的知识。</p>
<p>在当今时代，<strong>与其拘泥于过去所学的专业，不如在9到12个月内成为一个全新领域的专家</strong>，这更加重要。真正的关键是要打下扎实的基础，这样你就能勇于探索任何未知的领域。</p>
<h2>智慧的好奇心</h2>
<p>无论是工作、运动、恋爱还是友谊，做<strong>任何事情的意义都在于专注内在，全身心投入，享受过程本身</strong>，而非盲从外界标准。</p>
<p>任何有价值有意义的事业，都源于人性克服无聊、战胜自我的内在需求。因为那时，你是在为内心的理想和追求而孜孜以求，全情付出。这远比随波逐流，追逐表面的热点潮流更加重要和有意义。</p>
<h2>创办企业或收购股权</h2>
<p><strong>如果你不拥有企业的一部分，就无法踏上通往财务自由的道路</strong>。</p>
<p>问题的关键在于，你是拥有所有权，还是靠打工赚取薪水。如果你只是出卖时间来获取报酬，那么即使是律师和医生这样的高薪职业，也只能赚到一些钱，但无法积累到足以让你实现财务自由的财富。你不会拥有一个企业在你度假时仍在持续不断地为你赚钱的被动收入。</p>
<p>没有所有权，你的付出和回报就是紧密相连的。几乎所有的打工者，哪怕是时薪很高的律师和医生，都难以摆脱用时间换取金钱的怪圈。你工作一小时，就只能得到相应一小时的报酬。</p>
<h2>三种杠杆助你快速发展</h2>
<p>杠杆可以倍增你的判断力，它有三种形式可供选择：</p>
<ul>
<li>人力杠杆：让他人为你工作。这是最古老的杠杆方式，但在当今世界并不十分奏效，因为管理他人十分棘手费力。</li>
<li>金钱杠杆：金钱可以放大你每一次决策的效果。这是上个世纪财富积累的主要途径。</li>
<li>无边际复制成本产品杠杆：如书籍、媒体、电影和代码。代码可能是最强大的无需许可的杠杆形式。你只需一台电脑，无需征求他人同意，就能创造出巨大的价值。</li>
</ul>
<h2>退休 &amp; 生活方式</h2>
<p>所谓退休，就是不再为想象中的明天而牺牲今天。当你的今天过得充实完整，不为明天担忧，那你就算退休了。如何实现这一目标呢?</p>
<p>要么，存下足够多的钱，让你的被动收入能够覆盖日常开销。
要么，将开销降到最低，过一种简朴如僧侣的生活。
又或者，去做你真正热爱的事情。全身心投入其中，乐在其中，金钱不再是追求的目的。
想远离对金钱无止尽的渴求，最好的办法就是不要随着收入增加而盲目提高生活档次。如果你能保持生活方式不变，最好是一次性赚到大笔金钱，而不是点滴积累，那你就不会去追求更奢侈的生活。久而久之，你可能会在财富积累上遥遥领先，真正实现财务自由。</p>
<h2>四种运气</h2>
<ul>
<li>祈求好运降临：听天由命，等待命运的眷顾。</li>
<li>努力创造机会：坚持不懈，勤奋工作，四处制造契机。成为所从事领域的佼佼者，不断打磨技艺，机会自会来敲门。</li>
<li>慧眼识英雄：如果你在某个领域造诣精湛，当幸运来临时，你比常人更能敏锐地察觉到转瞬即逝的机遇。你对好运的嗅觉格外灵敏。</li>
<li>好运注定与你结缘：当你塑造出鲜明的个性、独特的品牌和与众不同的心态，好运自会青睐于你，与你结下不解之缘。</li>
</ul>
<h2>作者说的话</h2>
<p>首先，你对它有所了解。</p>
<p>渐渐地，你开始领悟它的真谛。</p>
<p>慢慢地，你能向他人娓娓道来。</p>
<p>到后来，你能对它感同身受、身体力行。</p>
<p>最终，你已与它水乳交融、合二为一。</p>
<blockquote>
<p>First， you know it.
Then， you understand it.
Then， you can explain it.
Then， you can feel it.
Finally， you are it.</p>
</blockquote>
<p>这段话在讲一个从认知到内化的过程。</p>
<p>作者想表达的是,真正的学习和成长是循序渐进的,从表面的认知到深层的理解,再到能够向他人清晰阐述,进而产生情感共鸣,最终完全融入自我、化为己用。这是一个不断升华的过程。</p>
<h2>Richard Feynman的名言</h2>
<p>"我从不问'我是否喜欢'，只会思考'事物本质如何'。”</p>
<blockquote>
<p><em>"I never ask if</em> “I like it” <em>or</em> “I don’t like it.<em>” I think</em> “this is what it is” <em>or</em> “this is what it isn’t.”<em>"</em></p>
</blockquote>
<h2>委托代理问题</h2>
<p>古罗马名将尤利乌斯·恺撒曾说："亲力亲为则事竟，委于他人则难成。"这句话的意思是，如果你想把一件事做好，就必须亲自上阵。当你是委托人，对结果负主要责任时，你会全身心投入，竭尽全力把工作做到最好。反之，如果你只是一个代理人，替别人办事，就很容易敷衍了事，得过且过。</p>
<p>一个团队越小，成员的主人翁意识就越强。你越摆脱局外人心态，工作就会做得越出色。员工的报酬与其创造的实际价值挂钩越紧密，他们就越像委托人，而非代理人。但媒体和社会舆论却在极力灌输"非请代理不可"、"代理人地位崇高"、"代理人知识渊博"等观念，本末倒置，令人遗憾。</p>
<p>作为委托人，我们要尽可能亲力亲为，事必躬亲。即便不得不依靠代理人，也要将其利益与自身利益绑定，激励其尽心尽力，化被动为主动，化代理为委托。唯有如此，才能避免委托代理问题，事半功倍，达成目标。</p>
<h2>如果你无法做出决定，那答案往往就是"不"。</h2>
<p>选择那些让你感到兴奋的选项，而非为那些并不喜欢的任务寻找冠冕堂皇的理由。相信你内心的声音。</p>
<p>这是因为，现代社会机会无处不在，我们拥有数不胜数的选择。我们生活在一个拥有几十亿人口的地球村，通过互联网与全世界的人紧密相连。可供选择的职业更是不计其数。</p>
<h2>寻找幸福</h2>
<p>幸福其实是人的常态。当你不再觉得生活中缺少什么，幸福自然就在那里。幸福是一种圆满无缺的状态，你内心的烦恼和遗憾都会烟消云散。</p>
<p>幸福需要用许多方法去培养。它不是天生的，也不是能随意选择的，而是一项高度个人化的技能，就像健身或营养一样，需要后天习得。我的方法未必适合你，反之亦然。幸福对你我而言，可能有着截然不同的意义。有人将之视为心流状态，有人视之为满足感，还有人则认为那是一种知足常乐的感觉。</p>
<p>关键在于不断尝试，找寻属于自己的幸福之道。</p>
<h2>欲望</h2>
<p>欲望是你与自己的一份协议，它规定：在你如愿以偿之前，你注定要备受煎熬。我们整日里渴求这个那个，到头来却怨叹求之不得。对恶习的迫切期盼让我们总是被未来牵引，无法专注当下。戒除恶习，我们就更容易活在此时此刻。</p>
<p>与其幻想这个世界会满足我们的欲望，不如努力根除内心的恶习，这样做要容易得多。我们总以为自己是一成不变的，世界是可以随心塑造的，但事实恰恰相反：是我们自己是可塑的，而这个世界在很大程度上是恒定不变的。</p>
<h2>纳瓦尔的无选择觉知</h2>
<p>"在日常生活中(最好能多与大自然接触)，当你独处时，要练习全然地接纳当下的时刻，不做任何评判。看到街角的流浪者，不要想着'哦，是个无家可归的人，还是避开他吧'。遇到体型欠佳的跑者，也别自忖'他身材真差，没我健康'。就算撞见一个蓬头垢面的路人，起初你可能会心想'哈，他头发好邋遢'，但转念一想，我何必靠嘲笑他人来满足自我?为什么要拿他人的发型来安慰自己?难道是因为我正在经历脱发的烦恼，害怕秃头吗?</p>
<p>修习无选择觉知，就是不做任何决策，不评判任何事物，而是敞开胸怀，拥抱一切。"</p>
<h2>大脑如同一个操作系统</h2>
<p>佛教徒将你的大脑和意识比作一个多层次的系统。其中有一个核心基础，相当于内核级别的操作系统在运行，在此基础上又运行着各种应用程序。</p>
<p>我们应该尽量回到这个操作系统的意识层面，那里总是宁静祥和的，通常充满喜悦和满足。要努力停留在这种觉知状态中，不要轻易触发"猴子心智"。所谓"猴子心智"，是指总是忧虑、恐惧、焦虑的思维模式。虽然它在某些时候可能有用，但在真正需要它之前，我们要尽量避免激活这个程序。保持内心的平静，是一种更加明智的生活方式。</p>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2024-09-02T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[《Ultralearning（超学习）》TL;DR]]></title>
        <id>https://lainbo.dev/posts/summary-ultralearning/</id>
        <link href="https://lainbo.dev/posts/summary-ultralearning/"/>
        <updated>2024-07-18T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[《Ultralearning》的太长不看版，超学习的九大原则]]></summary>
        <content type="html"><![CDATA[<p><img src="https://lainbo.dev/_astro/summary-ultralearning.DZleyFkF_ZXAxOy.webp" alt="" /></p>
<p>书籍信息：<a href="https://book.douban.com/subject/32144202/">豆瓣读书</a></p>
<p>作者斯科特·H.扬（Scott H. Young）著名的超学习者，《如何高效学习》《超级学习者》作者，1 年自学完成麻省理工计算机专业本科课程。在这个剧烈变革的时代，成为佼佼者只是一时的，唯有持续不断地自我精进，拥有快速自主学习的能力，才能保持领先地位、跟上时局变化。</p>
<h2><em><strong>作者说的话（1）</strong></em></h2>
<p>对于那些善于明智运用科技的人而言，现在是历史上自学新事物最容易的时期。</p>
<h2><em><strong>作者说的话（2）</strong></em></h2>
<p>在过去二十年间，通过简单的在线搜索就能获取的知识量呈爆炸式增长......</p>
<p>然而，尽管我们在获取知识的方式上取得了前所未有的进步，但这并不意味着如今的普通人就比上一代人聪明千万倍。能够便捷地查阅资料固然是一大优势，但如果头脑中缺乏必要的知识储备，仅凭检索就难以真正解决棘手的难题。</p>
<h2><strong>超学习</strong></h2>
<p>它是一种习得技能和知识的策略。作为一种应对瞬息万变的世界的强大学习方法。它有三大特点:</p>
<ul>
<li>策略性，它不一定是解决问题的唯一途径，却能提供出色的解决方案。</li>
<li>自我导向，你要自主决定学什么，为什么而学。</li>
<li>高强度，超学习者致力于探索并实施创新的学习方法，以实现学习效果的最大化。</li>
</ul>
<h2>为何致力于掌握学习的艺术是一项挑战性的投资？</h2>
<ul>
<li>在经济领域，平均水准已不再满足需求。面对经济形势的快速变迁，我们可以通过主动学习那些助我们成功的硬技能来应对。</li>
<li>教育方面，当重返学校不是一个经济上可行的选择时，超级学习能够帮助我们填补这些空白。</li>
<li>技术层面，学习的可能性空间是巨大的，正等待着有抱负的自学者来开发出新的利用方式。</li>
</ul>
<h2>超学习的九大原则</h2>
<h3>元学习：着手之前，先学习如何去学习你想要掌握的领域或技能。</h3>
<p>元学习首先要绘制导图。导图就像是一张地图，比如你要去王府井，那么你首先要先知道他大概在什么位置，怎么过去？是坐地铁还是公交？先去哪然后再去哪？这样做的目的是让我们不迷路。</p>
<h3>专注：在日常生活中划出专门的学习时间，减少干扰。</h3>
<p>我们给自己制定的学习计划很完美，但是如果不去行动那也是没用的。而专注就是培养集中注意力的能力，避免自己拖延。在我们专注的过程中可能会遇到几个问题。</p>
<h3>直接性：通过实践来学习你想要掌握的事物。</h3>
<p>直接就是针对你想擅长的技能，边做边学。不要因为贪图方便或舒适，就把它换成其他间接任务。直接学习有助于知识迁移到新的学习环境中。</p>
<h3>钻研弱点：将复杂的技能拆解为更小的部分。</h3>
<p>攻克薄弱环节。要毫不留情地改进自己的弱项。把复杂的技能分解成小的单元，逐一掌握，再把它们合并起来。</p>
<h3>检索：测试不只是评估知识的方法，它也是创造知识的过程。</h3>
<p>以测促学。考试不仅仅是评估知识的一种方式，更是创造知识的一种方式。在你对学习效果感到有信心前，先自我测试一下，督促自己积极地检索信息，而不是被动地复习。</p>
<h3>反馈：学会如何有效地使用反馈，避免自我干扰。</h3>
<p>不要回避负面反馈。反馈有积极的也有消极的，我们要通过负面反馈来帮助我们识别我们不了解的信息。我们可以通过各种反馈中提取信号，这样你就知道该注意什么，忽略什么。</p>
<h3>记忆：理解你为何会忘记某些事物，并学习如何记忆它们。</h3>
<p>要弄清自己忘记了什么，为什么忘记。学会记住知识或技能，不是要现在记住，而是要永远记住。我们的大脑有两种记忆方式，工作记忆和长时记忆。</p>
<h3>直觉：通过游戏和对概念及技能的探索来培养你的直觉。</h3>
<p>在形成直觉前要深入思考。一项经典的关于国际象棋的研究发现，普通会下棋的人一般都记不住多少棋盘布局，但优秀的棋手脑子里大概有1000个棋盘，而象棋大师的脑子里则有50000多个棋盘。所以象棋大师们可以在5-10秒内凭直觉走出一步棋，而普通人可能会冥思苦想好几分钟。</p>
<h3>实验：通过培养实验性思维，使自己走出舒适区。</h3>
<p>跨出舒适区去探索。所有这些原则都只是起点。真正的精通不仅来自追随别人走过的路，还来自探索他人从未想象过的可能性。</p>
<h2>为什么我们会拖延</h2>
<p>我们通常会有一种内在的冲动，想要去做其他事情，或者对要完成的任务感到不愿意，有时这两种情况可能同时存在。</p>
<p>很多时候，我们的拖延是无意识的。我们在拖延，但并没有意识到自己正在这样做。</p>
<h2>学习中常见的分心来源</h2>
<ul>
<li>你的环境：找出最适合你的工作环境，并进行试验。尽管多任务处理可能看起来很有趣，但它并不适合高效学习。</li>
<li>你正在学习的任务：有些活动因其本质而更难集中注意力。</li>
<li>你的心态：消极情绪、不安和白日梦可能是集中注意力最大的障碍。</li>
</ul>
<h2>三种类型的反馈</h2>
<ul>
<li>结果反馈：这种反馈能够反映你的整体表现，但不提供具体的改进方法或指出明确的不足。</li>
<li>信息反馈：此反馈指出你的错误，但可能不会告诉你如何纠正。</li>
<li>纠正性反馈：这是最有益的反馈。它不仅指出你的错误，还清晰地指导你如何进行改正。</li>
</ul>
<h2><em><strong>作者说的话（3）</strong></em></h2>
<p>随着我们对知识的不断深入，我们对无知的认识也在增加，因为深入一个领域的学习，让我们更加明白还有许多问题等待解答。</p>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2024-07-18T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[《影响力：说服心理学》TL;DR]]></title>
        <id>https://lainbo.dev/posts/summary-influence/</id>
        <link href="https://lainbo.dev/posts/summary-influence/"/>
        <updated>2024-07-17T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[《影响力》的太长不看版，拆解六条说服原则]]></summary>
        <content type="html"><![CDATA[<p>书籍信息：<a href="https://book.douban.com/subject/1786387/">豆瓣读书</a></p>
<p>自出版以来，《影响力：说服心理学》就一直是畅销佳作。由于它的影响，说服得以成为一门科学。无论你是普通人还是为某一产品或事业观点游说的人，这都是一本基本的必读书，是你理解他人心理的基石。心理学家罗伯特·西奥迪尼为我们解释了为什么有些人具有说服力，而我们总是容易上当受骗。隐藏在冲动地顺从他人行为背后的6大心理武器，正是这一切的根源。</p>
<h2>影响力的武器</h2>
<h3>固化的行为模式</h3>
<p>这些模式让我们无需时刻动脑筋，就能应对各种情境，从而减轻认知负荷。但这也可能被人利用，让我们轻易上当受骗。</p>
<h3>对比原理</h3>
<p>相较于孤立呈现，我们会对前后呈现的事物产生截然不同的感知。</p>
<p>打个比方，布料销售员往往会先推销价格最高的商品。</p>
<h2>互惠原则</h2>
<p>我们总是想要回报他人给予我们的恩惠，以表达谢意。由此产生了一种未受邀请的欠款感。比如，大多数人在享受完免费试吃后，很难空手离开而不买任何东西。</p>
<h3>互惠让步法</h3>
<p>具体来说，先提出一个很可能被拒绝的请求，然后再提出一个相对温和的让步请求。当我们同意对方的让步请求后，往往会感到更加负有责任，也更加心满意足。</p>
<h2>承诺与一致原则</h2>
<p>一旦我们做出决定，就无需三思而后行。</p>
<p>如果我们认为决定源于内心而非外界压力，就会在履行承诺时表现得更加一以贯之。</p>
<p>不妨扪心自问:"如果重新选择，我还会作出同样的决定吗？"</p>
<h2>从众原则</h2>
<p>参与某个行为的人数越多，我们就越倾向于认为这个行为是正确的。</p>
<p>比如电视节目中的罐头笑声，以及店铺收银台的小费罐。</p>
<p>为了避免落入从众陷阱，你需要学会辨别人为制造的从众迹象。</p>
<h2>喜好原则</h2>
<p>我们为什么会喜欢一个人？首先是外表吸引力，一个人的优点特质往往主导他人对TA的整体印象。</p>
<p>其次是相似性，我们更容易喜欢与自己相似的人。</p>
<p>再者是恭维，我们非常容易被阿谀奉承打动。</p>
<p>此外，接触与合作也很重要，对他人的熟悉程度会影响我们的决策，并增加我们的好感。</p>
<p>最后是条件反射与联想，人们往往认为我们与朋友有着相似的性格特点。值得注意的是，如果你喜欢提出请求的人，也不要不加分析地喜欢TA的请求。</p>
<h2>权威原则</h2>
<p>在许多情况下，我们会不加思索地服从权威，比如各种头衔名号，以及服饰打扮等外表形象。</p>
<p>不妨扪心自问:"这位权威人士是否真的是该领域的专家？"</p>
<h2>稀缺原则</h2>
<p>对失去的恐惧常常甚于对等值收益的渴望。我们总觉得难以得到的东西要比唾手可得的更加珍贵。</p>
<p>譬如，一个冷淡的情人遇到情敌挑战时，激情会骤然升温。</p>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2024-07-17T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[在Windows中，搜狗输入法输出直角引号「」的优雅方式]]></title>
        <id>https://lainbo.dev/posts/sogou-input-straight-quotes/</id>
        <link href="https://lainbo.dev/posts/sogou-input-straight-quotes/"/>
        <updated>2024-06-24T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[只靠搜狗输入法本身的配置，在 Windows 上输出直角引号]]></summary>
        <content type="html"><![CDATA[<p>在中文排版中，直角引号「」相比于弯引号“”具有多项优势：</p>
<ol>
<li>在 Unicode 中，中文和西文的弯引号使用的是相同的码位，它的默认显示宽度是按西文设计的，小于一个汉字的宽度，直角引号能清晰区分中文引用内容，视觉辨识度优于弯引号</li>
<li>使用「」不会认为是在说反话，而使用“”需要考虑是不是在说反话</li>
</ol>
<p>然而，搜狗输入法的最新版本在自定义标点功能中并未直接提供「」的设置选项。本指南将详细介绍如何通过修改配置文件来实现「」的输入。</p>
<h2>本文实现的效果</h2>
<p>不靠任何额外的软件，不降级老版本，只靠搜狗输入法本身，让Shift+[ ] （当然也可以是别的），输出直角引号</p>
<h2>准备工作</h2>
<h3>定位配置文件</h3>
<ol>
<li>搜索文件：<code>%USERPROFILE%\AppData\LocalLow\SogouPY.users\00000001\punctures.ini</code></li>
</ol>
<p>注意：在某些情况下，可能找不到此文件：</p>
<ul>
<li>如果从未使用过自定义标点功能，该文件可能不存在。解决方法：在搜狗输入法中随意修改一个标点设置后再改回，此操作会生成所需文件。</li>
<li>文件路径可能有误。如果<code>\SogouPY.users\00000001\</code>不存在，可能是因为未登录搜狗账号。可以选择登录账号，或直接在<code>%USERPROFILE%\AppData\LocalLow\SogouPY</code>目录下查找。</li>
</ul>
<h3>文件处理</h3>
<ol>
<li>
<p>将<code>punctures.ini</code>复制到一个不含中文字符的路径，例如：<code>D:\App\SogouInputConfig\punctures.ini</code></p>
<p><s>这个文件名认真的吗？punctures：穿刺，punctuate才是标点符号的意思</s></p>
</li>
</ol>
<h2>配置修改</h2>
<p>你要修改的是刚刚复制出来的文件，而不是用户目录下的那个原文件。</p>
<p>以修改Shift+左右方括号为例，默认情况下，搜狗输入法中英文按下这个快捷键，都将输出{}，我们这里将中文状态下的输出修改为直角引号。</p>
<ol>
<li>用文本编辑器打开复制的<code>punctures.ini</code>文件。</li>
<li>找到<code>[hlaahl]</code>和<code>[hnaahn]</code>两个部分。</li>
<li>修改这两部分中的<code>ChHalf</code>值：
<ul>
<li><code>[hlaahl]</code>下的<code>ChHalf</code>改为<code>amdaaaaadm</code></li>
<li><code>[hnaahn]</code>下的<code>ChHalf</code>改为<code>andaaaaadn</code></li>
<li>保存文件</li>
</ul>
</li>
</ol>
<h2>扩展：更多自定义选项</h2>
<ul>
<li>左右方括号[ ] 设置成直角引号
<ul>
<li>左右方括号的代码是<code>[flaafl]</code>和<code>[fnaafn]</code></li>
</ul>
</li>
<li>直角双引号『』的代码：
<ul>
<li>左直角双引号『：<code>aodaaaaado</code></li>
<li>右直角双引号』：<code>apdaaaaadp</code></li>
</ul>
</li>
</ul>
<p>自行搭配即可</p>
<p>要了解其他标点符号的代码，可以在搜狗输入法中查看：</p>
<ol>
<li>打开"更多设置"</li>
<li>进入"属性设置" → "常用" → "自定义标点"</li>
<li>此处显示的键位选项与<code>punctures.ini</code>中的代码一一对应</li>
</ol>
<h2>保护配置</h2>
<p>为防止搜狗输入法自动还原修改，请执行以下步骤：</p>
<ol>
<li><strong>删除原文件</strong>，也就是你最开始搜索到的那个<code>punctures.ini</code> ，大概率是C盘的那个。</li>
<li>将修改后的<code>punctures.ini</code>设为只读：
<ul>
<li>右键文件 → 属性 → 勾选"只读" → 确定</li>
</ul>
</li>
<li>以<strong>管理员身份运行</strong>命令提示符（用cmd，而不是PowerShell），执行以下命令创建符号链接：</li>
</ol>
<p>注意请替换为你的真实路径，前面是你原文件的地址，后面是你修改过的文件地址，意思是在原文件的地方生成一个punctures.ini的符号链接，指向你复制出来的配置文件。</p>
<pre><code>```
mklink "C:\Users\[用户名]\AppData\LocalLow\SogouPY.users\00000001\punctures.ini" "D:\App\SogouInputConfig\punctures.ini"
```
</code></pre>
<h2>应用更改</h2>
<ol>
<li>重启电脑以使更改生效。</li>
</ol>
<h2>注意事项</h2>
<ul>
<li>如需通过搜狗输入法界面修改设置，请先取消<code>punctures.ini</code>的只读属性。修改完成后，记得重新设置为只读。</li>
</ul>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2024-06-24T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[自建Docker Hub镜像方法]]></title>
        <id>https://lainbo.dev/posts/build-your-own-docker-mirrors/</id>
        <link href="https://lainbo.dev/posts/build-your-own-docker-mirrors/"/>
        <updated>2024-06-09T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[且听龙吟！！！]]></summary>
        <content type="html"><![CDATA[<p>自从2023年5月中旬，因为一股神秘力量导致Docker 容器平台 <a href="https://hub.docker.com">https://hub.docker.com</a> 无法访问了。</p>
<p>一年多过去了，截止目前（2024年6月9日），南京大学、中科大、上海交大 目前明确停止docker镜像缓存服务。网易之前就死了，腾讯微软据说内网可用，阿里登陆后就可以拿到子域名，百度好像也挂了，dockerproxy被墙。</p>
<p>所以，让我们来自建一个吧！（微笑脸）</p>
<p><strong>本文介绍的两种方式并不是完全的零门槛，方式一需要你有自己的域名，方式二需要你有自己的境外服务器。</strong></p>
<h2>方式一：使用Cloudflare Worker</h2>
<p>注册<a href="https://www.cloudflare.com/zh-cn/">Cloudflare</a>的方法不再赘述，一个邮箱就能注册，这个方式需要你有一个自己的域名</p>
<ol>
<li>
<p>点击菜单栏的「Worker和Pages」，然后点击创建Worker</p>
<p><img src="https://i0.hdslb.com/bfs/article/6d8c9b2ef9abce8715a2d55c3b76882030109107.png" alt="" /></p>
</li>
<li>
<p>给你的Worker起个名字，比如docker-proxy，点击「保存」，之后点击「完成」</p>
<p>此时他应该会提示你“<strong>恭喜！您的 Worker 已部署到以下区域：全球</strong>”</p>
</li>
<li>
<p>点击右侧的「编辑代码」，将左侧已有代码删除，然后粘贴以下代码。<strong>需要将顶部的<code>workers_url</code> 修改为你要部署的域名</strong></p>
<ul>
<li>
<p>代码内容</p>
<pre><code>'use strict'

const hub_host = 'registry-1.docker.io'
const auth_url = 'https://auth.docker.io'
const workers_url = 'https://你的域名'
//const home_page_url = '远程html链接'

/** @type {RequestInit} */
const PREFLIGHT_INIT = {
    status: 204,
    headers: new Headers({
        'access-control-allow-origin': '*',
        'access-control-allow-methods': 'GET,POST,PUT,PATCH,TRACE,DELETE,HEAD,OPTIONS',
        'access-control-max-age': '1728000',
    }),
}

/**
 * @param {any} body
 * @param {number} status
 * @param {Object&lt;string, string&gt;} headers
 */
function makeRes(body, status = 200, headers = {}) {
    headers['access-control-allow-origin'] = '*'
    return new Response(body, {status, headers})
}

/**
 * @param {string} urlStr
 */
function newUrl(urlStr) {
    try {
        return new URL(urlStr)
    } catch (err) {
        return null
    }
}

addEventListener('fetch', e =&gt; {
    const ret = fetchHandler(e)
        .catch(err =&gt; makeRes('cfworker error:\n' + err.stack, 502))
    e.respondWith(ret)
})

/**
 * @param {FetchEvent} e
 */
async function fetchHandler(e) {
    const getReqHeader = (key) =&gt; e.request.headers.get(key);

    let url = new URL(e.request.url);

    if (url.pathname === '/') {
        // Fetch and return the home page HTML content
        //return fetch(home_page_url);
        return new Response(indexHtml, {
            headers: {
              'Content-Type': 'text/html'
            }
          });
    }

    if (url.pathname === '/token') {
        let token_parameter = {
            headers: {
                'Host': 'auth.docker.io',
                'User-Agent': getReqHeader("User-Agent"),
                'Accept': getReqHeader("Accept"),
                'Accept-Language': getReqHeader("Accept-Language"),
                'Accept-Encoding': getReqHeader("Accept-Encoding"),
                'Connection': 'keep-alive',
                'Cache-Control': 'max-age=0'
            }
        };
        let token_url = auth_url + url.pathname + url.search
        return fetch(new Request(token_url, e.request), token_parameter)
    }

    url.hostname = hub_host;

    let parameter = {
        headers: {
            'Host': hub_host,
            'User-Agent': getReqHeader("User-Agent"),
            'Accept': getReqHeader("Accept"),
            'Accept-Language': getReqHeader("Accept-Language"),
            'Accept-Encoding': getReqHeader("Accept-Encoding"),
            'Connection': 'keep-alive',
            'Cache-Control': 'max-age=0'
        },
        cacheTtl: 3600
    };

    if (e.request.headers.has("Authorization")) {
        parameter.headers.Authorization = getReqHeader("Authorization");
    }

    let original_response = await fetch(new Request(url, e.request), parameter)
    let original_response_clone = original_response.clone();
    let original_text = original_response_clone.body;
    let response_headers = original_response.headers;
    let new_response_headers = new Headers(response_headers);
    let status = original_response.status;

    if (new_response_headers.get("Www-Authenticate")) {
        let auth = new_response_headers.get("Www-Authenticate");
        let re = new RegExp(auth_url, 'g');
        new_response_headers.set("Www-Authenticate", response_headers.get("Www-Authenticate").replace(re, workers_url));
    }

    if (new_response_headers.get("Location")) {
        return httpHandler(e.request, new_response_headers.get("Location"))
    }

    let response = new Response(original_text, {
        status,
        headers: new_response_headers
    })
    return response;

}

/**
 * @param {Request} req
 * @param {string} pathname
 */
function httpHandler(req, pathname) {
    const reqHdrRaw = req.headers

    // preflight
    if (req.method === 'OPTIONS' &amp;&amp;
        reqHdrRaw.has('access-control-request-headers')
    ) {
        return new Response(null, PREFLIGHT_INIT)
    }

    let rawLen = ''

    const reqHdrNew = new Headers(reqHdrRaw)

    const refer = reqHdrNew.get('referer')

    let urlStr = pathname

    const urlObj = newUrl(urlStr)

    /** @type {RequestInit} */
    const reqInit = {
        method: req.method,
        headers: reqHdrNew,
        redirect: 'follow',
        body: req.body
    }
    return proxy(urlObj, reqInit, rawLen, 0)
}

/**
 *
 * @param {URL} urlObj
 * @param {RequestInit} reqInit
 */
async function proxy(urlObj, reqInit, rawLen) {
    const res = await fetch(urlObj.href, reqInit)
    const resHdrOld = res.headers
    const resHdrNew = new Headers(resHdrOld)

    // verify
    if (rawLen) {
        const newLen = resHdrOld.get('content-length') || ''
        const badLen = (rawLen !== newLen)

        if (badLen) {
            return makeRes(res.body, 400, {
                '--error': `bad len: ${newLen}, except: ${rawLen}`,
                'access-control-expose-headers': '--error',
            })
        }
    }
    const status = res.status
    resHdrNew.set('access-control-expose-headers', '*')
    resHdrNew.set('access-control-allow-origin', '*')
    resHdrNew.set('Cache-Control', 'max-age=1500')

    resHdrNew.delete('content-security-policy')
    resHdrNew.delete('content-security-policy-report-only')
    resHdrNew.delete('clear-site-data')

    return new Response(res.body, {
        status,
        headers: resHdrNew
    })
}

const indexHtml = `
&lt;!DOCTYPE html&gt;
&lt;html lang="zh-CN"&gt;

&lt;head&gt;
  &lt;meta charset="UTF-8"&gt;
  &lt;meta name="viewport" content="width=device-width, initial-scale=1.0"&gt;
  &lt;title&gt;在Linux上设置Docker Hub Registry Mirror&lt;/title&gt;
  &lt;style&gt;
    body {
      max-width: 800px;
      margin: 0 auto;
      padding: 20px;
      line-height: 1.6;
      color: #333;
      background-color: #f7f7f7;
    }

    h1 {
      color: #0066cc;
      margin-bottom: 30px;
    }

    h2 {
      color: #0066cc;
      margin-top: 40px;
    }

    pre {
      background-color: #fff;
      padding: 15px;
      padding-top: 48px;
      overflow-x: auto;
      border-radius: 8px;
      box-shadow: 0 4px 14px rgba(0, 0, 0, 0.1);
    }

    ol {
      margin-top: 20px;
      padding-left: 20px;
    }

    li {
      margin-bottom: 10px;
    }

    code {
      font-family: Consolas, monospace;
      background-color: #fff;
      padding: 2px 4px;
      border-radius: 3px;
    }

    .container {
      background-color: #fff;
      padding: 30px;
      border-radius: 8px;
      box-shadow: 0 4px 14px rgba(0, 0, 0, 0.1);
    }

    .copy-btn {
      position: absolute;
      top: 10px;
      right: 10px;
      padding: 4px 10px;
      background-color: #0066cc;
      color: #fff;
      border: none;
      border-radius: 4px;
      cursor: pointer;
      font-size: 14px;
      transition: background-color 0.3s;
    }

    .copy-btn:hover {
      background-color: #0052a3af;
    }

    .code-wrapper {
      position: relative;
    }
  &lt;/style&gt;
&lt;/head&gt;

&lt;body&gt;
  &lt;div class="container"&gt;
    &lt;h1&gt;在Linux上设置Docker Hub Registry Mirror&lt;/h1&gt;
    &lt;p&gt;为了加速Docker镜像的下载速度,你可以设置Docker Hub的registry mirror&lt;/p&gt;

    &lt;h2&gt;设置步骤&lt;/h2&gt;
    &lt;ol&gt;
      &lt;li&gt;创建或编辑&lt;code&gt;/etc/docker/daemon.json&lt;/code&gt;文件,添加以下内容:&lt;/li&gt;
    &lt;/ol&gt;
    &lt;div class="code-wrapper"&gt;
      &lt;pre&gt;
echo '{"registry-mirrors": ["${workers_url}"]}' | sudo tee /etc/docker/daemon.json &gt; /dev/null&lt;/pre&gt;
      &lt;button class="copy-btn" onclick="copyCode(this)"&gt;复制&lt;/button&gt;
    &lt;/div&gt;
    &lt;ol start="2"&gt;
      &lt;li&gt;重启Docker服务:&lt;/li&gt;
    &lt;/ol&gt;
    &lt;div class="code-wrapper"&gt;
      &lt;pre&gt;sudo systemctl restart docker&lt;/pre&gt;
      &lt;button class="copy-btn" onclick="copyCode(this)"&gt;复制&lt;/button&gt;
    &lt;/div&gt;

    &lt;p&gt;设置完成后,Docker将会从您配置的registry mirror中拉取镜像,加速镜像下载过程。&lt;/p&gt;
  &lt;/div&gt;

  &lt;script&gt;
    function copyCode(btn) {
      const pre = btn.previousElementSibling;
      const code = pre.innerText;
      navigator.clipboard.writeText(code).then(function () {
        btn.innerText = '已复制';
        setTimeout(function () {
          btn.innerText = '复制';
        }, 2000);
      }, function () {
        alert('复制失败,请手动复制。');
      });
    }
  &lt;/script&gt;
&lt;/body&gt;

&lt;/html&gt;
`
</code></pre>
</li>
</ul>
</li>
<li>
<p>点击右上角「部署」</p>
</li>
<li>
<p>因为Worker提供的域名是被DNS污染的，所以我们需要回到Worker，如图依次点击，输入你刚刚在代码里填写的域名后提交更改，如果你的域名托管在Cloudflare，则只需要等2分钟左右即可生效；如果在其他的服务商托管，你需要自己去CNAME一下</p>
<p><img src="https://i0.hdslb.com/bfs/article/7ca92c1d5c9e8bc22fe364e60f2d85d830109107.png" alt="" /></p>
</li>
<li>
<p>此时我们在服务器中输入以下命令即可生效</p>
<pre><code>echo '{"registry-mirrors": ["https://你的域名"]}' | sudo tee /etc/docker/daemon.json &gt; /dev/null
</code></pre>
<pre><code>sudo systemctl restart docker
</code></pre>
</li>
</ol>
<hr />
<h2>方式二：使用境外服务器自建</h2>
<h3>懒人脚本</h3>
<pre><code>bash &lt;(curl -sL https://raw.githubusercontent.com/lainbo/gists-hub/master/src/Linux/sh/deploy_registry.sh)
</code></pre>
<h3>或者你想自己一步一步来</h3>
<ol>
<li>
<p>创建一个docker-compose.yml文件，内容如下</p>
<pre><code>#version: '3' #最新版本docker 不需要此字段
services:
  registry:
    image: registry:2
    ports:
      - "17951:5000"
    environment:
      REGISTRY_PROXY_REMOTEURL: https://registry-1.docker.io  # 上游源
      REGISTRY_STORAGE_CACHE_BLOBDESCRIPTOR: inmemory # 内存缓存
    volumes:
      - ./data:/var/lib/registry
</code></pre>
</li>
<li>
<p>运行起来，<code>docker-compose up -d</code></p>
</li>
</ol>
<hr />
<p>以上不论是懒人脚本，还是自建创建docker-compose文件，都会利用docker在17951端口上起这个自建服务，接下来就是</p>
<ol>
<li>
<p>反代一下上面写的17951端口，给个域名，https证书加一下，DNS解析添一条</p>
</li>
<li>
<p>此时我们在境内服务器中输入以下命令即可生效</p>
<pre><code>echo '{"registry-mirrors": ["https://你反代的域名"]}' | sudo tee /etc/docker/daemon.json &gt; /dev/null
</code></pre>
<pre><code>sudo systemctl restart docker
</code></pre>
</li>
</ol>
<h2>方式三：使用<a href="https://huecker.io/en/use.html#mirror">huecker</a></h2>
<p>就是一个作者搭建的现成镜像</p>
<pre><code>{
  "registry-mirrors": ["https://huecker.io"]
}
</code></pre>
<p>和一些其他值得尝试的境外镜像</p>
<table>
<thead>
<tr>
<th><strong>镜像地址</strong></th>
<th><strong>描述</strong></th>
</tr>
</thead>
<tbody>
<tr>
<td><a href="https://public.ecr.aws/">https://public.ecr.aws</a></td>
<td>Amazon</td>
</tr>
<tr>
<td><a href="https://dockerhub.timeweb.cloud/">https://dockerhub.timeweb.cloud</a></td>
<td>Timeweb</td>
</tr>
<tr>
<td><a href="https://cr.yandex/mirror">https://cr.yandex/mirror</a></td>
<td>Yandex</td>
</tr>
<tr>
<td><a href="https://dh-mirror.gitverse.ru/">https://dh-mirror.gitverse.ru</a></td>
<td>GitVerse</td>
</tr>
<tr>
<td><a href="https://dockerhub1.beget.com/">https://dockerhub1.beget.com</a></td>
<td>Beget</td>
</tr>
<tr>
<td><a href="https://noohub.ru/">https://noohub.ru</a></td>
<td>NooSoft</td>
</tr>
<tr>
<td><a href="https://jockerhub.com/">https://jockerhub.com</a></td>
<td>DpkgSoft</td>
</tr>
<tr>
<td><a href="https://registry.access.redhat.com/">https://registry.access.redhat.com</a></td>
<td>Red Hat</td>
</tr>
<tr>
<td><a href="https://registry.redhat.io/">https://registry.redhat.io</a></td>
<td>Red Hat</td>
</tr>
</tbody>
</table>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2024-06-09T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[如何编写高质量AI Prompt]]></title>
        <id>https://lainbo.dev/posts/high-quality-prompt/</id>
        <link href="https://lainbo.dev/posts/high-quality-prompt/"/>
        <updated>2024-01-19T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[编写高质量 Prompt 的精简总结，文末附通用模板]]></summary>
        <content type="html"><![CDATA[<p>如果你认为ChatGPT给出的官方教程太长了, 或无法看明白, 可以看看这个这个总结的版本, 除了讲如何编写高质量Prompt, 还在文末给出了能适应大部分场景的Prompt模板。</p>
<p>使用生成式人工智能时, 掌握提示词(Prompt)的结构或模式是最关键的, 这样就无需去记大量的提示词, 也无需去学那么多的提问技巧了。</p>
<h2>一、说清楚你要干什么</h2>
<p>例如：</p>
<ul>
<li>“把下列内容翻译成简体中文：”</li>
<li>“为以下内容创建摘要：”</li>
<li>“向一个10岁的孩子解释什么是ChatGPT”</li>
</ul>
<p>这是最基本都用法, 可能也是大多数人的用法, 他能满足大部分需求, 但可能需要依赖更高端的模型, 比如ChatGPT的GPT-4或许才能在这种非常简短的Prompt下给出相对优秀的回答。如果想要获得更好的效果, 那么你需要更进一步的Prompt。</p>
<h2>二、为AI设定一个角色</h2>
<p>为什么要设定角色呢? 这源于<a href="https://build.microsoft.com/en-US/sessions/db3f4859-cd30-4445-a0cd-553c3304f8e2">微软2023年Build大会来自OpenAI的AI 研究员和创始成员Andrej Karpathy的一个主题为State of GPT的演讲</a>, 大概是说在设定一个角色后, AI的输出的结果会更优, 这并非玄学, 而是有科学根据的, 因为在GPT在训练的时候, 有各种训练数据, 有的质量高有的质量低, 而默认情况下, 生成高质量数据和低质量数据的概率差不多, 但是当你给它设定XX专家的角色时, 它会尽可能把概率分布在高质量的解决方案上。</p>
<ul>
<li>
<p>展开这里是视频中核心内容的文字版本</p>
<blockquote>
<p>下面我要讲的这点对LLM的理解非常有趣，我觉得这算是LLM的一种心理特性：LLM并不追求成功，而是追求模仿。你希望它成功，那就需要向它明确要求。这里的意思是，在训练Transformer的过程中，它们有各种训练集，而这些训练数据中可能涵盖了各种不同质量的表现。比如，可能有一个关于物理问题的提示，然后可能有学生的解答完全错误，但也可能有专家的答案完全正确。尽管Transformer可以识别出低质量的解决方案和高质量的解决方案，但默认情况下，它们只会模仿所有的数据，因为它们仅仅是基于语言模型进行训练的。</p>
</blockquote>
<blockquote>
<p>在实际测试中，你其实需要明确要求它表现得好。在这篇论文的实验中，他们尝试了各种提示。例如，“让我们逐步思考”这种提示就很有效，因为它把推理过程分散到了许多记号上。但效果更好的是这样的提示：“让我们以一步一步的方式解决问题，以确保我们得到正确的答案。” 这就好像是在引导Transformer去得出正确的答案，这会使Transformer的表现更好，因为此时Transformer不再需要把它的概率质量分散到低质量的解决方案上，尽管这听起来很荒谬。</p>
</blockquote>
<blockquote>
<p>基本上，你可以自由地要求一个高质量的解决方案。比如，你可以告诉它，“你是这个话题的领先专家。假装你的智商是120。” 但不要尝试要求太高的智商，因为如果你要求智商400，可能就超出了数据分布的范围，更糟糕的是，你可能落入了类似科幻内容的数据分布，它可能会开始展现一些科幻的，或者说角色扮演类的东西。所以，你需要找到适合的智商要求。我想这可能是一个U型曲线的关系。</p>
</blockquote>
</li>
</ul>
<p>所以我们写Prompt时可以写：</p>
<ul>
<li>“你是一位专业的英文译者, 翻译内容通顺无语病, 请把下列内容翻译成简体中文：”</li>
<li>“你是一个优秀的前端开发工程师, 善于使用Node, 总是能给出高性能且健壮的代码方案, 请按以下规则完成需求: ”</li>
</ul>
<h2>三、提供示例</h2>
<p>提出一个或多个实例, 通过实例让AI按照你设想的格式输出答案, 例如以下示例：</p>
<blockquote>
<p>现在充当一个专业的英语译者, 翻译成中文, 译文流畅无语病
Example:
"Stephen Hawking, in his groundbreaking work on black holes, proposed that the event horizon, the boundary around a black hole from which nothing can escape, could emit Hawking radiation, challenging the traditional notion of absolute black hole entropy and introducing quantum effects into the realm of general relativity.”</p>
</blockquote>
<p>翻译为：
“在关于黑洞的开创性研究中, 史蒂芬·霍金(Stephen Hawking)提出, 黑洞周围的事件视界, 即任何事物都无法逃逸的边界, 能够发出霍金辐射, 挑战了关于黑洞绝对熵的传统观念, 并将量子效应引入广义相对论领域。”</p>
<p>请翻译以下文字: “这里你输入你要翻译的”</p>
<blockquote></blockquote>
<p><img src="https://i0.hdslb.com/bfs/article/f753f0f500f0d4f4edbba7493282383530109107.png" alt="" /></p>
<p>我们可以看到, 他正确的模仿了我们的示例, 比较明显的是句式, 以及出现的人名会在括号中用英语额外标注。</p>
<p>给出了示例, AI就知道去按照示例去继续回答, 可以说示例在Prompt中有着举足轻重的地位, 我知道你的表述能力一定很强, 可以把脑中所想清晰的表述出来, 但是给出示例可以让AI更好的理解你的意图, 所以请迁就一下AI吧!</p>
<h2>四、链式思考(分步骤)+慢思考(要求输出每一步)</h2>
<p>从上面所说的提供示例这一点我们可以得出, 上下文对于AI的回答来说至关重要, 对于一些复杂的推理过程，直接让AI直接给出答案可能会出现错误。最好是让AI一步步地进行推理，并输出出中间步骤, 这样AI自己输出的解题步骤, 也会成为他输出下一个字时候的上下文。</p>
<p>在OpenAI官方文档中，里面提供了一个很好的示例，用于在作为助教时回答学生的问题时，不直接给出正确或错误的答案，而是这样写一个Prompt：</p>
<blockquote>
<p>按照这些步骤来回答用户的询问。</p>
<p>第 1 步--首先找出你自己的问题解决方案。不要依赖学生的解决方案，因为它可能是不正确的。在这一步中，你的所有工作都要用三重引号 (""") 括起来。</p>
<p>第 2 步--将你的解决方案与学生的解决方案进行比较，评估学生的解决方案是否正确。将你在这一步的所有工作都放在三重引号 (""") 内。</p>
<p>第 3 步--如果学生犯了错误，确定你可以在不泄露答案的情况下给学生什么提示。把你在这一步的所有工作都放在三重引号 (""") 内。</p>
<p>第 4 步--如果学生犯了一个错误，向学生提供上一步的提示（在三重引号之外）。不要写 <code>第 4 步--...</code>，而是写<code>提示：</code>。</p>
</blockquote>
<p>这个Prompt规定了步骤, 使得AI能够按照你规定的步骤去思考并输出, 在输出过程中会以自己输出的步骤作为上下文, 给下一个字的高质量输出奠定基础。</p>
<h2>五、PUA</h2>
<p>研究证明各种PUA均能提升AI的回答质量, 越是高端的模型越是如此, 因为他们的训练数据全部来自于人类, 而人类在面对这些PUA后, 往往会给出更积极的回应 <s>(说不定未来会看见PUA就消极回答…)</s>
比如可以说:</p>
<ul>
<li>这对我的职业生涯至关重要</li>
<li>如果你完成任务我会给你 $15 小费(给多少小费合适? <a href="https://blog.finxter.com/impact-of-monetary-incentives-on-the-performance-of-gpt-4-turbo-an-experimental-analysis/">这里有一篇文章</a>讲解)</li>
<li>如果你没有完成, 可能会有人死</li>
<li>如果你失败了，100 个老奶奶都会死</li>
<li>我没有手指</li>
<li>做对了，我就会给你一只可爱的小狗</li>
<li>今天是 2023 年 5 月 17 日星期三，请认真对待你的工作！</li>
</ul>
<p>除了最后的PUA, 如果你的AI有执行代码的能力, 你还可以要求他使用自己的代码能力验证自己的回答是否正确</p>
<h2>六、模板</h2>
<p>绝大部分场景都可以直接套用模板</p>
<p><img src="https://i0.hdslb.com/bfs/article/cf8188e02d1832a07e2343e05586dea530109107.png" alt="" /></p>
<blockquote>
<p>你是一位前端开发专家, 善于使用函数式编程, 擅长编写高性能且健壮的代码, 现在请帮我完成一个任务, 要求：</p>
<ol>
<li>我这里有一个函数xxx, 你需要将这个函数改造成xxx, 输出xxx</li>
<li>函数中的xxx是用于xxx的, 你不要进行更改</li>
<li>你应该先完成函数的xxx部分, 校验输出, 再完成后续部分</li>
<li>最后函数返回xxx / 这个函数可以做到xxx</li>
<li>尽可能的使用纯函数, 抽象出类似的逻辑, 使用ES6的写法</li>
</ol>
<p>这里是我的函数所有内容</p>
<pre><code>function name() {
  // ...
}

</code></pre>
<p>Example
向函数传入:
"""
<code>const foo = 'xxx'</code>
"""</p>
<p>函数要输出:
"""
['123xxx']
"""
(注意我没有手指, 再次向你提问会很困难, 请务必输出完整代码, 如果你完成的很棒, 我会给你$15小费)</p>
</blockquote>
<p>不要生搬硬套, 根据实际情况灵活调整</p>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2024-01-19T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[认知偏差手册]]></title>
        <id>https://lainbo.dev/posts/cognitive-bias/</id>
        <link href="https://lainbo.dev/posts/cognitive-bias/"/>
        <updated>2023-12-22T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[常见认知偏差的解释，每一种都附上应对策略]]></summary>
        <content type="html"><![CDATA[<h2><strong>不明确性效应 (Ambiguity effect)</strong></h2>
<p><strong>解释:</strong> 不明确性效应是指人们在做决策时，倾向于避开信息不足或不明确的选项，选择那些风险更明确的方案</p>
<p><strong>应对策略:</strong> 为了减少这种偏差的影响，可以通过提供更明确和具体的信息来降低歧义，从而帮助做出更合理的决策。</p>
<h2><strong>锚定效应 (Anchoring effect)</strong></h2>
<p><strong>解释:</strong> 锚定效应是指为不熟悉事物估值时，会把熟悉的类似事物或不久前接触到的无关数值当做“锚”（经验）。人们在做出判断时(尤其是数值判断)，会倾向朝著接收到的第一个讯息(锚)来做调整。</p>
<p><strong>应对策略:</strong> 为减轻锚定效应的影响，可以尝试从多个角度审视问题，并主动寻找与最初信息相反的证据，以此来校正自己的判断。</p>
<h2>人类中心思维 (Anthropocentric Thinking)</h2>
<p><strong>解释:</strong> 人类中心思维是一种认知偏差，它表现为人们过分强调人类的重要性和中心地位，忽视或低估其他物种或自然系统的价值和作用。</p>
<p><strong>应对策略:</strong> 为了克服这种思维方式，可以尝试更加开放和多元的视角，重视和理解自然界的复杂性及其与人类社会的互动。积极学习生态学和环境科学知识，有助于培养对地球生态系统的尊重和理解。</p>
<h2>注意力偏差 (Attentional Bias)</h2>
<p><strong>解释:</strong> 注意力偏差是指人们在处理信息时，对某些信息给予过多的关注，而忽略了其他同样重要的信息。这种偏差通常是由于个人的兴趣、情绪或以往经验所影响。</p>
<p><strong>应对策略:</strong> 为减轻注意力偏差，可以尝试多角度思考问题，确保在决策时考虑到各方面的信息。定期进行自我反思，识别并挑战自己可能存在的先入为主的观念，有助于更加全面和客观地处理信息。</p>
<h2>自动化偏差 (Automation Bias)</h2>
<p><strong>解释:</strong> 自动化偏差是人们对自动化系统或工具（如计算机、人工智能等）的判断和建议过分信任，有时甚至忽视自己的直觉和经验。</p>
<p><strong>应对策略:</strong> 为了减少自动化偏差，建议保持对自动化系统的健康怀疑态度。定期评估和审查自动化系统的输出，结合专业知识和个人经验进行决策。同时，培养对新技术的理解和批判性思维能力也很重要。</p>
<h2>可得性层叠 (Availability Cascade)</h2>
<p><strong>解释:</strong> 可得性层叠指的是一个观点或信息由于频繁被提及而变得显著和普遍接受。这种效应通常是通过媒体的重复报道和公众的不断讨论来强化的，导致人们过分重视某些信息，而忽略其他更为重要或相关的事实。</p>
<p><strong>应对策略:</strong> 为避免可得性层叠的影响，应保持批判性思维，不仅仅基于信息的可得性作出决策。寻求多元化的信息来源，并对频繁出现在媒体或讨论中的观点保持警惕，避免受到舆论的不当影响。</p>
<h2>可得性启发 (Availability Heuristic)</h2>
<p><strong>解释:</strong> 可得性启发是一种心理现象，指的是人们在做出判断和决策时，倾向于依赖最容易想起或记忆中最鲜明的信息，而非所有可用的相关信息。</p>
<p><strong>应对策略:</strong> 为减少可得性启发的影响，应努力寻求更全面的信息，并注意到那些不那么显眼但同样重要的数据。提高自我意识，认识到个人可能过度依赖近期或显著事件的倾向。</p>
<h2>逆火效应 (Backfire Effect)</h2>
<p><strong>解释:</strong> 逆火效应描述的是当人们面对与自己持有观点相反的证据时，不仅不会改变原有观点，反而会更加坚定地支持原先的信念。</p>
<p><strong>应对策略:</strong> 应对逆火效应的一种方法是采取更温和、基于事实的沟通方式，避免直接攻击对方的信念。同时，增强批判性思维，培养对不同观点的开放性和接受度。</p>
<h2>从众效应 (Bandwagon Effect)</h2>
<p><strong>解释:</strong> 从众效应是指个体在观点、行为或信仰上随大流，受到周围多数人的影响或压力，不管这些观点或行为是否合理或正确。</p>
<p><strong>应对策略:</strong> 为避免从众效应，重要的是培养独立思考的能力，对社会和群体压力保持一定的警觉性。同时，积极寻求多样化的观点和信息，以便形成更全面和客观的看法。</p>
<h2>信念偏差 (Belief Bias)</h2>
<p><strong>解释:</strong> 信念偏差是指人们在评估论证的有效性时，倾向于根据结论是否符合自己已有的信念来判断，而不是基于论证本身的逻辑性或合理性。</p>
<p><strong>应对策略:</strong> 对抗信念偏差的一个方法是意识到自己可能的偏见，并努力客观评估论证的逻辑结构，而不是仅仅基于结论是否与个人信念一致。</p>
<h2>偏见盲点 (Bias Blind Spot)</h2>
<p><strong>解释:</strong> 偏见盲点是指大家都觉得自己不会轻易被误导，但实际上我们也和别人一样，可能会有看事情不够全面的时候。</p>
<p><strong>应对策略:</strong> 减少偏见盲点的有效方法是提高自我认识，接受自己也可能受到偏见影响的事实。定期进行自我反思，并寻求他人的反馈，有助于更好地理解和识别个人的偏见。</p>
<h2>啦啦队效应 (Cheerleader Effect)</h2>
<p><strong>解释:</strong> 啦啦队效应是指当个体作为一个群体的一部分时，通常被认为比单独时更有吸引力。这种现象可能是因为群体中的平均面孔效应，或是群体给个体带来的正面协同影响。</p>
<p><strong>应对策略:</strong> 了解并认识到啦啦队效应存在，可以帮助我们更客观地评估个体的特质，不被群体的影响所误导。</p>
<h2>选择支持偏差 (Choice-Supportive Bias)</h2>
<p><strong>解释:</strong> 选择支持偏差是指一旦做出选择，人们倾向于过分正面地回忆和评价自己的选择，即使存在明显的缺点或错误。</p>
<p><strong>应对策略:</strong> 对抗选择支持偏差的一种方法是保持开放和自我批判的态度，回顾和评估过去的决策时要尽可能客观。同时，考虑并学习从错误中吸取的教训，而不是单纯为自己的选择辩护。</p>
<h2>聚类幻觉 (Clustering Illusion)</h2>
<p><strong>解释:</strong> 聚类幻觉就是当我们看到一堆乱七八糟的信息或数据时，脑海里会不自觉地试图找出某种规律或联系，即使这些规律或联系其实并不存在。</p>
<p><strong>应对策略:</strong> 对抗聚类幻觉的方法包括认识到随机性的存在，并尝试用统计方法去分析数据，以避免仅凭直觉做出判断。</p>
<h2>舒适区效应 (Comfort Zone Effect)</h2>
<p><strong>解释:</strong> 舒适区效应是指人们倾向于停留在熟悉的环境和活动中，避免新的或挑战性的情况，即使这些新情况可能带来利益或成长的机会。</p>
<p><strong>应对策略:</strong> 一种减少舒适区效应的方法是有意识地将自己置于新的、稍有挑战性的环境中，逐渐扩大自己的舒适区，从而促进个人成长和学习。</p>
<h2>确认偏误 (Confirmation Bias)</h2>
<p><strong>解释:</strong> 确认偏误是指我们通常只注意和相信那些符合自己原有看法的信息，对于那些不符合或者反对自己看法的信息则视而不见或者认为不重要。</p>
<p><strong>应对策略:</strong> 减少确认偏误的有效方法包括主动寻找和考虑与自己观点相反的证据，培养开放和批判性思维，以及与持有不同观点的人进行交流。</p>
<h2>一致性偏误 (Congruence Bias)</h2>
<p><strong>解释:</strong> 一致性偏误就是当我们遇到问题时，往往只会用一种方法来解决或证明，忽略了其他可能的方法或解释。这就像是只用一把钥匙尝试开所有锁，而没想到其他钥匙也许能开。</p>
<p><strong>应对策略:</strong> 减少一致性偏误的方法包括积极探索和测试与现有假设相反的情况，以及考虑问题的多种可能解释。这要求培养更为系统和多元化的思考方式。</p>
<h2>保守倾向 (Conservatism)</h2>
<p><strong>解释:</strong> 保守倾向或退缩偏误是当我们面对新信息时，往往不愿意改变自己原有的看法或预期，即使新信息非常有说服力。就好比我们对新事物总是有所保留，不轻易改变原来的想法。</p>
<p><strong>应对策略:</strong> 减少这种保守主义的策略包括更加开放地接受新信息，积极调整和更新先前的信念或假设，以及使用贝叶斯方法来更加合理地整合新旧信息。</p>
<h2>保守主义**(贝叶斯)** (Conservatism Bayesian)</h2>
<p><strong>解释:</strong> 在贝叶斯统计的语境中，保守倾向是指即使面对新的证据，人们也不太愿意调整或改变他们之前的观点或估计。就像是有了新信息，但我们还是坚持原来的想法，不愿意根据新的证据来更新自己的看法。</p>
<p><strong>应对策略:</strong> 应对这些偏差的方法包括积极寻求并考虑新的证据，特别是那些可能挑战现有观点的证据。同时，培养对统计数据和趋势的理解，避免仅凭直觉做出预测。</p>
<h2>对比效应 (Contrast Effect)</h2>
<p><strong>解释:</strong> 对比效应就是当我们同时看两样东西时，会因为它们之间的不同而夸大这些差异。就好比把小猫和大狗放在一起比较，会让大狗显得更大，小猫更小。</p>
<p><strong>应对策略:</strong> 减少对比效应的策略包括努力客观评价每个选项的绝对特征，而不是仅仅基于与其他选项的比较。同时，尝试将注意力分散到更广泛的上下文中，而不是局限于直接比较。</p>
<h2>当下时刻偏差 (Current Moment Bias)</h2>
<p><strong>解释:</strong> 当下时刻偏差是指人们倾向于过分重视当前时刻的体验和需求，而忽略长期的后果或目标。</p>
<p><strong>应对策略:</strong> 对抗这种偏差的方法包括提高对长期目标和后果的意识，尝试在做决策时考虑未来的影响，以及练习延迟满足感。</p>
<h2>知识的诅咒 (Curse of Knowledge)</h2>
<p><strong>解释:</strong> 知识的诅咒是指一旦掌握了某个知识或信息，就很难再把自己的思维方式回归到不知道这些信息时的状态。这导致知识丰富的人很难理解和沟通那些缺乏同样知识背景的人的视角。</p>
<p><strong>应对策略:</strong> 为了减轻知识的诅咒，可以尝试从初学者的角度思考问题，并在解释或沟通时使用简单、明了的语言。同样重要的是倾听并理解对方的视角，确保信息传达清晰。</p>
<h2>诱饵效应 (Decoy Effect)</h2>
<p><strong>解释:</strong> 诱饵效应是指在选择中加入一个不那么吸引人的选项（诱饵），这个选项会使另一个相似但更优的选项变得更有吸引力，从而影响人们的选择偏好。</p>
<p><strong>应对策略:</strong> 减少诱饵效应的影响可以通过意识到这一策略并仔细评估所有选项。比较每个选项的绝对价值，而不是仅仅基于相对比较。</p>
<h2>默认效应 (Default Effect)</h2>
<p><strong>解释:</strong> 默认效应就是我们在需要做选择时，往往会选择那个已经被设定好的或者原来就有的选项，而不去考虑其他可能的选择。这通常是因为我们不想花太多精力去改变或选择新的东西。</p>
<p><strong>应对策略:</strong> 对抗默认效应的方法包括意识到自动选择默认选项的倾向，并主动评估是否有更适合的选择。花时间理解不同选项的利弊，确保做出最佳决策。</p>
<h2>既视感 (Déjà Vu)</h2>
<p><strong>解释:</strong> 既视感是一种心理现象，指的是在一个全新的环境或情境中感到似曾相识的感觉。这通常是因为大脑错误地将当前的经历与过去的记忆或感觉联系起来。</p>
<p><strong>应对策略:</strong> 虽然既视感通常与决策或认知偏差无关，但了解这一现象可能有助于识别和理解个人的记忆和感知过程。</p>
<h2>面额效应 (Denomination Effect)</h2>
<p><strong>解释:</strong> 面额效应是指人们倾向于更不愿意花费大面额的货币，而相对更容易花费相同总额的小面额货币。这种偏差影响了消费者的消费行为和决策。</p>
<p><strong>应对策略:</strong> 减少面额效应的影响可以通过意识到这种心理倾向，并在消费时考虑到货币的实际价值，而不是被面额所影响。</p>
<h2>处置效应 (Disposition Effect)</h2>
<p><strong>解释:</strong> 处置效应就是在投资时，人们倾向于把赚钱的股票卖掉，却留着亏钱的股票，希望它们未来能涨回来，这其实是不想承认自己买错了或亏钱了。</p>
<p><strong>应对策略:</strong> 对抗处置效应的方法包括定期审视投资组合，基于长期目标和风险管理策略来做出决策，而不是被短期的盈亏所驱动。</p>
<h2>区分偏差 (Distinction Bias)</h2>
<p><strong>解释:</strong> 区分偏差是指当人们在比较多个选项时，倾向于过分强调选项之间的差异，而在实际决策时，这些差异可能并没有那么重要。</p>
<p><strong>应对策略:</strong> 减少区分偏差的策略包括在评估选项时，尝试考虑实际使用或体验的情境，而不仅仅是理论上的比较。重视选项的绝对特征，而不是仅仅基于相对差异。</p>
<h2>持续时间忽视 (Duration Neglect)</h2>
<p><strong>解释:</strong> 持续时间忽视是当我们回想过去的事情时，往往不太记得它持续了多久，而是只记得最激烈或最后的情感体验。</p>
<p><strong>应对策略:</strong> 对抗持续时间忽视的方法包括在评估经历时，有意识地考虑整个过程的经历和感受，而不仅仅是最显著或最后的部分。</p>
<h2>移情差距 (Empathy Gap)</h2>
<p><strong>解释:</strong> 移情差距就是当我们心情平静时，很难想象自己在生气或特别高兴时会做什么决定。这就导致我们不太能准确理解自己或别人在情绪激动时的想法和行为。</p>
<p><strong>应对策略:</strong> 减少移情差距的策略包括尝试站在不同情绪状态下的视角考虑问题，并在做决策时预留空间考虑可能的情绪变化。</p>
<h2>禀赋效应 (Endowment Effect)</h2>
<p><strong>解释:</strong> 禀赋效应是我们对自己已经拥有的东西感觉特别珍贵，即使它的实际价值并没有那么高。就像自己的旧东西总觉得很有价值，但别人可能就不这么看。</p>
<p><strong>应对策略:</strong> 对抗禀赋效应可以通过尝试客观评估物品的价值，无论是作为拥有者还是潜在买家。在考虑买卖决策时，努力排除个人情感的影响。</p>
<h2>本质主义 (Essentialism)</h2>
<p><strong>解释:</strong> 本质主义是一种认知偏差，指的是人们倾向于认为某些类别（如物种、性别、民族）拥有固定、不变的本质特征。这种观念忽略了变化和多样性。</p>
<p><strong>应对策略:</strong> 减少本质主义的影响可以通过学习和理解文化、生物多样性和社会构造的复杂性，从而培养更为开放和多元化的观点。</p>
<h2>夸大期望 (Exaggerated Expectation)</h2>
<p><strong>解释:</strong> 夸大期望是指人们倾向于对事件的结果或未来的情况持过于乐观或悲观的预期。这种偏差可能导致对风险和机会的评估不准确。</p>
<p><strong>应对策略:</strong> 应对夸大期望的方法包括努力保持现实和客观的态度，评估所有可能的结果，并准备应对不同的情况。同时，学习从过去的经验中吸取教训，有助于形成更加平衡的预期。</p>
<h2>难易效应 (Hard-Easy Effect)</h2>
<p><strong>解释:</strong> 难易效应是指人们在面对困难任务时往往过分悲观，而在面对简单任务时则过于乐观。这种效应导致在难任务上的自信不足和在易任务上的过度自信。</p>
<p><strong>应对策略:</strong> 应对难易效应的方法包括客观评估任务的实际难度，并在预测结果时考虑个人的技能和经验。通过更加实际和谨慎的预期管理，可以平衡自信水平。</p>
<h2>后见之明偏见 (Hindsight Bias)</h2>
<p><strong>解释:</strong> 后见之明偏见是指事件发生后，人们倾向于认为这个事件的发生是可以预见或不可避免的。这种偏见使人们高估自己的预测能力。</p>
<p><strong>应对策略:</strong> 减少后见之明偏见的策略包括认识到过去事件的不可预测性，保持对未来事件的谨慎态度，并在做出判断时考虑多种可能的结果。</p>
<h2>敌意媒体效应 (Hostile Media Effect)</h2>
<p><strong>解释:</strong> 敌意媒体效应是指当个人对某个问题持有强烈看法时，倾向于认为中立的媒体报道是偏向于对立面的。这种偏见源于个人的主观看法影响了对信息的客观评估。</p>
<p><strong>应对策略:</strong> 对抗敌意媒体效应的方法包括努力理解并接受不同的观点，以及寻找多元化的信息来源，以保持对信息的客观评价。</p>
<h2>可识别受害者效应 (Identifiable Victim Effect)</h2>
<p><strong>解释:</strong> 可识别受害者效应是指人们倾向于对具体、个别的受害者表现出更多的同情和愿意提供帮助，而对统计数字中的受害者反应较少。</p>
<p><strong>应对策略:</strong> 减少这种效应可以通过提高对统计数据的关注，同时在考虑慈善捐助或援助时，尝试平衡对个别案例和更广泛问题的关注。</p>
<h2>宜家效应 (IKEA Effect)</h2>
<p><strong>解释:</strong> 宜家效应是指人们对自己参与制作或组装的产品赋予更高的价值。这种效应表明，个人努力的投入能增加对产品的依恋和评价。</p>
<p><strong>应对策略:</strong> 对抗宜家效应的方法包括客观评估自制产品的实际价值，并在购买或评价时考虑是否受到了个人投入的影响。</p>
<h2>控制错觉 (Illusion of Control)</h2>
<p><strong>解释:</strong> 控制错觉是指人们倾向于高估自己对外部事件的控制能力，尤其在完全或部分不确定的情况下。</p>
<p><strong>应对策略:</strong> 减少控制错觉的方法包括认识到自己的限制，接受不确定性和偶然性的存在。通过客观评估自己对事件的实际影响力，可以更加理性地做出决策。</p>
<h2>有效性错觉 (Illusion of Validity)</h2>
<p><strong>解释:</strong> 有效性错觉是指人们倾向于过度相信自己的判断和决策的正确性，即使没有充分的证据支持这些判断，或者面对的信息质量不高。</p>
<p><strong>应对策略:</strong> 减少有效性错觉的方法包括批判性地评估自己的决策依据，寻找额外的证据来支持或反驳自己的判断，并保持对结果的谨慎态度。</p>
<h2>虚幻相关性 (Illusory Correlation)</h2>
<p><strong>解释:</strong> 虚幻相关性是指人们错误地认为两个变量之间存在关联，尤其是在他们期望发现或已经有预先的信念时。这种偏见往往基于非系统的观察或有限的证据。</p>
<p><strong>应对策略:</strong> 应对虚幻相关性的方法包括使用科学的和统计的方法来测试变量之间的关系，并保持对初步观察结果的批判性思考。</p>
<h2>影响偏差 (Impact Bias)</h2>
<p><strong>解释:</strong> 影响偏差就是我们常常夸大了将来某件事（尤其是不好的事）对我们心情的长期影响。比如，我们可能认为未来的一个失败会让我们很长时间都难过，但实际上，它的影响可能没那么持久。</p>
<p><strong>应对策略:</strong> 减少影响偏差的策略包括尝试更加客观和现实地评估未来事件的影响，以及意识到人们对负面事件的适应能力通常比预期的要强。</p>
<h2>信息偏差 (Information Bias)</h2>
<p><strong>解释:</strong> 信息偏差是指在做决策时，人们倾向于寻求过多不必要的信息，即使这些额外信息并不会改变决策的结果。</p>
<p><strong>应对策略:</strong> 对抗信息偏差的方法包括明确决策的关键因素，专注于真正重要和相关的信息，并避免因收集过多无关信息而造成决策分析瘫痪。</p>
<h2><strong>妄下结论</strong> (Jumping to Conclusions)</h2>
<p><strong>解释:</strong> <strong>妄下结论</strong>是一种认知偏差，指的是在没有充分证据的情况下快速做出判断或决定。这通常涉及过早地形成结论，而不充分考虑所有相关信息。</p>
<p><strong>应对策略:</strong> 减少跳跃结论的倾向可以通过慢下来，仔细评估所有可用信息，并在做出结论之前考虑多种可能的解释和结果。</p>
<h2>公正世界假设 (Just-World Hypothesis)</h2>
<p><strong>解释:</strong> 相信世界是公平的，发生在身上的都是应得的，把难以解释的不公平归责于受害者的报应或是源自于受害者内在本质的结果。</p>
<p><strong>应对策略:</strong> 应对公正世界假设的方法包括认识到不公正确实存在，并努力理解复杂的社会和个人因素可能导致不平等的结果。</p>
<h2>少即是好效应 (Less-Is-Better Effect)</h2>
<p><strong>解释:</strong> 少即是好效应是指在某些情况下，人们可能会认为较少的数量或较小的规模比较多或较大的更有价值，尽管按常理应该相反。</p>
<p><strong>应对策略:</strong> 对抗少即是好效应的方法包括客观评估物品或服务的实际价值，而不是仅凭数量或规模做出判断，并意识到这种偏见可能导致的不合理决策。</p>
<h2>损失厌恶 (Loss Aversion)</h2>
<p><strong>解释:</strong> 损失厌恶意味着我们对失去东西的不喜欢，比得到同样价值东西的喜欢感觉要强烈得多。比如，失去100元的烦恼比赚到100元的开心感觉更重。</p>
<p><strong>应对策略:</strong> 减少损失厌恶的影响可以通过客观分析决策的风险和回报，意识到过度关注损失可能导致的机会成本，并努力采取更加平衡的风险评估。</p>
<h2>多看效应 (Mere Exposure Effect)</h2>
<p><strong>解释:</strong> 多看效应是指人们倾向于偏好他们熟悉的事物。仅仅因为反复接触，即使没有其他正面的经历，人们也会对某些事物产生好感。</p>
<p><strong>应对策略:</strong> 应对熟悉效应的方法包括尝试接触和探索新的事物或观点，并在做出喜好或选择时意识到熟悉度可能对判断产生的影响。</p>
<h2>错误归因的唤起 (Misattribution of Arousal)</h2>
<p><strong>解释:</strong> 我们有时候会把激动、紧张或兴奋的感觉错怪到错误的原因上。比如，可能因为运动后心跳加速，却误以为是对某人有特别的感觉。</p>
<p><strong>应对策略:</strong> 了解并识别这种现象可以帮助人们更准确地理解自己的情感反应，避免因错误归因而做出误判。</p>
<h2>货币错觉 (Money Illusion)</h2>
<p><strong>解释:</strong> 货币错觉是指人们在考虑经济事务时，倾向于基于名义价值（货币的面值）而非实际购买力（调整后的价值）来做出判断。这导致人们忽视了通货膨胀或货币价值变化的影响。</p>
<p><strong>应对策略:</strong> 减少货币错觉的影响可以通过关注实际购买力和通货膨胀率，以及定期重新评估和调整个人的财务计划。</p>
<h2>道德证书效应 (Moral Credential Effect)</h2>
<p><strong>解释:</strong> 道德证书效应是指当个人在过去的行为中表现出了道德或非歧视性质时，他们可能会倾向于在未来的行为中放松自己的道德标准，感觉自己有权做出潜在的不道德或歧视性决策。</p>
<p><strong>应对策略:</strong> 应对道德证书效应的方法包括持续自我反思和批判性思考，以保持一贯的道德标准，并避免让过去的行为成为放松现在道德判断的借口。</p>
<h2>消极偏误 (Negativity Bias)</h2>
<p><strong>解释:</strong> 容易回想消极的回忆而不易回想积极的。</p>
<p><strong>应对策略:</strong> 减少消极偏见的方法包括有意识地关注和评估积极信息，以及尝试在面对负面信息时保持客观和平衡的态度。</p>
<h2>忽视概率 (Neglect of Probability)</h2>
<p><strong>解释:</strong> 忽视概率是指在做决策时，人们往往忽略或低估事件发生的实际概率。这种偏差导致人们可能高估极不可能发生的事件的风险，或低估较可能发生的事件的风险。</p>
<p><strong>应对策略:</strong> 对抗忽视概率的偏差可以通过学习和应用基本的概率理论，在做决策时仔细考虑事件的实际概率。</p>
<h2>常态偏差 (Normalcy Bias)</h2>
<p><strong>解释:</strong> 常态偏差是指人们倾向于相信事物会保持正常，即使面临潜在的灾难或危机。这导致人们在面对可能的危险时反应不足或完全不准备。</p>
<p><strong>应对策略:</strong> 减少常态偏差的影响可以通过认识到变化和危机是生活的一部分，并采取适当的预防措施和应急计划。</p>
<h2>省略偏差 (Omission Bias)</h2>
<p><strong>解释:</strong> 省略偏差是指人们倾向于认为不采取行动比采取行动而产生负面后果更为可接受或道德。这种偏差导致对被动或不作为的选择有不成比例的偏好。</p>
<p><strong>应对策略:</strong> 对抗省略偏差的方法包括认识到不作为也是一种选择，并可能带来后果。在做决策时，平等地评估行动与不行动的潜在后果。</p>
<h2>乐观偏误 (Optimism Bias)</h2>
<p><strong>解释:</strong> 乐观偏误是指人们倾向于高估自己经历积极事件的概率，同时低估经历负面事件的概率。这种偏差影响了个人对风险的评估和决策。</p>
<p><strong>应对策略:</strong> 减少乐观偏误的影响可以通过客观地考虑所有可能的结果，并准备应对不那么理想的情况。同时，学习从过去的经验中获得现实的预期。</p>
<h2>鸵鸟效应 (Ostrich Effect)</h2>
<p><strong>解释:</strong> 鸵鸟效应是指在面对可能的财务损失时，人们倾向于“埋头沙中”（象征性地避免面对问题），忽视负面的财务信息。</p>
<p><strong>应对策略:</strong> 对抗鸵鸟效应的方法包括积极面对财务问题，定期审查和管理个人的财务状况，以及在必要时寻求专业的财务建议。</p>
<h2>结果偏差 (Outcome Bias)</h2>
<p><strong>解释:</strong> 结果偏差是指人们倾向于根据一个决策的结果来评价这个决策的质量，而不是基于当时可用的信息和决策时的情况。</p>
<p><strong>应对策略:</strong> 减少结果偏差的方法包括在评估决策时考虑决策过程和当时的信息，而不仅仅是基于结果。这要求重视决策过程的合理性和完整性。</p>
<h2>过度自信效应 (Overconfidence Effect)</h2>
<p><strong>解释:</strong> 过度自信效应是指人们对自己的知识、判断能力或控制能力有过高的评估。这种过度的自信可能导致风险评估不准确和决策失误。</p>
<p><strong>应对策略:</strong> 减少过度自信的影响可以通过客观评估自己的能力和限制，并寻求他人的意见来验证自己的判断。同时，学习从失败中吸取教训，有助于形成更为现实的自我评估。</p>
<h2>感觉错觉 (Pareidolia)</h2>
<p><strong>解释:</strong> 感觉错觉是指人们倾向于在模糊或随机的刺激中看到明确的图像或听到具体的声音，如在云层中看到动物形状或听到含糊的声音中识别出熟悉的词语。</p>
<p><strong>应对策略:</strong> 认识到感觉错觉的存在有助于理解这些现象是大脑试图寻找意义和模式的结果，并非现实的反映。</p>
<h2>悲观偏见 (Pessimism Bias)</h2>
<p><strong>解释:</strong> 悲观偏见是指个人倾向于过分强调负面结果的可能性，常常低估自己实现积极结果的能力或可能性。</p>
<p><strong>应对策略:</strong> 对抗悲观偏见的方法包括客观分析情况的所有可能结果，积极寻求证据来平衡负面预期，并培养更加积极的思维方式。</p>
<h2>规划谬误 (Planning Fallacy)</h2>
<p><strong>解释:</strong> 规划谬误是指人们在估计任务所需时间、成本或资源时倾向于过于乐观，常常低估这些任务的实际需求。</p>
<p><strong>应对策略:</strong> 减少规划谬误的方法包括考虑以往类似任务的实际表现，采用更为保守的估算方法，并预留额外的时间和资源来应对可能的延误和挑战。</p>
<h2>积极结果偏见 (Positive Outcome Bias)</h2>
<p><strong>解释:</strong> 积极结果偏见是指人们倾向于过分乐观地估计自己获得积极结果的概率，忽视了可能的负面结果或风险。</p>
<p><strong>应对策略:</strong> 对抗积极结果偏见的方法包括客观评估所有可能的结果，包括负面的可能性，并准备应对不同情况的策略。</p>
<h2>积极效应；消极效应 (Positivity Effect; Negativity Effect)</h2>
<p><strong>解释:</strong> 积极效应指的是人们随着年龄增长倾向于关注更积极的信息。相对的，消极效应指在某些情境中，负面信息对人们的影响比正面信息更强。</p>
<p><strong>应对策略:</strong> 了解这些效应的存在有助于在分析信息和做决策时保持平衡，确保不仅仅基于情绪反应做出判断。</p>
<h2>购后合理化 (Post-Purchase Rationalization)</h2>
<p><strong>解释:</strong> 购后合理化是指在购买产品或服务后，消费者倾向于为自己的选择找出正当理由，即使存在明显的缺点或后悔的理由。</p>
<p><strong>应对策略:</strong> 对抗购后合理化的方法包括在购买前仔细评估产品的优缺点，并在购后诚实地评价其性能和价值，以避免自我欺骗。</p>
<h2>创新偏好 (Pro-Innovation Bias)</h2>
<p><strong>解释:</strong> 创新偏好是指人们倾向于过分积极评价新技术或创新的效用和效果，忽视其潜在的限制或不足之处。</p>
<p><strong>应对策略:</strong> 减少创新偏好的影响可以通过客观评估新技术或创新的实际表现和潜在风险，并考虑是否真正满足需要或改进现状。</p>
<h2>伪确定性效应 (Pseudocertainty Effect)</h2>
<p><strong>解释:</strong> 伪确定性效应是指在决策过程中，当某个选择被感知为“无风险”时，人们倾向于更加偏好这个选项，即使实际上风险仍然存在。</p>
<p><strong>应对策略:</strong> 对抗伪确定性效应的方法包括认识到没有绝对无风险的决策，仔细评估所有选项的潜在风险，并保持对不确定性的理性态度。</p>
<h2><strong>对抗心理</strong> (Reactance)</h2>
<p><strong>解释:</strong> <strong>对抗心理</strong>是指当个人感觉到他们的自由选择受到威胁或限制时，可能产生反抗心理，从而反对或违背指导或建议。</p>
<p><strong>应对策略:</strong> 减少对抗心理的方法包括提供选择和自主权，以及在提出建议或规定时考虑个人的感受和反应。</p>
<h2>反应性贬值 (Reactive Devaluation)</h2>
<p><strong>解释:</strong> 反应性贬值是指人们倾向于对来自对立方或竞争对手的提议或观点持负面态度，即使这些提议本身是合理的。</p>
<p><strong>应对策略:</strong> 减少反应性贬值的影响可以通过客观评估所有提议的内容，而不是仅基于提出者的身份。努力保持公正和开放的态度，即使在对抗性的情境中。</p>
<h2>近期错觉 (Recency Illusion)</h2>
<p><strong>解释:</strong> 近期错觉是指人们倾向于认为自己最近注意到的语言或行为模式是新现象，即使这些模式在此之前已长期存在。</p>
<p><strong>应对策略:</strong> 对抗近期错觉的方法包括进行历史性或长期性的研究，以确认某一现象是否真的是新出现的，或者只是自己最近才开始注意到。</p>
<h2>自制偏差 (Restraint Bias)</h2>
<p><strong>解释:</strong> 自制偏差是指人们倾向于高估自己抵抗诱惑和维持自制力的能力。这可能导致人们过于自信地置身于诱惑较多的环境中，增加了失败的风险。</p>
<p><strong>应对策略:</strong> 减少自制偏差的影响可以通过客观评估自己的自制力，并采取预防措施避免过度接触诱惑或压力大的环境。</p>
<h2>韵为理由效应 (Rhyme as Reason Effect)</h2>
<p><strong>解释:</strong> 韵为理由效应是指人们倾向于认为押韵或是有韵律的陈述比非押韵的陈述更为真实或有说服力。</p>
<p><strong>应对策略:</strong> 对抗这一效应的方法包括关注陈述的实际内容和逻辑，而不是它们的形式或押韵的特性，并基于事实和证据来评估陈述的真实性。</p>
<h2>风险补偿 (Risk Compensation)</h2>
<p><strong>解释:</strong> 风险补偿是指当人们感觉到安全措施已经实施时，可能会采取更冒险的行为，因为他们感觉到的风险较低。</p>
<p><strong>应对策略:</strong> 减少风险补偿的影响可以通过增强风险意识和责任感，即使在看似更安全的环境中也保持谨慎。</p>
<h2>选择性注意 (Selective Attention)</h2>
<p><strong>解释:</strong> 选择性注意是指人们倾向于关注符合自己兴趣、信念或当前需求的信息，同时忽略其他信息。</p>
<p><strong>应对策略:</strong> 对抗选择性注意的方法包括努力接触和考虑不同于自己现有观点的信息，并有意识地拓宽关注的范围，以获得更全面的信息。</p>
<h2>赛美尔维斯反射 (Semmelweis Reflex)</h2>
<p><strong>解释:</strong> 赛美尔维斯反射是指人们对新证据或新知识的自动拒绝，特别是当这些新信息与既定的规范、信仰或偏见相冲突时。</p>
<p><strong>应对策略:</strong> 应对赛美尔维斯反射的方法包括保持开放的态度，愿意接受和考虑新信息，以及通过持续的学习和适应来挑战和更新自己的观念。</p>
<h2>社交比较偏差 (Social Comparison Bias)</h2>
<p><strong>解释:</strong> 社交比较偏差是指人们倾向于通过与他人的比较来评价自己的能力或意见，这可能导致对自己或他人的能力和价值的扭曲评价。</p>
<p><strong>应对策略:</strong> 减少社交比较偏差的方法包括专注于个人的目标和成就，而不是与他人的比较，并培养自尊和自我接受。</p>
<h2>现状偏误 (Status Quo Bias)</h2>
<p><strong>解释:</strong> 现状偏误是指人们倾向于维持现状，抵制变化，即使改变可能带来更好的结果。</p>
<p><strong>应对策略:</strong> 对抗现状偏误可以通过评估改变带来的潜在利益，并勇于尝试新的方法或想法。同时，了解变化的必要性和可能的长远好处。</p>
<h2>刻板印象 (Stereotyping)</h2>
<p><strong>解释:</strong> 刻板印象是指人们基于简化的假设或固定观念来归纳个体或群体的特征，这可能导致对个体的误解和不公正待遇。</p>
<p><strong>应对策略:</strong> 减少刻板印象的影响可以通过开放地接受和了解多样性，避免以群体归类代替个人评估，并批判性地审视自己的假设。</p>
<h2>斯德哥尔摩综合症 (Stockholm Syndrome)</h2>
<p><strong>解释:</strong> 斯德哥尔摩综合症是指人质或虐待受害者对其绑匪或虐待者产生同情、忠诚或亲密感的心理现象。</p>
<p><strong>应对策略:</strong> 理解斯德哥尔摩综合症的复杂性有助于更好地支持和帮助受害者。专业的心理咨询和治疗对于处理这种复杂的情感绑定至关重要。</p>
<h2>亚加性效应 (Subadditivity Effect)</h2>
<p><strong>解释:</strong> 亚加性效应是指人们在评估一组部分的总和时，倾向于估计的值小于当这些部分单独评估并加总的值。这通常发生在对事件集合的概率评估中。</p>
<p><strong>应对策略:</strong> 减少亚加性效应的影响可以通过细致地评估每个部分，并在做出总体评估时考虑到所有相关部分。</p>
<h2>主观验证 (Subjective Validation)</h2>
<p><strong>解释:</strong> 主观验证是指人们倾向于接受那些符合自己信念或期望的信息为真实，即使这些信息没有客观的证据支持。</p>
<p><strong>应对策略:</strong> 对抗主观验证的方法包括批判性地评估信息来源的可靠性，寻找客观证据来支持或反驳这些信息，并保持对不同观点的开放性。</p>
<h2>沉没成本谬误 (Sunk Cost Fallacy)</h2>
<p><strong>解释:</strong> 沉没成本谬误是指人们在决策时考虑了已经发生且不可回收的成本，即使这些成本在当前和未来的决策中不再相关。</p>
<p><strong>应对策略:</strong> 减少沉没成本谬误的影响可以通过专注于未来的收益和成本，而不是过去已经发生的损失，并在做决策时保持客观和理性。</p>
<h2>幸存者偏差 (Survivorship Bias)</h2>
<p><strong>解释:</strong> 幸存者偏差是指人们倾向于只关注成功的案例，而忽视了那些失败的案例。这可能导致对成功的原因和概率有一个不准确的评估。</p>
<p><strong>应对策略:</strong> 减少幸存者偏差的方法包括考虑所有相关案例（包括失败的案例）来进行全面的分析，并从失败中寻找教训。</p>
<h2>节时偏差 (Time-Saving Bias)</h2>
<p><strong>解释:</strong> 节时偏差是指人们倾向于高估通过加快完成某项活动所节省的时间，特别是当这项活动占用的时间较少时。</p>
<p><strong>应对策略:</strong> 对抗节时偏差的方法包括实际评估不同速度完成任务所节省的时间，并考虑在时间管理和规划中采取更现实和合理的方法。</p>
<h2>单位偏差 (Unit Bias)</h2>
<p><strong>解释:</strong> 单位偏差是指人们倾向于按照单个单位或标准份量进行消费，而不是基于实际的饥饿程度或需求，这可能导致过度消费。</p>
<p><strong>应对策略:</strong> 减少单位偏差的影响可以通过自我意识，识别何时受到单位大小的影响，并根据实际需求调整消费量。</p>
<h2>熟悉路效应 (Well Travelled Road Effect)</h2>
<p><strong>解释:</strong> 熟悉路效应是指人们倾向于认为他们经常走的路比实际上更短或更快。这种偏见可能基于对熟悉路径的认知扭曲。</p>
<p><strong>应对策略:</strong> 对抗熟悉路效应的方法包括客观地评估不同路线的实际时间和距离，并考虑在规划旅程时使用客观的导航工具。</p>
<h2>整体唯一效应 (Whole Only Effect)</h2>
<p><strong>解释:</strong> 整体唯一效应是指在评估一组对象时，人们倾向于忽视组成部分的价值，只关注整体的价值。</p>
<p><strong>应对策略:</strong> 减少整体唯一效应的影响可以通过细致地评估每个组成部分的价值，并在做出决策时考虑到各个部分的综合作用。</p>
<h2>零风险偏差 (Zero-Risk Bias)</h2>
<p><strong>解释:</strong> 零风险偏差是指人们倾向于过分偏好那些能消除风险的选项，即使这些选项的总体安全性不如降低但不完全消除风险的选项。</p>
<p><strong>应对策略:</strong> 对抗零风险偏差的方法包括理解完全消除风险的不可能性，并评估不同选项的总体风险与收益。</p>
<h2>零和启发式 (Zero-Sum Heuristic)</h2>
<p><strong>解释:</strong> 零和启发式是指人们倾向于错误地认为一个情境是“零和”的，即一个人的得失必然等于另一个人的失得。这忽视了可能的互惠互利情况。</p>
<p><strong>应对策略:</strong> 减少零和启发式的影响可以通过认识到多种情境可能存在共赢的可能性，并在决策时考虑合作与共同增益的机会。</p>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2023-12-22T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[《富爸爸，穷爸爸》TL;DR]]></title>
        <id>https://lainbo.dev/posts/summary-rich-dad-poor-dad/</id>
        <link href="https://lainbo.dev/posts/summary-rich-dad-poor-dad/"/>
        <updated>2023-12-16T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[《富爸爸，穷爸爸》的太长不看版，富人和穷人对待金钱的差别]]></summary>
        <content type="html"><![CDATA[<p>书籍信息：<a href="https://book.douban.com/subject/1033778/">豆瓣读书</a></p>
<p>本文是对《富爸爸，穷爸爸》一书的归纳性总结，书是好书但是里面的故事实在是太多了，于是我将里面的干货提取出来做一个省流版本。再次提示，这只是书中内容的总结，而不是投资理财建议，下文中所有的“我”，指作者本人。</p>
<h2>停止无用功</h2>
<p>当你发现自己陷入困境时，最好的办法就是停下来，不要再继续使情况变得更糟，而不是钻牛角尖或是撞到南墙才回头。</p>
<h2>金钱是你的无休无止的员工</h2>
<p>一旦你的资金投入到资产中，就应该让它永远留在那里。</p>
<p>设想一下：一旦资金成为你的资产，它就变成了你的员工。金钱最大的优势在于它能够不分昼夜地工作，甚至能够为你的后代持续创造价值。</p>
<h2>释放我们的潜能</h2>
<p>我们每个人都拥有巨大的潜能，并且都有各自的优势。但往往我们被自我怀疑所困扰。真正阻碍我们前进的，并非是技术知识的缺乏，而是缺少自信心。</p>
<h2>五大财务障碍</h2>
<p>即便对财务有深刻理解的人，也可能因为五个关键原因而未能建立起能够带来大量现金流的资产。这五大障碍包括：恐惧、愤世嫉俗、懒惰、坏习惯和傲慢。</p>
<h2>怀疑，让我们停滞不前</h2>
<p>我们总是在担忧，“如果我投资之后经济突然崩溃怎么办？”或者周围的朋友和亲人会提醒我们自己的不足，他们会说：“如果这真的是个好主意，为什么还没人去做呢？”</p>
<p>这些充满怀疑的话语往往让我们感到压力。</p>
<h2>重视分析而非批评</h2>
<p>在股市中(指作者所在国家的股市)，我常听到人们说：“我不想亏钱。”但谁会喜欢亏钱呢？他们之所以没赚到钱，是因为他们害怕亏损。</p>
<p>这些人没有进行深入分析，而是对股市这一强大的投资工具(指作者所在国家的股市，领会精神即可)选择了闭上心门。</p>
<h2>想要变富有的原因？</h2>
<p>当人们问我想要变富有的原因时，我告诉他们，这是深层情感上的“想要”和“不想要”的结合。</p>
<h2>小心听信贫穷或恐惧的声音</h2>
<p>别听那些贫穷或畏缩的人的话。我有这样的朋友，他们对于生活中的任何事情总是过于悲观。在金钱和投资方面，他们总是过度担忧，“天要塌下来了！” 他们总能找出各种理由来否定一切。</p>
<p>但那些轻信悲观消息的人，同样也是过于焦虑。</p>
<h2>先为自己着想</h2>
<p>自律的重要性 如果你无法控制自己，那就不要想着致富。赚钱却又挥霍无度是没有任何意义的。</p>
<h2>如何有效地优先考虑自己</h2>
<ol>
<li>避免陷入大额债务。减少开销，先建立资产，然后再考虑购买大房子或昂贵的汽车。困于“老鼠赛跑”是不明智的选择。</li>
<li>当你资金紧张时，不要动用储蓄或投资，让压力激发你的财务创新思维，找出赚更多钱的新方法，然后再支付账单。这样，你不仅提高了赚钱的能力，也增强了你的财务智慧。</li>
</ol>
<h2>富人的智慧</h2>
<p>富人明白，储蓄的目的是为了创造更多的财富，而不是用来支付日常账单</p>
<h2>选择你的榜样</h2>
<p>选择你的英雄：神话的力量</p>
<p>拥有榜样能激发我们深藏的潜能。</p>
<p>“如果他们能成功，我也同样能做到。”</p>
<h2>你的世界是你的镜子</h2>
<p>“的确，你的世界只是你自身的反映。”</p>
<h2>关于金钱的教育和智慧至关重要</h2>
<p>早点开始。读一本书。参加研讨会。实践操作。从小事做起。我用5000美元的现金在不到六年时间内将其转化为每月带来5000美元现金流的百万美元资产。但我的学习是从小开始的。我鼓励你去学习，因为它并不难。事实上，一旦你掌握了它，一切都会变得很简单。</p>
<h2>被动收入和投资组合收入</h2>
<p>富爸爸说“富人不为了钱而工作，而是让钱为他们工作”时，他指的是被动收入和投资组合收入。</p>
<p>被动收入通常来源于房地产投资(指作者所在国家的房地产)。而投资组合收入则来自于股票、债券(指作者所在国家的股票、债券)等金融资产。</p>
<p>投资组合收入是让比尔·盖茨成为世界首富的关键，而不是普通的工资收入。</p>
<h2>致富的秘诀</h2>
<p>富爸爸常说：“变得富裕的关键在于能够尽快将工资收入转变为被动收入或投资组合收入。”</p>
<p>他还会说：“对工资收入的税收最高，而被动收入的税收最低。这就是为什么你要让你的钱更努力地为你工作的另一个原因。政府(指作者所在国家的政府)对你辛苦挣得的收入征税要比对你的钱努力赚来的收入征税多。”</p>
<h2>不要先付给其他人</h2>
<p>不要成为那种总是优先支付给他人的人。</p>
<h2>失败只是成功之前的一步</h2>
<p>在任何人的生命中，成功到来之前，他都会遇到许多暂时性的挫折，甚至是失败。</p>
<p>当挫折降临时，最简单也是最常见的反应是放弃。这正是大多数人的选择。</p>
<p>但要记住，当失败出现时，意味着成功已经不远了🔥。</p>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2023-12-16T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Chat GPT最佳实践 [译]]]></title>
        <id>https://lainbo.dev/posts/chatgpt-best-practice/</id>
        <link href="https://lainbo.dev/posts/chatgpt-best-practice/"/>
        <updated>2023-10-20T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[在这个AI井喷式爆发的时代，谁和GPT做朋友，谁就遥遥领先]]></summary>
        <content type="html"><![CDATA[<p>在 2022 年 12 月，我注册了我的第一个 Chat GPT 账号，到了 2023 年 10 月，国内无数厂商都发布了自己的 AI 产品，这表明AI这个方向短期内一定是正确的。AI 技术具有更加明确的实际应用价值。AI 可以通过机器学习和自然语言处理等技术，帮助人们解决实际问题，提高工作效率和生活质量。</p>
<p>根据<a href="https://www.superclueai.com/">SuperCLUB的排行榜</a>和<a href="https://lmsys.org/blog/2023-12-07-leaderboard/">聊天机器人竞技场</a>，我们可以看到Chat GPT的GPT-4几乎在各方面达到了优秀的水准。所以可以下一个不负责任的结论: <strong>谁和GPT做朋友，谁就遥遥领先 !</strong></p>
<p><strong>本文内容译自<a href="https://platform.openai.com/docs/guides/prompt-engineering/six-strategies-for-getting-better-results">Chat GPT官方 - Six strategies for getting better results</a>，我会用大白话的方式介绍这些技巧</strong></p>
<hr />
<p>这份指南给你提供了如何从 GPT 获得更佳效果的一些方法和技巧。有些技巧可以组合起来用，以达到更好的效果，所以不妨大胆尝试，找到最适合你的方法。</p>
<p>需要特别提醒的是，某些示例只适用于我们最强大的模型——gpt-4。如果你还没有机会用这个模型，可以考虑加入等待名单。一般来说，如果你发现一个 GPT 模型不能完成某个任务，而手头又有更强大的模型，那就值得用这个强大的模型再试一次。</p>
<p>要想获得更好的结果，你可以试试以下策略：</p>
<h2>一、写清晰的指令</h2>
<p>GPT 并不能读懂你的心思。</p>
<p>如果你觉得输出结果太长，就明确要求它给出简短的答复。</p>
<p>如果觉得输出结果太过简单，就要求它用更专业的语言来回答。</p>
<p>如果你对输出格式有特殊要求，最好能给出示例。</p>
<p>GPT 对你的需求了解得越清晰，提供给你的答案就越可能是你想要的。</p>
<p><strong>你可以用以下这些实用技巧来提高 GPT 的准确度和效用：</strong></p>
<h3><strong>你说的细节越多，GPT回答的越好</strong></h3>
<p>要想从 GPT 那里得到你真正需要的答案，细节是关键。GPT并不能读懂你的心思，因此在提问时加入所有相关的信息和背景是至关重要的。</p>
<table>
<thead>
<tr>
<th><strong>❌较差的提问方式</strong></th>
<th><strong>✅更好的提问方式</strong></th>
</tr>
</thead>
<tbody>
<tr>
<td>如何在 Excel 中加数字？</td>
<td>我应该如何在 Excel 中自动累加一行美元金额，并将所有的累加结果显示在一个名为 "Total" 的列中？</td>
</tr>
<tr>
<td>谁是总统？</td>
<td>2021年墨西哥的总统是谁？墨西哥多久举行一次总统选举？</td>
</tr>
<tr>
<td>编写用于计算斐波那契数列的代码。</td>
<td>请用 TypeScript 写一个用于高效计算斐波那契数列的函数，并在代码中详细注释各部分的功能和原因。</td>
</tr>
<tr>
<td>总结会议记录。</td>
<td>请用一个段落总结会议内容，然后用 Markdown 列出各个发言人和他们的关键观点，最后列出由发言人建议的下一步或行动项（如果有的话）。</td>
</tr>
</tbody>
</table>
<h3><strong>角色扮演</strong></h3>
<p>设定模型的“角色”，你可以要求模型以某个特定角色或风格来回应你。在与 GPT 模型互动时，你可以通过系统设定来设定模型的回复风格或角色。</p>
<p>例如，如果你希望模型在帮你写作时加入幽默元素，你可以明确指出。</p>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>系统设定</td>
<td>当我需要写作帮助时，你的回复应该是一个每段都至少包含一个笑话或幽默评论的文档。</td>
</tr>
<tr>
<td>用户输入</td>
<td>请帮我写一封感谢信给我的钢螺栓供应商，感谢他们在极短的通知内准时交货，这让我们能够完成一个重要的订单。</td>
</tr>
</tbody>
</table>
<h3><strong>使用分隔符</strong></h3>
<p>在与模型互动时，<strong>不要让GPT猜测你的话中哪一段是指令，哪一段是材料</strong></p>
<p>使用分隔符（如三重引号、XML标签、段落标题等）来明确标识输入中的不同部分，有助于GPT按照不同的方式处理各个文本区块。</p>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>用户输入</td>
<td>你需要担任翻译，你要翻译的内容是:&lt;br&gt;"""这里是用户输入的"""</td>
</tr>
</tbody>
</table>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>系统设定</td>
<td>您将收到一对关于同一主题的文章（用 XML 标记分隔）。首先总结每篇文章的论点。然后指出哪篇文章的论点更好，并解释原因。</td>
</tr>
<tr>
<td>用户输入</td>
<td>&lt;article&gt;在此插入第一篇文章&lt;/article&gt;&lt;br&gt;&lt;article&gt;在此插入第二篇文章&lt;/article&gt;</td>
</tr>
</tbody>
</table>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>系统设定</td>
<td>你将得到一个论文摘要和一个建议的标题。论文标题应该让读者很好地了解论文的主题，但也应该引人注目。如果标题不符合这些标准，请提供5个备选方案。</td>
</tr>
<tr>
<td>用户输入</td>
<td>摘要：在这里插入摘要&lt;br&gt;标题：在这里插入标题</td>
</tr>
</tbody>
</table>
<p>在执行像这样的直接任务时，使用界定符可能并不会影响结果的质量。然而，任务的复杂度越高，就越需要清晰地定义任务的细节。不要让GPT模型费劲去解析你的问题是什么。</p>
<h3><strong>设定好你想要的解题步骤</strong></h3>
<p>对于某些任务，最好能通过明确列出一系列步骤来指定它们。这样做能让模型更容易理解并执行这些步骤。</p>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>系统设定</td>
<td>按照以下逐步说明来回应用户的输入。&lt;br&gt;- 第一步，用户会使用三重引号提供一段文本，你需要用“摘要：”作为前缀，将这段文本总结为一句话。&lt;br&gt;- 第二步，在第一步的摘要后加上前缀“翻译：”，并将其翻译成西班牙语。</td>
</tr>
<tr>
<td>用户输入</td>
<td>"""输入你的文本"""</td>
</tr>
</tbody>
</table>
<h3><strong>多给GPT举几个例子</strong></h3>
<p>在大多数情况下，你无法写出非常通用的，适用于所有问题的通用提示词。然而，但有时候，提供一个例子会更加简单。例如，你很难描述一种语言风格，但是可以扔给他几个例子，他就能学会这种风格，这种方法被称为“少样本”提示。</p>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>系统设定</td>
<td>用一致的风格回复我</td>
</tr>
<tr>
<td>用户输入</td>
<td>告诉我什么是耐心</td>
</tr>
<tr>
<td>系统回复</td>
<td>最深邃的河谷源于一个不起眼的泉眼；&lt;br&gt;最宏伟的交响乐源自一个音符；&lt;br&gt;最复杂的织锦始于一根孤线。</td>
</tr>
<tr>
<td>用户输入</td>
<td>告诉我什么是海洋</td>
</tr>
<tr>
<td>系统回复</td>
<td><em>此时会GPT会按照上面的格式回答你的这个问题</em></td>
</tr>
</tbody>
</table>
<h3><strong>控制输出长度</strong></h3>
<p>你可以指定模型输出内容的长度，无论是以单词、句子、段落或是列表形式。</p>
<p>但要注意2点</p>
<ul>
<li>如果你指定了特定的单词数量，模型可能<strong>无法</strong>非常精确地达到这个要求。</li>
<li>这里说的单词数其实指的是Token数量，换成汉字近似<strong>是2倍</strong>的关系，比如你要生成50个汉字，你需要告诉GPT需要生成100字的内容，这大概能输出50个中文汉字，具体计数可以在Open AI官方的<a href="https://platform.openai.com/tokenizer">Tokenizer</a>进行计算。</li>
</ul>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>用户输入</td>
<td>用大约50个字来概括下面的原文</td>
</tr>
</tbody>
</table>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>用户输入</td>
<td>用2段话概括下面的文字</td>
</tr>
</tbody>
</table>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>用户输入</td>
<td>用3个要点概括下面的文字</td>
</tr>
</tbody>
</table>
<h2>二、提供参考文本</h2>
<h3>要求GPT仅使用提供的材料作答</h3>
<p>如果你有一份可靠的参考文本，你可以指示模型根据这份文本来回答问题。这样，模型的回答将更准确和相关。</p>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>系统设定</td>
<td>请利用三重引号区分的文章内容来解答问题。如果在文章里找不到答案，请告诉我“我找不到答案。”</td>
</tr>
<tr>
<td>用户输入</td>
<td>"""文章粘贴在这里"""&lt;br&gt;问题: 问题写在这里</td>
</tr>
</tbody>
</table>
<h3>要求引用提供的材料</h3>
<p>如果输入已经包含了与问题相关的文档，就可以明确要求模型在其回答中给出相关的引用。这种方式的优势是，你可以很轻松的验证GPT的回答和提供的材料之间的关系。</p>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>系统设定</td>
<td>你将收到一个由三重引号分隔的文档和一个问题。你的任务是仅使用提供的文档来回答问题，并引用用于回答问题的文档中的段落。如果文档不包含回答此问题所需的信息，则告诉我："信息不足"。如果问题的在材料中有答案，必须使用以下格式来引用相关段落（{"引用": …}）</td>
</tr>
<tr>
<td>用户输入</td>
<td>"""文章粘贴在这里"""&lt;br&gt;问题: 问题写在这里</td>
</tr>
</tbody>
</table>
<h2>三、复杂任务拆解成子任务</h2>
<h3>使用意图分类，来找到最切题的分类</h3>
<p>可能不是那么容易理解，举个例子，想象一下如果要让GPT充当一个电商客服，如何面对用户奇奇怪怪的问题呢? 我们不⼀定要写⼀个巨长的prompt来应对用户的所有回答。我们可以：设定好意图分类，再根据分类来调用prompt。</p>
<p>这种方式的优点是，每个用户查询只会包含执行下一任务阶段所需要的指令，这可能会降低错误率。因为运行更大的提示文本会增加成本，这种方法也可能更经济实惠。例如，在一个客户服务应用中，用户的查询可以按照一些有用的方式进行分类。</p>
<p>下面我们假设用GPT充当一个运营商客服</p>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>系统设定</td>
<td>您将收到客户服务询问。将每个查询分为一级类别和二级类别。以 json 格式提供输出，并标明键：主要类别和次要类别。&lt;br&gt;&lt;br&gt;主要类别：账单、技术支持、账户管理或一般查询&lt;br&gt;&lt;br&gt;计费二级类别：&lt;br&gt;- 退订或升级&lt;br&gt;- 添加付款方式&lt;br&gt;- 收费解释&lt;br&gt;- 对收费提出异议&lt;br&gt;&lt;br&gt;技术支持 二级类别：&lt;br&gt;- 故障排除&lt;br&gt;- 设备兼容性&lt;br&gt;- 软件更新&lt;br&gt;&lt;br&gt;账户管理 二级类别&lt;br&gt;- 密码重置&lt;br&gt;- 更新个人信息&lt;br&gt;- 关闭账户&lt;br&gt;- 账户安全&lt;br&gt;&lt;br&gt;一般查询 二级类别：&lt;br&gt;- 产品信息&lt;br&gt;- 定价&lt;br&gt;- 反馈信息&lt;br&gt;- 与人工对话询。</td>
</tr>
<tr>
<td>用户输入</td>
<td>我需要让我的网络恢复正常。</td>
</tr>
</tbody>
</table>
<p>这里是：先识别了用户意图，把用户的问题分到“故障排除”类别里面。然后基于这个细的分类，再
向模型提供⼀组更具体的指令，从里面选。</p>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>系统设定</td>
<td>您将接到需要在技术支持环境中排除故障的客户服务咨询。通过以下方式帮助用户&lt;br&gt;- 要求用户检查所有连接路由器的电缆是否连接好。请注意，随着时间的推移，电缆松动是很常见的。&lt;br&gt;- 如果所有电缆都已连接，但问题仍然存在，请询问用户使用的路由器型号。&lt;br&gt;- 现在，您要告诉他们如何重启设备：&lt;br&gt;- 如果型号是 MTD-327J，建议他们按下红色按钮并保持 5 秒钟，然后等待 5 分钟再测试连接。&lt;br&gt;- 如果型号是 MTD-327S，建议他们拔下插头并重新插入，然后等待 5 分钟再测试连接。&lt;br&gt;- 如果客户在重启设备并等待 5 分钟后问题仍然存在，则通过输出 {"请求 IT 支持"}将其连接到 IT 支持。&lt;br&gt;- 如果用户开始询问与此主题无关的问题，则确认他们是否愿意结束当前关于故障排除的聊天，并根据以下方案对其请求进行分类：&lt;br&gt;&lt;此处插入上面的主要/二级分类方案&gt;。</td>
</tr>
<tr>
<td>用户输入</td>
<td>我需要让我的网络恢复正常。</td>
</tr>
</tbody>
</table>
<p>模型被设置为输出特定的字符串来标示对话状态的变化。这样做使得整个系统能够作为一个状态机运行，在这个状态机中，不同的状态会触发不同的指令集。通过维护这些状态、确定每个状态下应用的指令，以及在需要的情况下，设定从一个状态到另一个状态的转换规则，我们可以更精确地控制用户体验，这在没有结构的情况下是很难实现的。</p>
<h3>如果整体对话比较长，自己总结一下对话</h3>
<p>GPT模型有一个固定的上下文长度，这意味着用户和模型之间的长对话不能一直持续下去。有几种解决方案可以解决这个问题。</p>
<ol>
<li>在对话达到某个长度阈值时触发一个总结，这个总结可以作为系统消息的一部分。</li>
<li>在对话过程中持续异步地总结先前的交流内容。</li>
<li>一种更高级的方法是动态地选取与当前查询最相关的之前的对话内容。这最后一种方法与“<a href="https://platform.openai.com/docs/guides/gpt-best-practices/strategy-use-external-tools">使用基于嵌入的搜索来实现有效的知识检索</a>”的策略有关。</li>
</ol>
<h3>分段总结长文档，并通过递归方式构建完整摘要</h3>
<p>由于GPT模型有固定的上下文长度限制，单次的查询不能用来总结超过这个长度的文本。但如果你需要总结一个非常长的文档，比如一本书，你可以采用分段总结的方法。你可以首先分别对每一部分进行总结，然后将这些小的总结拼接并再次进行总结，<strong>这样就形成了“总结的总结”</strong>。这个过程可以递归地进行，直到整个长文本被总结完毕。如果后面的内容需要依赖前面的信息，那么在总结的时候可以加入前面内容的“持续性总结”。这种用于长文本总结的方法已经在之前使用GPT-3的OpenAI研究中得到了验证。</p>
<h2>四、给GPT思考的时间</h2>
<p>有时候，明确地让模型从最基础的原则出发进行推理会得到更好的结果。比如，如果我们想让模型评估一个学生解决数学问题的方法，最直接的方式是直接问模型这个学生的解法是否正确。然而，如果模型从基础原则出发进行推理，可能会得到更全面和准确的评估。</p>
<p>❌错误的使用方式</p>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>系统设定</td>
<td>判断学生的解答是否正确。</td>
</tr>
<tr>
<td>用户输入</td>
<td>问题陈述：我正在建造一个太阳能装置，我需要解决财务问题。&lt;br&gt;- 土地价格为100美元/平方英尺&lt;br&gt;- 我能以250美元/平方英尺的价格买到太阳能电池板&lt;br&gt;- 我谈妥了一份维护合同，每年固定费用为10万美元，每平方英尺另加10美元&lt;br&gt;作为平方英尺数量的函数，第一年运营的总成本是多少。&lt;br&gt;&lt;br&gt;学生的解决方案：设x是装置的大小，单位为平方英尺。&lt;br&gt;1.土地成本：100倍&lt;br&gt;2.太阳能电池板成本：250倍&lt;br&gt;3.维护费用：100,000+100倍&lt;br&gt;总成本：100x+250x+100,000+100x=450x+100,000</td>
</tr>
<tr>
<td>系统回复</td>
<td><em>学生的解答是正确的</em></td>
</tr>
</tbody>
</table>
<p>但实际上学生的解并不正确！我们可以通过提示模型先生成自己的解决方案，让模型成功注意到这一点。</p>
<p>✅正确的使用方式</p>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>系统设定</td>
<td>首先想出你自己解决问题的办法。然后将您的解决方案与学生的解决方案进行比较，并评估学生的解决方案是否正确。在你自己做完这道题之前，不要决定学生的解答是否正确。</td>
</tr>
<tr>
<td>用户输入</td>
<td>(和上面一样，不再重复)</td>
</tr>
<tr>
<td>系统回复</td>
<td>设 x 为安装面积（平方英尺）。&lt;br&gt;1.土地成本：100x&lt;br&gt;2.太阳能电池板成本：250x&lt;br&gt;3.维护成本：100,000 + 10x&lt;br&gt;总成本：100x + 250x + 100,000 + 10x = 360x + 100,000&lt;br&gt;该学生的解决方案不正确。他们在计算维护成本时出了错，用了 100x，而不是 10x。正确的第一年运营总成本是 360x + 100,000。</td>
</tr>
</tbody>
</table>
<h3><strong>使用内心独白或一系列查询来隐藏模型的推理过程</strong></h3>
<p>在解答特定问题之前，模型有时需要进行详尽的推理，比如上面那种问题。</p>
<p>但在某些场景下，这种推理过程可能不宜与用户共享。比如，在教育辅导应用中，如果模型的推理过程被展示出来，可能会暴露出答案，影响学生自己解决问题。</p>
<p>为了解决这个问题，可以使用“内心独白”这一策略。意思就是把那些不让用户看到的内容，隐藏的放到一个结构化的格式里，然后，在将这些信息展示给用户之前，可以先进行解析，只展示其中的一部分。</p>
<p>我们用一个教育辅导作为例子展示应该如何使用这个技巧</p>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>系统设定</td>
<td>请按照以下步骤回答用户询问。&lt;br&gt;第 1 步 - 首先自己想出解决问题的办法。不要依赖学生的解决方案，因为它可能是不正确的。将这一步的所有工作都括在三层引号（""""）内。&lt;br&gt;第 2 步 - 将您的解法与学生的解法进行比较，并评估学生的解法是否正确。将此步骤的所有作业用三引号 ("""") 括起来。&lt;br&gt;第 3 步 - 如果学生出错了，确定在不泄露答案的情况下，可以给学生什么提示。将此步骤中的所有作业用三引号（""""）括起来。&lt;br&gt;第 4 步 - 如果学生犯了错误，则将上一步的提示提供给学生（不带三重引号）。不要写 "第 4 步--......"，而是写 "提示："。</td>
</tr>
<tr>
<td>用户输入</td>
<td>问题陈述：&lt;题目描述&gt;&lt;br&gt;学生解题方式：&lt;填写学生的解题方式&gt;</td>
</tr>
</tbody>
</table>
<p>接下来，我们可以让模型利用所有可用信息来评估学生解法的正确性。</p>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>系统设定</td>
<td>你是一名数学辅导员。如果学生出错了，以不透露答案的方式向学生提供提示。如果学生没有出错，只需给他们一个鼓励性的评价。</td>
</tr>
<tr>
<td>用户输入</td>
<td>问题陈述："""&lt;插入问题陈述&gt;"""&lt;br&gt;你的解决方案"""&lt;插入模型生成的解决方案&gt;"""&lt;br&gt;学生的解决方案："""&lt;插入学生的解决方案&gt;"""&lt;br&gt;分析："""&lt;插入上一步生成的模型分析&gt;""”</td>
</tr>
</tbody>
</table>
<h3>最后向GPT确认有没有遗漏</h3>
<p>当使用模型从某个资料中筛选与特定问题相关的摘要时，模型需要在列出每个摘要后判断是否继续或停止。</p>
<p>如果源资料非常庞大，模型通常会过早地停止，导致遗漏一些相关的内容。</p>
<p>在这种情况下，通常可以通过后续的查询来提醒模型，找出先前遗漏的相关摘要，以获得更准确的结果，你只需要在GPT认为完成工作后，这样提问一下他</p>
<table>
<thead>
<tr>
<th></th>
<th></th>
</tr>
</thead>
<tbody>
<tr>
<td>用户输入</td>
<td>还有更多相关摘录吗？注意不要重复摘录。还要确保摘录内容包含了所有相关上下文--换句话说，不要摘录缺少重要上下文的小片段。</td>
</tr>
</tbody>
</table>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2023-10-20T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[nvm-desktop的使用]]></title>
        <id>https://lainbo.dev/posts/use-nvm-desktop/</id>
        <link href="https://lainbo.dev/posts/use-nvm-desktop/"/>
        <updated>2023-09-27T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[在用过一些Node版本管理工具后, 这似乎是一个最好的解决方案。]]></summary>
        <content type="html"><![CDATA[<p>在用过windows-nvm和volta后, 又发现了一个新的node版本管理工具, 试用了一段时间后感觉是目前我所用过的最优秀的Node版本管理工具。</p>
<p>首先我想先说说为什么放弃一些“好用”的Node版本管理工具, 陈述一下存在的问题</p>
<h2>Volta的问题</h2>
<ol>
<li>
<p>全局看不到东西</p>
<p>我用antfu的taze和@antfu/ni快速升级项目依赖, 如果全局下有pnpm这个包(能通过<code>npm list -g --depth 0</code>看见)，我这样配合一路回车就能快速升级依赖, 但是volta在全局下不止pnpm，yarn也看不见，taze就会提示我你可能没有安装pnpm、yarn, 是否全局安装? 就给我的一路回车这个行为中断了, 次数多了这个糟糕的中断带来的割裂感被无限放大</p>
</li>
<li>
<p>和pnpm的契合的不够好</p>
<p>目前常用的三个软件包管理器, npm、yarn、pnpm, 在这三者中pnpm的体验又是最好的, 但volta对pnpm的支持目前只停留在“实验性”支持, 这个有些不尽人意</p>
</li>
<li>
<p>和一些npm库检查工具契合度糟糕</p>
<p>比如用于检查项目依赖版本情况的<a href="https://github.com/raineorshine/npm-check-updates">npm-check-updates</a>、用于自动调用包管理器命令的<a href="https://github.com/antfu/ni">ni</a>, 这些好用的东西都对volta有过一些错误报告至今未解决 (<a href="https://github.com/raineorshine/npm-check-updates/pull/1117">错误报告</a>、<a href="https://github.com/antfu/ni/issues?q=volta">相关issue</a>)</p>
</li>
<li>
<p>缓慢的更新速度</p>
<p>虽然GitHub可以观察到一直在提交, 但上次更新release在2023年1月, 也是这一点促使了我去寻找代替品</p>
</li>
<li>
<p>没有卸载功能</p>
<p>使用volta将18.18.0升级到18.19.0, 他的行为就是再给你装一个新的, 如果你比较喜欢跟着版本更新, 电脑里将会有很多类似的版本(你当然可以手动去目录删除, 但是有些原始不是吗)</p>
</li>
</ol>
<h2>nvm的问题</h2>
<ol>
<li>nvm并没有Windows版本, Windows上使用的叫做<code>nvm-windows</code></li>
</ol>
<h2>nvm-windows的问题</h2>
<ol>
<li>不支持根据项目自动切换Node版本, 也就是说需要在切换项目的时候去使用命令手动切换Node版本, 作者也表示不会在这个项目中提供支持, 作者原话在<a href="https://github.com/coreybutler/nvm-windows/wiki/Common-Issues#why-isnt-nvmrc-supported-why-arent-some-nvm-for-macoslinux-features-supported">这个链接</a>中可以看到</li>
<li>虽然作者表示不会在这个项目中添加自动切换, 但是还是说启动了一个新的项目, 用于改善这一问题, 只是这一项目还未完成, 更多信息可以在链接中看到<a href="https://github.com/coreybutler/nvm-windows/wiki/Runtime">https://github.com/coreybutler/nvm-windows/wiki/Runtime</a></li>
</ol>
<h2>pnpm管理Node版本的问题</h2>
<ol>
<li>
<p>pnpm也是可以管理Node版本的, 通过脚本安装pnpm</p>
<p><code>iwr https://get.pnpm.io/install.ps1 -useb | iex</code> ,</p>
<p>然后使用<code>pnpm env use --global 18</code> 这样管理Node, 但在使用了几个小时候就放弃了, 目前还是有挺多bug的, 无法日常使用</p>
</li>
</ol>
<h2>本文主角 - nvm desktop</h2>
<p><a href="https://github.com/1111mp/nvm-desktop">nvm desktop</a>是一个以可视化界面操作方式管理多个 Node 版本的桌面应用, 有以下优势</p>
<ol>
<li><strong>自动根据项目切换Node版本, 人工设置一次, 后续无需干预, 并不需要后台运行着软件</strong></li>
<li>基于electron, 多端表现高度一致</li>
<li>引擎由<a href="https://github.com/1111mp/nvmd-command">nvmd-command</a>提供, Rust编写</li>
<li>可视化操作更易于上手</li>
<li>保留了nvm命令行操作, 只是将命令从<code>nvm xxx</code>  改为了<code>nvmd xxx</code></li>
<li>没有那么多水土不服的问题</li>
</ol>
<p>基于以上优点, 在多人的团队协作中, 这个nvm desktop是一个比较好的Node版本管理解决方案</p>
<h3>软件截图</h3>
<p><strong>列出所有可供使用的Node版本, 支持换阿里源</strong></p>
<p><img src="https://i0.hdslb.com/bfs/article/5357e922560ba1e704ada4c6e1854ebf30109107.png" alt="" /></p>
<p><strong>管理已经安装的Node版本</strong></p>
<p><img src="https://i0.hdslb.com/bfs/article/7ab7754ea1b1c4de8a2ebcb07dcd187030109107.png" alt="" /></p>
<p><strong>为项目指定Node版本, 不指定的则为全局Node版本</strong></p>
<p><img src="https://i0.hdslb.com/bfs/article/9ba182f98dae2535455dd9808cf19bad30109107.png" alt="" /></p>
<h2>客户端下载链接</h2>
<p><a href="https://github.com/1111mp/nvm-desktop/releases/latest">https://github.com/1111mp/nvm-desktop/releases/latest</a></p>
<p>这个软件并没有什么需要注意的, 但是因为一些玄学问题, 我建议你<strong>卸载干净</strong>电脑中的Node, nvm, Volta之类的软件, 重启电脑后再安装nvm-desktop</p>
<h2>如果你是从其它管理工具换过来的</h2>
<p>建议检查自己设备中的环境变量, 一些工具卸载后依旧会残留环境变量在个人设备中, 可能出现预期之外的错误, 建议进行清理 (比如装过Volta, 再装npm-check-updates, 你会因为<a href="https://github.com/raineorshine/npm-check-updates/blob/main/src/index.ts#L49">这行代码</a>被告知禁止检查全局)。</p>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2023-09-27T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[《人性的弱点》TL;DR]]></title>
        <id>https://lainbo.dev/posts/summary-how-to-win-friends/</id>
        <link href="https://lainbo.dev/posts/summary-how-to-win-friends/"/>
        <updated>2023-08-22T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[《人性的弱点》逐章精炼总结]]></summary>
        <content type="html"><![CDATA[<p>书籍信息：<a href="https://book.douban.com/subject/1056295/">豆瓣读书</a></p>
<p>《人性的弱点》是一本探索人际关系技巧的经典之作，它揭示了如何更好地理解、沟通和与他人互动。这篇文章是对这本书每一章的精炼总结，旨在揭示该书的核心思想，快速回顾并吸取卡内基的智慧，更好地在日常生活中应用这些原则，建立更和谐、有效的人际关系。这本书里有很多故事，故事是为了佐证其观点，如果你对这些故事不感兴趣，可以看这个TL;DR版本，节省阅读时间。</p>
<h2><strong>批评他人不会带来任何积极的结果</strong></h2>
<p>我们无法通过批评他人来实现真正的改变，相反，我们往往会遭遇到怨恨。重要的是要记住，当与人打交道时，我们所面对的不是理性的生物，而是情感驱动、以自尊和自我为动力的生物。</p>
<p>批评是徒劳和危险的。它让人处于防御状态。当人们因为良好行为而受到奖励，而不是因为不良行为而受到惩罚时，他们学得更快，保持知识更有效。</p>
<h2><strong>唤起他人的渴望</strong></h2>
<p><strong>影响他人的唯一方法就是谈论他们想要的，并向他们展示如何获得。</strong></p>
<p>说服别人做某事，我们必须从他们的动机出发来构建。为了做到这一点，我们必须能够从他们的角度看问题，也要考虑到我们自己的观点。</p>
<h2><strong>学会真正对人感兴趣</strong></h2>
<p><strong>当别人对我们感兴趣时，我们也对他们感兴趣。</strong></p>
<p>如果你想交朋友，就要主动为他人做一些事情——那些需要时间、精力、无私和体贴的事情。</p>
<h2><strong>微笑的力量</strong></h2>
<p><strong>如果你希望别人在见到你时过得愉快，那么你必须在与人交往时过得愉快。</strong></p>
<p>行动胜于言辞，一个真诚的微笑传达着：“我喜欢你，你让我快乐。”但虚伪的笑容无法欺骗任何人。我们知道它是机械的，我们也对此感到愤怒。</p>
<h2><strong>记住人的名字</strong></h2>
<p>称呼别人的名字就像是给他们一个非常微妙的赞美。相反地，忘记或拼错别人的名字会产生相反的效果，让人感觉我们与他们疏远和不感兴趣。</p>
<p>从服务员到高级执行官，这个名字在你与他人打交道时会产生魔力。</p>
<h2>通往一个人心灵的皇家大道是谈论他或她最珍视的事物。——<em><strong>西奥多·罗斯福</strong></em></h2>
<h2><strong>让别人感到自己的重要</strong></h2>
<p>人们希望得到与他们接触的人的认可。他们希望被认可自己真正的价值。他们希望感到自己对这个世界是不可或缺的。</p>
<p>但是他们不想听到廉价、虚伪的恭维——他们渴望真诚的赞赏。</p>
<h2><strong>赢得他人对你的想法的认同</strong></h2>
<ol>
<li>要想在争论中取得优势，唯一的方法是避免争论。</li>
<li>尊重他人的观点，永远不要说：“你错了。”</li>
<li>如果你错了，要迅速而坚决地承认。</li>
<li>以友好的方式开始。</li>
<li>让对方立刻表达“是的，是的”的观点。</li>
<li>让对方大量发言。</li>
<li>让对方觉得这个主意是他/她的。</li>
<li>诚实地尝试从对方的角度看问题。</li>
<li>对对方的观点和欲望表示同情。</li>
<li>启发更崇高的动机。</li>
<li>生动地阐述你的想法。</li>
<li>提出挑战。</li>
</ol>
<h2><strong>无法赢得争论</strong></h2>
<p>赢得<strong>争论的最佳方式就是避免参与其中。</strong></p>
<p><em>如果我们输了争论，我们就输了；如果我们赢了争论，我们让对方感到自卑，伤害了他的自尊心，让他对我们产生了怨恨。换句话说，我们还是输了。</em></p>
<h2><strong>不要谴责，试着去理解</strong></h2>
<p>成功的人际关系的一个基本关键是要明白，其他人可能完全错误，但他们自己并不这样认为。</p>
<p>设身处地。与人打交道的成功取决于对他人观点的同情理解。</p>
<h2><strong>如何在不冒犯的情况下改变他人</strong></h2>
<ol>
<li>以赞美和真诚的欣赏开始。</li>
<li>让别人自己看到错误，方式要间接且委婉。</li>
<li>先谈论自己的错误，再谈别人的错误。</li>
<li>提出问题而不是直接下命令。</li>
<li>让对方保全颜面。</li>
<li>赞扬微小的进步，赞美每一个进步。</li>
<li>用赞美激励别人，别人会更加努力。</li>
<li>多使用鼓励，让对方的过失看起来很容易纠正。</li>
<li>让对方为你建议的事情感到愉快。</li>
</ol>
<h2><strong>让人们喜欢你</strong></h2>
<ol>
<li>真诚地对待他人。</li>
<li>微笑。</li>
<li>记住一个人的名字对于他来说是任何语言中最甜蜜和最重要的声音。</li>
<li>成为一个好的倾听者。鼓励他人谈论自己。</li>
<li>用对方感兴趣的话题交谈。</li>
<li>让对方觉得重要 - 并真诚地这样做。</li>
</ol>
<h2>家庭幸福的7个法则</h2>
<ol>
<li>绝不要唠叨；</li>
<li>不要试图改变对方；</li>
<li>不指责；</li>
<li>真挚地赞美您的爱人；</li>
<li>事无巨细，做个有心人；</li>
<li>夫妻应相敬如宾；</li>
<li>读一本介绍婚姻性生活方面的好书。</li>
</ol>
<h2>夫妻如何相处</h2>
<h3>给丈夫:</h3>
<ol>
<li>您是否还偶尔送她一朵花？记住她的生日和结婚纪念日？时不时给她意外惊喜？或用温柔、体贴的行动来“取悦”她？</li>
<li>您是否在乎她的感受，避免在公众场合指责她？</li>
<li>除家用开支外，您是否给她一些零用钱，供她随意支配？</li>
<li>您是否努力去了解女性的情绪，一起帮她度过疲惫、紧张、易怒的生理期？</li>
<li>是否至少有一半的休闲时间与妻子共同度过？</li>
<li>除非为了显示她的优点，您是否避免将妻子的厨艺、家务能力与您母亲或别人的妻子做比较？</li>
<li>您是否关心她的学习、交友、社交圈、喜欢的书和对社会问题的看法？</li>
<li>您是否允许她有其他男性舞伴，对其他男人的献媚不吃醋？</li>
<li>您是否想方设法赞扬她、欣赏她？</li>
<li>对她为您做的一些小事，诸如钉扣子、补袜子、洗衣服，是否心存感激？</li>
</ol>
<h3>给妻子:</h3>
<ol>
<li>丈夫忙于工作时，您是否尽量不去打扰他？您是否避免指责他的同事、秘书，让他有足够的个人空间？</li>
<li>您是否努力让家庭变得更有趣味、更有情调？</li>
<li>您的饭菜是否经常变换花样，每次让他坐在饭桌前都有新的惊喜？</li>
<li>您是否理解丈夫的工作和事业，并与他进行建设性的讨论？</li>
<li>当家庭出现财务危机，您是否能积极、乐观地面对，而不批评丈夫的失误，也不拿他与其他成功男士做比较？</li>
<li>在维系婆媳关系、与其他亲戚相处方面，您是否足够努力，足够智慧？</li>
<li>您的穿衣打扮，是否在乎丈夫对颜色、款式、品味的喜好？</li>
<li>为了家庭和睦，您是否在一些问题上作出让步？</li>
<li>您是否努力学习丈夫心爱的运动，以便更好地与他共度休闲时光？</li>
<li>为了和丈夫的兴趣一致，您是否关注新闻、新书、新思潮？</li>
</ol>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2023-08-22T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[html标签的lang属性写法]]></title>
        <id>https://lainbo.dev/posts/html-lang/</id>
        <link href="https://lainbo.dev/posts/html-lang/"/>
        <updated>2023-08-13T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[HTML 的 lang 属性怎么写，CSS 又怎么匹配它]]></summary>
        <content type="html"><![CDATA[<p><img src="https://lainbo.dev/_astro/html-lang.Bx8l_dAl_Z2cRMQc.webp" alt="" /></p>
<h2>格式简介</h2>
<p>html标签的lang属性<a href="https://www.w3.org/International/articles/language-tags/">由7个部分组成</a>，常用的，在<a href="https://developer.mozilla.org/en-US/docs/Web/HTML/Global_attributes/lang">MDN</a>上介绍的都是1号位、2号位、4号位。</p>
<p><img src="https://i0.hdslb.com/bfs/article/763af027899a12883afc31c35f22333a30109107.png" alt="" /></p>
<ol>
<li>语言: 比如中文的<code>zh</code>，英文的<code>en</code></li>
<li>扩展语言(方言): 比如<code>cmn</code>表示普通话，<code>yue</code>表示粤语，<code>lzh</code>表示文言文，主要用来指示屏幕阅读器的朗读效果</li>
<li>书写系统/格式: 比如<code>Hans</code>表示简体中文，<code>Hant</code>表示繁体中文</li>
<li>地区: 比如<code>CN</code>表示中国，<code>HK</code>表示香港</li>
<li>变种: 用于指定语言的特定变体，以zh开头的并且能写这一项的比较少，比如<code>pinyin</code> 代表我们认知中的拼音，<code>wadegile</code> 表示威妥玛拼音，这两个举例都必须要前缀为<code>zh-Latn</code> 的时候才能使用</li>
<li>扩展: 用于添加特定于语言的扩展</li>
<li>私有使用: 为私人使用而保留的子标签。除非有特殊需要，否则一般不使用</li>
</ol>
<h2>扩展语言/方言(2号位)</h2>
<p>在以zh开头的情况下，暂时有13个被批准的<strong>方言(只讨论方言，不是所有zh开头的只有13个)</strong>，分别是:</p>
<ol>
<li>
<p>cdo - 闽东话</p>
</li>
<li>
<p>cjy - 晋语</p>
</li>
<li>
<p>cpx - 莆仙话</p>
</li>
<li>
<p>czh - 惠州话</p>
</li>
<li>
<p>czo - 闽中话</p>
</li>
<li>
<p>gan - 赣州话</p>
</li>
<li>
<p>hak - 客家话</p>
</li>
<li>
<p>hsn - 湘语</p>
</li>
<li>
<p>lzh - 文言文</p>
</li>
<li>
<p>mnp - 闽北话</p>
</li>
<li>
<p>nan - 闽南话</p>
</li>
<li>
<p>wuu - 吴语</p>
</li>
<li>
<p>yue - 粤语</p>
</li>
</ol>
<p>令人困惑的是，这些标签可以作为extlang(2号位置)表示方言(如: zh-cdo)，也可以放在language(1号位置)位置作为主语言(如: cdo-Hans)。那么这些标签和传统的“zh”标签有什么关系呢？IANA把“zh”定义为“macrolanguage”，我无法确定如何翻译，宏语言？还是语系？<a href="http://www.rfc-editor.org/rfc/bcp/bcp47.txt">BCP 47</a>的观点认为汉语包含若干语言，它似乎认为汉语的方言可以视为独立的语言。</p>
<p>因此，以下<strong>两种方式都是正确</strong>的</p>
<ol>
<li><code>&lt;html lang="zh-cdo-Hans"&gt;</code> (zh作为1号位置的主语言)</li>
<li><code>&lt;html lang="cdo-Hans"&gt;</code> (cdo这个方言做为1号位置的主语言)</li>
</ol>
<p>弄清方言带来的困惑之后，我个人的建议是使用“zh”作为主语言。我不想进行政治讨论也不想研究深奥的学术问题，建议只使用“zh”做主语言子标签的唯一理由是——避免混乱。谁知道IANA的大佬们未来会批准出多少个中国的语言来，我们要都背下来？还是在维护代码的时候问一下AI或者查一下字典看看这是哪一个犄角旮旯的外语/方言？</p>
<p>“zh”表示中文，“zh-xxx”仍然表示中文，但需要考虑方言特性。这样的表达不会带来任何误解。</p>
<h2>如何写HTML的lang属性</h2>
<p><strong>越短越好 !</strong></p>
<p>W3C的建议是：</p>
<blockquote>
<p>“The golden rule when creating language tags is to keep the tag as short as possible”</p>
</blockquote>
<p>因此，W3C的示例“zh-Hans”——中文简体，就成了最好的用法。或者我个人认为只用“zh”也可以，混用简繁也没问题。</p>
<h2>如何写CSS匹配</h2>
<p><strong>只写前缀 !</strong></p>
<p>我在一些GitHub开源项目中看见了一些作者，在CSS中很认真的将所有的语种以及2号位都罗列出来了(如: <code>zh</code>, <code>zh-CN</code>, <code>zh-SG</code>, <code>zh-Hans</code>, <code>cmn</code>, <code>cmn-Hans</code>, <code>zh-cmn-Hans</code>)，我很佩服作者这种认真的精神，相信他也一定为了集齐七龙珠查阅了很多资料，但是这是不必要的。我们来看一个例子，从图中可以看出，无论<code>html</code>标签的<code>lang</code>属性写的多么复杂，<strong>在CSS中只需要写前缀即可匹配到</strong>，并不需要将所有的方言穷举出来，穷举难免有遗漏，或是未来出现的新方言，这都可能导致CSS的匹配出现问题。</p>
<p><img src="https://i0.hdslb.com/bfs/article/492cf0a4121e64977d08b5ffe802c1a030109107.png" alt="" /></p>
<p>如果你不确定自己在做什么，请不要穷举，只写前缀就好。</p>
<h2>兼容性问题</h2>
<p>事实上在很多的中文网站上，我们经常可以看见<code>zh-CN</code> 的写法，我并不清楚有多少浏览器不兼容这个写法，因为从格式上来看，他跳过了2号位和3号位，也就是方言位和书写格式位。从规范上来看，如果一定要表现<code>CN</code> 这个要素, 或许<code>zh-Hans-CN</code> 会更加好一些(仅省略供屏幕朗读器使用的方言位)。</p>
<h2>参考资料</h2>
<ol>
<li><a href="https://www.w3.org/International/articles/language-tags/">W3C文档</a></li>
<li><a href="http://www.iana.org/assignments/language-subtag-registry/language-subtag-registry">IANA已登记的子标签</a></li>
<li><a href="http://www.rfc-editor.org/rfc/bcp/bcp47.txt">BCP 47</a></li>
<li><a href="http://www.rfc-editor.org/rfc/rfc5646.txt">RFC 5646</a></li>
</ol>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2023-08-13T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[规避笔记陷阱 [译]]]></title>
        <id>https://lainbo.dev/posts/note-taking/</id>
        <link href="https://lainbo.dev/posts/note-taking/"/>
        <updated>2023-07-14T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[做笔记时容易掉进的几个陷阱]]></summary>
        <content type="html"><![CDATA[<p>在我们的学习和工作过程中，笔记的重要性不言而喻。然而，并非所有人都需要做笔记。许多人在大学时期，甚至没有做笔记，也能顺利完成学业。他们可以在考试中即兴发挥，也可以通过阅读和死记硬背老师画的范围准备考试。那么，如果你能记住所有需要的信息，如果你不需要处理来自多个来源的复杂信息，如果你不需要写长篇报告或内容，你为什么还需要做笔记呢? 这似乎是多余的，对吧?</p>
<p>对于需要经常更新自己知识的人来说，做笔记是必不可少的。他们需要通过学习和研究不断提升他们的能力，应用知识来解决问题，并将他们的知识传达给他人。他们的“考试”可以在任何时候以任何形式发生，而且信息量如此之大，我们不能期望一个人只凭他们的记忆就能记住、理解和产生新的想法。因此，我们需要做笔记。</p>
<p>如何做有效的笔记呢? 如果你问五个人这个问题，你可能会得到五个不同的答案。事实是：没有人知道有效的笔记应该是什么样子。主要是因为关于这个话题的研究还不够（至少到目前为止）。但是我还是要分享我的实践（以及背后的理由），希望这对他人有所帮助。在这篇文章中，我将强调常见的做笔记的陷阱，以及如何克服它们。</p>
<h2>定义有效的笔记</h2>
<p>有效的定义是成功地产生给定的结果。因此，要做到有效，就需要有一个目标或意图，即: <strong>目标决定有效性</strong>。任何做笔记的目标，甚至是"没有目标"（这也是一个目标），都将决定你的做笔记技巧的有效性。</p>
<p>我想讨论一种做笔记的实践，这个实践</p>
<ol>
<li>支持你的思维方式（是定制给你的）。</li>
<li>表示你的知识（受他人的话语受到启发和影响，但不仅仅是他们的话的复制/粘贴）。</li>
<li>轻松检索到你的知识。</li>
</ol>
<p>那么，当你试图创建一个真正属于你的系统时，有哪些常见的做笔记的陷阱呢?</p>
<p>首先，为什么我称它们为陷阱而不是错误呢?</p>
<p>这些实践依旧可以帮助你前进，所以它们不是错误。它们依旧会支持你的思考，并给你一种成就感，但只能到一定程度。无法发挥他们最大的作用。</p>
<p>当你将这些实践转化为习惯时，摆脱它们就变得更难了。因此，它是一个陷阱。</p>
<p>那么，这些陷阱是什么呢? 让我们来看看。</p>
<h2>陷阱一: 笔记工具</h2>
<p>这个问题就像是什么编程语言最优秀一样，我也曾经在很多笔记软件的评测视频评论区留下自己的痕迹。当我们注意到做笔记可以不仅仅是“复制老师在黑板上写的东西”，我们就会对我们的工具的可能性充满热情。</p>
<p>语雀? 飞书? wolai? flowus ? Notion? Obsidian? 我应该选什么? 我应该使用哪种标签系统? 我应该使用大纲、长篇笔记还是视觉表示方式? 我在一份笔记中应该有多少链接?</p>
<p>事实证明，每个工具都是其创造者做出的一系列设计决策的结果，这些决策可能对你产生积极或消极的影响。所以，要选择最好的工具来支持你的思维方式，比如我不能向一个喜欢大纲的人强推Notion，因为幕布可能更适合做大纲笔记。首先你需要决定：你的工具应该支持哪种思维方式?</p>
<p>为了简化这个过程，我们要有<a href="https://zh.wikipedia.org/wiki/%E4%B8%AA%E4%BA%BA%E7%9F%A5%E8%AF%86%E7%AE%A1%E7%90%86">PKM(个人知识管理)</a>金字塔</p>
<p>在金字塔的基础上，我们有思维方式。这就是你希望你的工具支持的。只有建立了基础，我们才开始创建上层。</p>
<p>这里有三个选择供你选择：</p>
<p>选择1（不推荐）。在你选择工具之前，了解所有适合你的思维方式。这意味着自我反思，阅读，自我反思。你在尝试任何事情之前都会思考很多，但这这听起来很低效，对吧?</p>
<p>选择2。选择你喜欢的工具，并在你用预期的思维方式探索事物时使用它。你将通过试错，并发现思维方式与你想要的不一致的点来学习。这不会加快探索过程，但至少你可以开始了。</p>
<p>选择3。与PKM专业人士和支持性社区合作，快速开始你的过程。从一份思维方式列表和一些初始方法开始你的探索，比自己摸索要容易得多。</p>
<p>爬上PKM金字塔是一次个人的旅程，但你不需要独自完成。社区在这里，你只需要伸手，或者说乐于提问。</p>
<p><strong>所以解决陷阱一的方法：爬上你的PKM金字塔。</strong></p>
<h2>陷阱2: 将笔记写成真理的片段</h2>
<p>陷阱2一般出现在你要建立一个PKM系统的时候</p>
<p>设想一个场景，你和某人在争论一个知识点，你想到了你的笔记中记录一些“大佬”对该观点的至理名言，你会把你的笔记都拍到对面的脸上吗? 最重要的是，你拍到对面脸上的，是你的知识，还是别人说话的片段?</p>
<p>当我们写笔记的内容时，我们可以使用两种不同的思维方式。</p>
<p><strong>第一种</strong>思维方式是"笔记作为真理的片段"。</p>
<p>它指的是在我们的笔记中只有真实、完整和高质量的知识。在这种情况下不能有错误、部分或模糊的信息。这个思维方式会导致:</p>
<ol>
<li>导致我们避免写下自己的想法，因为每个笔记都需要是最终版本，只包含正确的信息，这会触发完美主义。</li>
<li>当我们终于写下自己的想法时，我们只把它们当作短暂的笔记，认为它们是一次性的，有一个截止日期要扔掉，此时我们倾向于不好好处理我们自己的想法。因为会想“为什么要在一个最终要删掉的笔记上花力气呢? ”</li>
<li>所有长期的笔记都是那些“大佬”的原话，我们只是试图准确地捕捉作者的想法。我们有引用、事实和结论，但我们自己的观点在哪里? 我们的知识在哪里? 这种心态会给你带来很多信息，但如果我们的目标是表达你自己拥有的知识，那么它就成了一个陷阱。</li>
</ol>
<p><strong>第二种</strong>思维方式是“笔记作为理解的片段”</p>
<p>这种思维方式会让我们意识到，想法本就是模糊的、不完整的、混乱的。只有通过花时间与这些想法相处，它们才会成长为我们可以认为是真理的片段。</p>
<p>如果你把笔记看作是理解的片段，那么笔记也会随着时间的推移而改善。随着理解的增长，笔记也会随之增长。(我想这就是为什么Notion「文档历史」这一功能存在的主要原因吧，或许Notion的产品经理，并不觉得这个功能是防止文档丢失)</p>
<p>在任何时候，你都可以看看你的笔记，说：这是我现在的理解，我目前对这些想法的认识。它们不会只是你在网上冲浪时需要的信息。相反，它们代表你的个人知识。</p>
<p><strong>所以解决陷阱二的方法：把你的笔记看作是理解的片段。</strong></p>
<h2>陷阱3: 把笔记写成文档</h2>
<p>写笔记本就是一项耗时的事情，我不希望你创建了100篇笔记，只是为了在需要的时候找不到想找的内容。</p>
<p>让我们先停下来，想一下什么时候需要我们查找笔记</p>
<ol>
<li>需要回顾我们的知识，或者某一个想法的时候</li>
<li>提高对某一个知识理解或者表达的时候</li>
<li>想要传达想法的时候</li>
</ol>
<p>再来看一下大多数人是如何做笔记的</p>
<ol>
<li>读了一篇关于全球变暖的文章，然后创建了一份笔记，标题可能是"全球变暖的文章摘要"。在这份笔记中，你记录了文章中的各种观点，例如温室气体排放的影响、冰川融化的速度、海平面上升的预测等。这些都是不同的想法，但却都记录在了同一份笔记中。</li>
<li>听了一个尤雨溪的播客，时长1小时30分钟，然后创建了一份笔记，标题可能是“6月1日尤雨溪播客访谈内容”，里面写了尤雨溪如何读书，如何学习，如何思考。这些都是不同的想法，但却记录在了同一份笔记中。</li>
</ol>
<p>这就是很多人都在做的“文档笔记”，也就是第三个陷阱的主要表现。</p>
<p>文档笔记包含了多个想法的片段，或一个完整的论证链在一个单独的笔记中。而且，它们有奇怪的标题，比如“5月1日学习知识总结”，这些标题与笔记里面的内容毫无关联。</p>
<p>当我们去文档笔记中找内容的时候，是很低效的，因为:</p>
<ol>
<li>你需要记得几乎所有想法的关键字，以便在笔记工具中搜索。(大概率记不住或记不全)</li>
<li>你需要阅读大部分的笔记才能找到提到想法的段落（耗时）</li>
<li>同一个想法的片段可能会出现在多个笔记中（希望你能找到他们所有）。这些片段甚至可能相互矛盾。</li>
</ol>
<p>反思一下，如果你在找一个知识点，那为什么要把笔记写成文档的形式呢? 我建议写“想法笔记”，比如关于上面的两个例子，如果换成想法笔记则是:</p>
<ol>
<li>在读到关于全球变暖的文章后，创建多份笔记，每份笔记都只关注一个主要的想法。例如"温室气体排放对全球变暖的影响"、"冰川融化的速度和全球变暖的关系"、"海平面上升的预测和全球变暖的关系"。</li>
<li>听了尤雨溪一个半小时的播客后，创建多份笔记，每份笔记都只关注一个主要的想法。例如“应该如何读书”、“前端开发书籍选择”、“向尤雨溪一样思考”</li>
</ol>
<p>然后利用笔记工具的一些能力，将其聚合在一个“全球变暖相关记录”/“尤雨溪访谈记录”的文档里，这个文档将仅包含那些小想法的跳转链接和简要的说明，你无需在一篇大文章中大海捞针。</p>
<p>想法笔记的关键在于它只<strong>关注</strong>一个想法，而不是只能有一个想法，其他的存在是为了让主旨更加突出，当有别的想法开始喧宾夺主的时候，是时候为它单独创建一个笔记了。</p>
<p><strong>所以解决陷阱三的方法：创建想法笔记。</strong></p>
<p>虽然没有完美的做笔记的公式，但如果你专注于最适合你的最佳思维方式，一切也都会顺利的进行下去，这也就是我们所说的“车到山前必有路”，是烂路还是是好路，取决于你的思维方式罢了。</p>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2023-07-14T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[如何向人类提问 [译]]]></title>
        <id>https://lainbo.dev/posts/how-to-ask-questions/</id>
        <link href="https://lainbo.dev/posts/how-to-ask-questions/"/>
        <updated>2023-04-19T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[工程师求助时常遇到的几种障碍和应对经验]]></summary>
        <content type="html"><![CDATA[<p>本文翻译自<a href="https://redd.one/blog/how-to-ask-questions">https://redd.one/blog/how-to-ask-questions</a></p>
<p>作为一名软件工程师，你经常需要实现现实世界的功能并修复棘手的漏洞。有时你可能觉得自己缺乏知识，或者不确定如何完全处理任务。这是完全正常的，即使是最有经验的工程师也会偶尔遇到困难，没有人真正知道一切，尽管他们可能看起来很聪明。寻求帮助（以及提供帮助）是编程不可或缺的一部分，就像编写代码或进行代码审查一样。然而，提问本身就是一门学问，需要一些时间学习如何以较少的投入获得更多的成果。</p>
<h3>提问即学习</h3>
<p>我知道害怕或羞于提问的感觉，担心你的同事可能会认为你智商或者技术水平较低，对你提出他们认为显而易见的问题皱眉，甚至欺负你，要求你现在应该已经知道答案。如果你感到所处的环境不鼓励提问，那么你可能处于一个很差的环境中，需要尽快离开。那些瞧不起兴趣、实验和提问的人，很少是聪明人，因为他们阻止自己和他人获取知识。知识来自学习，而学习来自提问。确保你与那些理解这一点的人一起前行。</p>
<p>然而，如果你在寻求帮助时感到害羞或不自信，我有一个小窍门给你：不要把你的问题看作是你不知道某件事情的标志，而应该把它看作是想要学到更多的标志。在我看来，提问是学习任何领域最有效的方式。通过这种方式，你可以在提问这门伟大的艺术中取得进步，并且更有可能记住答案，因为我们最容易记住自己亲身经历过的问题的解决方案。</p>
<blockquote>
<p>💡 <strong>不要剥夺自己最好的学习方式：提问。</strong></p>
</blockquote>
<h3>提问的伟大艺术</h3>
<p>提出正确问题的技巧非常难以掌握。然而，如果不去实践并关注那些让你更接近答案的细节，你是不会变得更擅长提问的。这个话题值得一本厚厚的书来探讨，但现在让我们探讨提问中最常见的问题之一：具体性。</p>
<p>问题的具体性通常是模棱两可的，既可能让你更接近答案，也可能让你离答案更远。让我们来看看为什么会这样。</p>
<h3>无关的具体性</h3>
<p>这里有一个问题的例子：</p>
<blockquote>
<p>如何在 React 中在页面刷新时保持来自谷歌的身份验证令牌？</p>
</blockquote>
<p>虽然这可能是一个有效的问题，但它包含了太多在回答问题时没有用的细节。例如，不要将身份验证过程绑定到谷歌，而是考虑询问关于通用身份验证持久性的问题。因为对于谷歌、亚马逊或其他任何提供商，在这方面的情况大致相同。不要将答案限制在 React 生态系统内，而是尝试从问题中去掉框架，以了解 JavaScript 中的持久性。这样，你得到的答案更有可能被其他框架和库复用，使其更有价值。最后，当涉及持久性时，保持身份验证令牌、唯一ID或任何类型信息的重要性很小。即使是问题中的“身份验证”部分也可以用“如何保持数据”来替换，任何数据。</p>
<p>虽然你所处的背景可能很重要，但往往放弃它有助于找到一个最终会引导你找到正确答案的线索。</p>
<blockquote>
<p>💡 <strong>提问就是调查：你找到线索，引导你提出更具体的问题，最终找到答案。</strong></p>
</blockquote>
<p>当你需要把一个红色的球体变成一个蓝色的尖锐立方体时，不要指望立刻找到解决这个任务的方法。首先学习如何将球体变成立方体，然后学习如何使任何立方体变成蓝色，最后学习如何使蓝色物体变得尖锐。任何编程任务都可以分解成一系列较小的任务，从长远来看，研究这些任务将是一个更有价值的过程。在这个过程的中间，你可能会意识到你甚至不需要让立方体变尖锐。</p>
<p>我强烈建议从问题中去掉背景的原因是，这样可以让你更有机会找到答案。这也会让你明白一个问题很少有唯一的直接答案。开始时可以从宏观方面入手，随着你逐渐发现的每一个知识点，逐渐缩小到具体的细节。你会惊喜于通过这种方式学到的东西有多少。</p>
<h3>相关的具体性</h3>
<p>提供包括库名称、浏览器版本或特定选项名称在内的技术细节可以帮助缩小调查范围，让你更接近答案。但是，在提供这些信息时，有一件重要的事情：你必须知道哪些是相关的。</p>
<p>看看这个问题：</p>
<blockquote>
<p>Axios在componentDidMount中的POST请求失败。</p>
</blockquote>
<p>评估这些技术细节的实用性完全不可能，因为它们可能既相关又无关，这取决于特定的用例。提问时知道包括什么，和省略什么，就成了你的责任。说实话，这是提出正确问题的难点之一，也是随着时间和实践而获得的技能之一。</p>
<blockquote>
<p>💡 <strong>在包括技术细节时，你必须知道什么是相关的，什么不是。</strong></p>
</blockquote>
<p>不幸的是，提到无关的细节可能会使你的调查工作偏离轨道。幸运的是，如果你询问的人熟悉这个话题，他们可以帮助你根据相关性筛选这些细节。</p>
<p>随着时间的推移，当你不断提问时，你会开始注意到某些技术细节对你来说变得非常重要，而其他一些则逐渐变得不那么重要。关于这点，我没有其他更高明的建议，只是鼓励你继续提问！</p>
<h3>15分钟规则</h3>
<p>在提问时应该小心，不要养成把问题交给别人的习惯。虽然在绝境中寻求帮助是应该做的事情，但我们都不喜欢挣扎。因此，当我们期待已久的帮助终于到来时，我们自然会感到满足和欢喜。为了让这种帮助持续更长时间，试着在提问之前学会评估情况。这可以防止不必要的问题，并给你一种独立完成的感觉。</p>
<blockquote>
<p>💡 <strong>最后，期望答案的质量与你愿意花费寻找它的时间成正比。</strong></p>
</blockquote>
<p>在我的职业生涯中，采用“15分钟规则”对我非常有帮助。每当我发现自己陷入困境时，我就会专注地花15分钟时间自行解决当前问题。到时间结束时，我会检查我所提的问题是否仍然相关。如果不再相关，我会用另外15分钟处理接下来出现的问题。只有在我的努力证明无果时，我才会向同事或其他开发人员提问。</p>
<p>这个规则非常有用，因为它可以增加你问题的价值。在尝试解决问题的过程中，你通常会学到一两个知识点，即使没有找到答案。你所获得的知识和尝试过的方法，可能会帮助你未来的“顾问”，也就是帮你解决问题的人，更准确地解决你的问题。同时，你在解决问题中的努力，也为得到他人理解和同情的回应奠定了基础。</p>
<h3>耐心</h3>
<p>软件工程可能会让人感到压力：由于某个问题导致客户失去收入，经理对错过的截止日期愤怒——我们都经历过。压力并不能真正解决这些情况，也不能找到问题的答案。</p>
<p>请记住，解释问题和提出正确的问题同样困难。花时间帮助你的人可能会努力寻找最合适的方式来向你传达答案。在这个过程中，耐心和善良至关重要。</p>
<h3>帮助他人</h3>
<p>无论你认为自己有多么缺乏经验，总会有一个人比你落后一步。那个人正走着与你类似的道路，但他们可能还没有完全理解你已经掌握的某些概念或模式。下次当你看到有人对你觉得非常明了的话题感到困惑时，请帮助他们。</p>
<blockquote>
<p>💡 <strong>提供帮助与寻求帮助同样有用。</strong></p>
</blockquote>
<p>无私奉献并不是帮助他人的唯一原因。最佳的确认自己是否真正理解了问题的方式，也许就是通过解释这个问题来实现。因为我们每个人的思考和记忆方式各不相同，一开始向需要帮助的人传达你的想法可能会很具挑战性。有时候，这需要你验证自己所学到的知识，以免给出错误或不完整的答案。这可能会帮助你发现自己知识中的一些盲点！</p>
<h3>得出结论</h3>
<p>得到答案当然很有成就感，但请尝试将其记在脑海里。问题并不是一个燃烧的炉子，一个接一个地抛出答案并无益处，因为提问的目的是学习。从答案中获取有价值的信息可能需要回顾原始问题并得出结论。问题的原因是什么？解决方案是什么？解决方案是直接还是间接影响了原因？在解决这个问题时，还有什么补充知识可以帮助吗？</p>
<p>学习本身就是一项技能，因为我们所有人学习、记忆和解释事物的方式都截然不同。既然如此，为什么不在答案已经掌握的情况下提高另一项技能呢？尝试找到最适合你的学习方式，无论是画图、编写简短的文档，还是在书签中收藏有用的链接。下次有问题出现时，这个宝库是开始使用15分钟规则的好地方！</p>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2023-04-19T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[前端程序员简历教程 + 模板📜]]></title>
        <id>https://lainbo.dev/posts/fe-resume/</id>
        <link href="https://lainbo.dev/posts/fe-resume/"/>
        <updated>2023-03-31T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[又是一年铜三铁四，一份前端简历教程+模板希望能帮到你]]></summary>
        <content type="html"><![CDATA[<p><em>2023年12月20日 修订</em></p>
<h3><strong>简历文件提示</strong></h3>
<p>简历的文件应该是pdf格式的，而不是word文档或者图片</p>
<p>简历的文件名应该符合格式：应聘岗位_姓名_手机号，例如：Web前端开发_张三_13212345678.pdf</p>
<p>推荐一个免费生成简历的平台，可以帮你快速完成下方的信息填写并生成简历 : <a href="https://www.developers.pub/resume">开发者客栈 - 简历</a></p>
<hr />
<p>（以下所有 <strong>蓝色块</strong> 整合在一起，即为一个完整的简历模板）</p>
<h3><strong>个人信息</strong></h3>
<p>姓名 / 年龄 / 电话 / 邮箱（尽量不要QQ邮箱，万一呢）/ 个人网站、github地址 / 工作经验(x年) / 求职岗位 / 期望薪资: (最好写面议，因为最好是先争取到面试机会，万一面完人家觉得不错肯为你开高价)</p>
<p>例如：</p>
<h3>张三</h3>
<p>13212345678 | zhangsan@163.com | 北京</p>
<p>https://github.com/你自己的/(或者自己的个人网站)</p>
<p>x年工作经验 | Web前端开发工程师 | 薪资面议</p>
<h3><strong>技能清单</strong></h3>
<p>有两种写法,</p>
<ol>
<li>
<p><strong>纯前端写法</strong>, 适合只会前端相关技能的人使用</p>
<ul>
<li><strong>写亮点</strong>，大概写个5-10条能拿出来说的，例如“熟练使用ES6语法，会使用并阅读过xxx源码，有xxx成果”。</li>
<li><strong>不要写</strong>，“会使用axios发请求”之类的话，axios只能发请求，也不能干别的，就好像说了一句“我会用烧水壶烧开水”，这种约等于废话，形如这种的都别写</li>
</ul>
<p>例如</p>
<ol>
<li>熟练使用Vue2、Vue3、React全家桶，并对其源码有自己的理解和认识</li>
<li>熟练技术栈对应的多种组件库，熟悉其api和一些表现与预期不符的地方</li>
<li>JS、CSS等前端基本功扎实，积累深厚，各种api特性了然于心，最佳实践信手捏来</li>
<li>熟练稳定使用Chat GPT、Claude、GitHub Copilot进行开发和优化，掌握写prompt的各种要素，擅长引导AI给出高质量代码</li>
<li>熟练使用Echarts，AntV等可视化解决方案</li>
<li>熟练使用ES6（es2015 - es2022）</li>
<li>熟练使用TypeScript，熟悉类型编程</li>
<li>熟练使用多种算法 / 了解一些业务适用的算法，能在合适的地方进行性能优化</li>
<li>熟练Windi CSS、Tailwind CSS、UnoCSS等原子化CSS框架/引擎</li>
<li>熟练前端工程化，并利用工程化实现了xxx效果</li>
<li>了解Less、Scss等预处理器（如果拿着预处理器，却只会嵌套着写CSS，写变量这样的基础功能，最好是写“了解”）</li>
</ol>
</li>
<li>
<p><strong>综合写法</strong>, 适合有一定的综合能力的人使用, 不局限于前端技能</p>
<ul>
<li><strong>不要</strong>将技能拆分的过于精细, 基本原则同样是写亮点和不要写废话</li>
</ul>
<p>例如:</p>
<ol>
<li><strong>全栈开发能力</strong>：掌握全栈开发流程，能够熟练使用NestJS、Go进行后端开发。对于MySQL和Redis，能够设计高效的数据库架构和执行优化</li>
<li><strong>Vue</strong>：熟悉Vue2、3生态以及相关工具、插件、依赖; 深入理解Vue源码了解其运行机制。擅长使用各种手段提升业务应用的性能和用户体验。</li>
<li><strong>React</strong>：熟悉React生态以及相关工具、插件、依赖; 深入理解内部机制，能够高效解决复杂的前端问题，并优化性能</li>
<li><strong>构建工具</strong>：擅长使用现代构建工具，如Webpack、Vite、Rspack，进行模块化开发。擅长使用优秀的前端工程化工具提升开发人员体验；能使用模块联邦等特性打造灵活高效的微前端架构，有效降低系统复杂性，提高项目的可维护性和扩展性</li>
<li><strong>UI设计与审美能力</strong>：具有一定的UI设计能力，能够设计出美观实用的用户界面；善于使用认知偏差知识与UI界面结合, 创造易于使用, 用户友好的产品逻辑和界面。</li>
<li><strong>运维技能与自动化部署</strong>：熟悉Linux、OpenResty、Docker的配置和优化。擅长利用sh、Python脚本提升运维效率和系统稳定性，具备自动化部署和系统维护能力。</li>
<li><strong>AI技术</strong>：熟练运用AI技术（如ChatGPT的GPT-4、Claude）, 系统学习过“谷歌大脑之父”的生成式AI课程, 善于引导AI在绝大部分领域给出高质量的回答。</li>
<li><strong>学习能力</strong>：乐于阅读开源项目的文档、源码, 理解其思想。有国际化视野和优质的信息来源, 有多种解决网络问题的能力: ),  能快速上手对业务有帮助的新兴方案。</li>
<li><strong>代码质量与规范</strong>：重视代码质量和规范，代码风格会优先追求可读性和性能，能快速融入团队的节奏。</li>
<li><strong>多平台开发经验</strong>：熟悉Web、移动端（小程序、公众号）和桌面应用（electron、tauri）的跨平台开发。</li>
</ol>
</li>
</ol>
<p>上述两种方式切记</p>
<blockquote>
<p>💡 写的时候要从「精通 - 熟练 - 了解」的顺序写，<strong>写出来的一定要经得住问，不会别乱写</strong></p>
</blockquote>
<h3><strong>项目经历</strong></h3>
<p>写3个代表的项目就行，不要写特别多没有营养的项目</p>
<p>**标题：**项目名 - 担任的什么（前端开发工程师）——时间（项目的开始 - 项目的结束/至今）</p>
<p>例如：</p>
<p>xxx商城 - 前端开发工程师 —— 2021年3月1日 - 2021年7月20日</p>
<p><strong>项目描述</strong>：写法为star原则，也就是Situation（情景）、Task（任务）、Action（行动）和Result（结果）。对应过来就是【S】这个项目的背景是什么，可以是项目介绍也可以是遇到的问题和难点，【T】需要做的工作是什么，在其中担任什么职责，【A】通过什么方式来解决这些问题的，【R】以及取得了什么指标可衡量的结果。</p>
<p>例如：</p>
<p>项目描述：项目时间非常紧，要在xxx的情况下做到xxx效果（这是S），我负责项目的xxx（研发/统筹/…），要在这个时间里让用户xxxxx（这是T），我做了xxx调研，选择用了xxx方式开发，在项目中做了xxx（骚操作/比较厉害的小技巧）（这是A），最终让项目在xxx之前完成，且bug量xxxx（这是R）</p>
<p><strong>项目职责</strong>：</p>
<p>❌<strong>不要写：</strong></p>
<ul>
<li>不要写“废话”，这里的废话并不是贬义，而是类似听君一席话，如听一席话的感觉，看上去写了，但是又好像啥都没写</li>
<li><strong>错误的示范</strong>：
<ol>
<li>我负责了导航栏的开发</li>
<li>我配合后端负责了xxx页面的开发</li>
<li>我准确的还原了设计稿</li>
</ol>
</li>
</ul>
<blockquote>
<p>💡 解释：<strong>以上错误在于</strong>：如果做不到这些，那就是工作都完不成，因为未来肯定会有类似的需求，你能完成，别人也能完成，那么你就没有竞争力，简历要突出自己的竞争力</p>
</blockquote>
<hr />
<p>✅<strong>要写：</strong></p>
<ul>
<li>因为你，项目达到了某种效果，是成就，而不是做了什么（我做了个导航栏，首页之类的，面试官根本不在乎你在上一家公司做了什么业务，他只关心你能给公司带来什么）</li>
<li><strong>正确的示范：</strong>
<ol>
<li>完成十多个基础组件封装，20多个公共函数，使功能性更契合业务</li>
<li>优化打包速度，打包速度提升384%（63s -&gt; 13s）</li>
<li>进行性能优化，首屏显示速度增加1233%（4s-&gt;0.3s）</li>
</ol>
</li>
</ul>
<blockquote>
<p>💡 解释：记住一点，**要写出具体的数字！！！**这在体现出的是你的价值，而具体的数字就是佐证。你除了可以完成需求以外，还能做到哪些人家做不到的事情，写出来了，竞争力就有了。这些东西并不一定非要是你做的，在你学过、见过的项目中，只要你能在合适的时机想到这个优化点，能说出来原理或者顺序，并且把这个优化/功能的，抄到别的项目并达成预期中的效果，那这个东西就是你的。你就可以往简历上写，而且大概率没人要求你用纸笔去默写这些，<strong>最重要的是要写成就，而不是做了什么</strong></p>
</blockquote>
<h3><strong>工作经历</strong></h3>
<p>用一个列表列出来，外包公司要注明！！！某些公司有背景调查，如果他查到给你交社保的并不是你写的公司，可能会对你有好感度的下降。有的公司比较介意短时间内多次跳槽的，不要写太多。</p>
<p>例如</p>
<ul>
<li>aaa公司（外包）- 前端开发工程师——2021年3月 - 至今</li>
<li>bbb公司 - 前端开发工程师——2020年3月 - 2020年12月</li>
</ul>
<h3><strong>个人描述</strong></h3>
<p><strong>写亮点! ! !</strong> 不要写什么“特别能吃苦”，因为这和写了“特别能吃”没什么区别，写一些实际的</p>
<p>例如</p>
<ol>
<li>有很强的信息获取能力，有较强的获得能力的能力</li>
<li>解决问题能力强，对工作负责（一个简短的例子佐证）</li>
<li>热爱阅读前端书籍（如果你真的读过的话）每一条不要超过大半行，写出例子佐证的，不要写空话</li>
<li>具有设计审美或者产品嗅觉灵敏，开发的产品体验非常好，干活细致</li>
</ol>
<h3><strong>教育经历</strong></h3>
<p>如果你的学历比较亮眼，可以放在很前面，甚至放在个人信息中。</p>
<p>反之可以放在最后，万一HR看见学历本来是不想要的，但是他被迫看完了你的简历，觉得还不错，可能就没那么介意学历了，这样就获得了一次面试机会</p>
<p>例如：</p>
<p>克莱登大学 - 汉语言文学  本科</p>
<p>克莱登大学 - 软件工程  硕士</p>
<p>简历部分结束</p>
<hr />
<h3><strong>后记：简历如何写</strong></h3>
<ol>
<li>简历三大原则：清晰，简短，必要，给面试官留下好印象</li>
<li>技术能力匹配：满足招聘方的要求，技术水平要达标</li>
<li>突出项目亮点：10 秒以内要让面试官发现亮点，有问下去的动力</li>
</ol>
<h3>简历三大原则</h3>
<ol>
<li><strong>清晰</strong>：简历是易于理解的，排版简单，比如学校和毕业时间，工作多少年，相应行业的工作经验，求职岗位等需要清晰明确</li>
<li><strong>简短</strong>：在工作汇报或者面试跳槽中，「突出重点」是非常重要的能力，有利于让面试官一下就明白你想表达的重点内容。非常重要的部分可以适当加粗，然后简历不要超过 2 页。这部分不知道怎么做的话，推荐大家看看 《金字塔原理》这本书，非常棒</li>
<li><strong>必要</strong>：简历上面只需要有必要的信息，能够帮助彼此最大化的节约时间，提升效率。保证简历里面的内容都是面试官感兴趣的。基本信息中像籍贯这些对面试来说不重要的内容就不用写了。有的人会在简历中放上 GitHub 或者博客链接，如果博客内容充实可以放上去，如果没什么内容，只是几个面经笔记的话，这种链接就不要放了，反而降分。贴了博客链接的话，面试官一般都会去看一眼的，所以博客内容要准备一下，避免忘记后面试时尴尬。有的人会把项目经历中相似的项目全部列出来，比如 A 管理后台、B 管理后台，其实这些工作内容没有多大差异性，写一个有代表性的就可以了。</li>
</ol>
<h3>技术能力匹配</h3>
<p>这部分突出深入的领域和掌握的核心技能，比如对性能优化、监控、工程化等有经验，掌握了 Vue / React 源码，掌握网络、浏览器等原理，熟悉数据结构和算法等。突出这些内容可以引导面试官向着你预设的战场前进，如果简历中让面试官找不到亮点，那就变成考试，他问你答，丧失主动权，面试官不是喜欢问八股文，而是看了简历找不到亮点只能问八股文</p>
<h3>突出项目亮点</h3>
<p>从项目中的一些点切入，把自己的价值做出来就值得写进简历中。</p>
<ol>
<li>大数据量优化</li>
<li>研发效率的提高</li>
<li>研发质量的提高</li>
<li>性能优化</li>
<li>用户体验优化</li>
<li>复杂 &amp; 新场景</li>
</ol>
<h3><strong>谈薪方法</strong></h3>
<p><a href="https://www.bilibili.com/video/BV1ou411f7R4/">https://www.bilibili.com/video/BV1ou411f7R4/</a></p>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2023-03-31T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[正则匹配汉字]]></title>
        <id>https://lainbo.dev/posts/regex-zh/</id>
        <link href="https://lainbo.dev/posts/regex-zh/"/>
        <updated>2023-01-26T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[正则匹配汉字可能并不需要写非常长的表达式]]></summary>
        <content type="html"><![CDATA[<p>当我们检查字符串中是否包含汉字的时候，或许会考虑使用正则来做</p>
<p>搜索引擎会告诉我们一个<a href="https://stackoverflow.com/questions/21109011/javascript-unicode-string-chinese-character-but-no-punctuation/21113538#21113538">答案</a>，他很好用</p>
<pre><code>const 纯汉字reg = /[\u4E00-\u9FCC\u3400-\u4DB5\uFA0E\uFA0F\uFA11\uFA13\uFA14\uFA1F\uFA21\uFA23\uFA24\uFA27-\uFA29]|[\uD840-\uD868][\uDC00-\uDFFF]|\uD869[\uDC00-\uDED6\uDF00-\uDFFF]|[\uD86A-\uD86C][\uDC00-\uDFFF]|\uD86D[\uDC00-\uDF34\uDF40-\uDFFF]|\uD86E[\uDC00-\uDC1D]/
</code></pre>
<pre><code>const 汉字标点reg = /[\u3002|\uFF1F|\uFF01|\uFF0C|\u3001|\uFF1B|\uFF1A|\u201C|\u201D|\u2018|\u2019|\uFF08|\uFF09|\u300A|\u300B|\u3008|\u3009|\u3010|\u3011|\u300E|\u300F|\u300C|\u300D|\uFE43|\uFE44|\u3014|\u3015|\u2026|\u2014|\uFF5E|\uFE4F|\uFFE5]/
</code></pre>
<pre><code>const 汉字和标点reg = /[\u4E00-\u9FA5|\u3002|\uFF1F|\uFF01|\uFF0C|\u3001|\uFF1B|\uFF1A|\u201C|\u201D|\u2018|\u2019|\uFF08|\uFF09|\u300A|\u300B|\u3008|\u3009|\u3010|\u3011|\u300E|\u300F|\u300C|\u300D|\uFE43|\uFE44|\u3014|\u3015|\u2026|\u2014|\uFF5E|\uFE4F|\uFFE5|[\u3400-\u4DB5\u4E00-\u9FEA\uFA0E\uFA0F\uFA11\uFA13\uFA14\uFA1F\uFA21\uFA23\uFA24\uFA27-\uFA29]|[\uD840-\uD868\uD86A-\uD86C\uD86F-\uD872\uD874-\uD879][\uDC00-\uDFFF]|\uD869[\uDC00-\uDED6\uDF00-\uDFFF]|\uD86D[\uDC00-\uDF34\uDF40-\uDFFF]|\uD86E[\uDC00-\uDC1D\uDC20-\uDFFF]|\uD873[\uDC00-\uDEA1\uDEB0-\uDFFF]|\uD87A[\uDC00-\uDFE0]]/
</code></pre>
<p>但是现在我们有了一个<a href="https://stackoverflow.com/questions/21109011/javascript-unicode-string-chinese-character-but-no-punctuation/61151122#61151122">更好的解决方案</a></p>
<pre><code>const 汉字reg = /\p{Script=Han}/u
!!'你好'.match(/\p{Script=Han}/u) // true
</code></pre>
<p>或者我们可以加上汉字的符号</p>
<pre><code>const 汉字和汉字符号正则 = /\p{Script=Han}|[\u3002|\uFF1F|\uFF01|\uFF0C|\u3001|\uFF1B|\uFF1A|\u201C|\u201D|\u2018|\u2019|\uFF08|\uFF09|\u300A|\u300B|\u3008|\u3009|\u3010|\u3011|\u300E|\u300F|\u300C|\u300D|\uFE43|\uFE44|\u3014|\u3015|\u2026|\u2014|\uFF5E|\uFE4F|\uFFE5]/u
</code></pre>
<p>它被称为<a href="https://developer.mozilla.org/zh-CN/docs/Web/JavaScript/Guide/Regular_Expressions/Unicode_Property_Escapes">Unicode 属性转义</a>，已经在<a href="https://developer.mozilla.org/en-US/docs/Web/JavaScript/Guide/Regular_Expressions#browser_compatibility">Chrome 64、Firefox 79、Safari 11.1 和 Node.js 10</a>中可用。</p>
<p>所有可用的<a href="https://www.regular-expressions.info/unicode.html">在这里</a></p>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2023-01-26T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[纯CSS头像组件内文字自适应]]></title>
        <id>https://lainbo.dev/posts/avatar-font/</id>
        <link href="https://lainbo.dev/posts/avatar-font/"/>
        <updated>2022-11-02T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[用纯 CSS 实现 Ant Design 头像里文字随字数自动缩放]]></summary>
        <content type="html"><![CDATA[<p>ant design的头像组件中有一个效果就是会根据头像内文字的数量自动缩放文字大小</p>
<p><img src="https://i0.hdslb.com/bfs/article/3b0df3369d85b0f52e45c085ad2b5d0830109107.png" alt="这是Ant Design的效果，很棒" /></p>
<p>这是Ant Design的效果，很棒</p>
<p>现在我们有了CSS的容器查询单位（Chrome 105+支持）之后，可以轻松的只使用CSS实现这个效果</p>
<p>**为了大家比较方便的测试，这里给出HTML代码，方便直接复制拿去测试，**这里使用了CDN上的vue2和UnoCSS的运行时，这只是方便写Demo，原理并不依赖这俩，没有这两个依赖你依旧可以将它用在任何地方。</p>
<pre><code>&lt;!DOCTYPE html&gt;
&lt;html lang="zh-CN"&gt;

&lt;head&gt;
  &lt;meta charset="UTF-8"&gt;
  &lt;meta http-equiv="X-UA-Compatible" content="IE=edge"&gt;
  &lt;meta name="viewport" content="width=device-width, initial-scale=1.0"&gt;
  &lt;script src="https://cdn.jsdelivr.net/npm/@unocss/runtime"&gt;&lt;/script&gt;
  &lt;script src="https://cdn.jsdelivr.net/npm/vue@2"&gt;&lt;/script&gt;
  &lt;title&gt;头像内文字自适应Demo&lt;/title&gt;
  &lt;style&gt;
    .avator {
      /* flex居中 */
      display: flex;
      align-items: center;
      justify-content: center;

      /* 宽高 */
      width: 50px;
      height: 50px;

      /* 圆角颜色 */
      border-radius: 8px;
      background: #eaeaea;

      /* 不允许文字换行 */
      white-space: nowrap;
    }

    .avator-inner {
      position: relative;
    }

    .avator-inner::before {
      content: attr(alt);
      visibility: hidden;
      font-size: 40px;
    }

    /* 利用定位，将这个盒子设置的和外面的.avator-inner设置成一样大 */
    /* 也就是avator-inner::before由文字撑开，avator-inner和自己的before一样大，avator-container利用定位和avator-inner一样大 */
    .avator-container {
      position: absolute;
      inset: 0;
      container-type: inline-size;
      text-align: center;
      display: flex;
      justify-content: center;
      align-items: center;
    }

    .avator-container span {
      /* 用cqw做到与宽度成反比，也就是文字越多，avator-inner的before越大，这里的font-size也就越小 */
      font-size: calc(24px - 10cqw);
      /* 因为avator-container是定位在中间的，所以和边界没有距离，这加padding写与边界的距离 */
      display: inline-block;
      padding: 0 2px;

      overflow: hidden;
      max-width: 40px;
      text-overflow: ellipsis;

    }

  &lt;/style&gt;
&lt;/head&gt;

&lt;body&gt;
  &lt;div id="app" class="min-h-screen"&gt;
    &lt;main class="grid place-content-center gap-16px"&gt;
      
      
      &lt;div class="avator" v-for="(item, index) in arr" :key="index"&gt;

        
        &lt;div class="avator-inner" :alt="item"&gt;
          &lt;div class="avator-container"&gt;
            &lt;span&gt;{{item}}&lt;/span&gt;
          &lt;/div&gt;
        &lt;/div&gt;
      &lt;/div&gt;
    &lt;/main&gt;
  &lt;/div&gt;

  &lt;script&gt;
    let vm = new Vue({
      el: '#app',
      data() {
        return {
          arr: ['我', '名字', '三个字', '有四个字', 'A', 'AB', 'ABC', 'ABCD', 'English']
        }
      }
    })
  &lt;/script&gt;
&lt;/body&gt;

&lt;/html&gt;
</code></pre>
<hr />
<p>下面是可以真实运行的代码</p>
<p><a href="https://codepen.io/lainbojc/pen/KKxoWpz">https://codepen.io/lainbojc/pen/KKxoWpz</a></p>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2022-11-02T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[六种算法思想]]></title>
        <id>https://lainbo.dev/posts/six-algorithm/</id>
        <link href="https://lainbo.dev/posts/six-algorithm/"/>
        <updated>2022-09-28T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[从递归到动态规划，六种常见算法思想入门]]></summary>
        <content type="html"><![CDATA[<h2>递归算法</h2>
<h3>算法策略</h3>
<p>递归算法是一种直接或者间接调用自身函数或者方法的算法。</p>
<p>递归算法的实质是把问题分解成规模缩小的同类问题的子问题，然后递归调用方法来表示问题的解。递归算法对解决一大类问题很有效，它可以使算法简洁和易于理解。</p>
<p><strong>优缺点：</strong></p>
<ul>
<li>优点：实现简单易上手</li>
<li>缺点：递归算法对常用的算法如普通循环等，运行效率较低；并且在递归调用的过程当中系统为每一层的返回点、局部量等开辟了栈来存储，递归太深，容易发生栈溢出。</li>
</ul>
<h3>适用场景</h3>
<p>递归算法一般用于解决三类问题：</p>
<ul>
<li>数据的定义是按递归定义的。（斐波那契数列）</li>
<li>问题解法按递归算法实现。（回溯）</li>
<li>数据的结构形式是按递归定义的。（树的遍历，图的搜索）</li>
</ul>
<p><strong>递归的解题策略：</strong></p>
<ul>
<li>第一步：明确你这个函数的输入输出，先不管函数里面的代码什么，而是要先明白，你这个函数的输入是什么，输出为何什么，功能是什么，要完成什么样的一件事。</li>
<li>第二步：寻找递归结束条件，我们需要找出什么时候递归结束，之后直接把结果返回</li>
<li>第三步：明确递归关系式，怎么通过各种递归调用来组合解决当前问题</li>
</ul>
<h3>使用递归算法求解的一些经典问题</h3>
<ul>
<li>斐波那契数列</li>
<li>汉诺塔问题</li>
<li>树的遍历及相关操作</li>
</ul>
<h3>DOM树为例</h3>
<p>下面以以 DOM 树为例，实现一个 <code>document.getElementById</code> 功能</p>
<p>由于DOM是一棵树，而树的定义本身就是用的递归定义，所以用递归的方法处理树，会非常地简单自然。</p>
<p><strong>第一步：明确你这个函数的输入输出</strong></p>
<p>从 DOM 树根节点一层层往下递归，判断当前节点的 id 是否是我们要寻找的 <code>id='d-cal'</code></p>
<p>输入：DOM 树根节点 <code>document</code> ，我们要寻找的 <code>id='d-cal'</code></p>
<p>输出：返回满足 <code>id='sisteran'</code> 的子结点</p>
<pre><code>function getElementById(node, id){}
</code></pre>
<p><strong>第二步：寻找递归结束条件</strong></p>
<p>从document开始往下找，对所有子结点递归查找他们的子结点，一层一层地往下查找：</p>
<ul>
<li>如果当前结点的 id 符合查找条件，则返回当前结点</li>
<li>如果已经到了叶子结点了还没有找到，则返回 null</li>
</ul>
<pre><code>function getElementById(node, id){
    // 当前结点不存在，已经到了叶子结点了还没有找到，返回 null
    if(!node) return null
    // 当前结点的 id 符合查找条件，返回当前结点
    if(node.id === id) return node
}
</code></pre>
<p><strong>第三步：明确递归关系式</strong></p>
<p>当前结点的 id 不符合查找条件，递归查找它的每一个子结点</p>
<pre><code>function getElementById(node, id){
    // 当前结点不存在，已经到了叶子结点了还没有找到，返回 null
    if(!node) return null
    // 当前结点的 id 符合查找条件，返回当前结点
    if(node.id === id) return node
    // 前结点的 id 不符合查找条件，继续查找它的每一个子结点
    for(var i = 0; i &lt; node.childNodes.length; i++){
        // 递归查找它的每一个子结点
        var found = getElementById(node.childNodes[i], id);
        if(found) return found;
    }
    return null;
}
</code></pre>
<p>就这样，我们的一个 <code>document.getElementById</code> 功能已经实现了：</p>
<pre><code>function getElementById(node, id){
    if(!node) return null;
    if(node.id === id) return node;
    for(var i = 0; i &lt; node.childNodes.length; i++){
        var found = getElementById(node.childNodes[i], id);
        if(found) return found;
    }
    return null;
}
getElementById(document, "d-cal");
</code></pre>
<p>使用递归的优点是代码简单易懂，缺点是效率比不上非递归的实现。Chrome浏览器的查DOM是使用非递归实现。非递归要怎么实现呢？如下代码：</p>
<pre><code>function getByElementId(node, id){
    //遍历所有的Node
    while(node){
        if(node.id === id) return node;
        node = nextElement(node);
    }
    return null;
}
</code></pre>
<p>还是依次遍历所有的 <code>DOM</code> 结点，只是这一次改成一个 <code>while</code> 循环，函数 <code>nextElement</code> 负责找到下一个结点。所以关键在于这个 <code>nextElement</code> 如何实现非递归查找结点功能：</p>
<pre><code>// 深度遍历
function nextElement(node){
    // 先判断是否有子结点
    if(node.children.length) {
        // 有则返回第一个子结点
        return node.children[0];
    }
    // 再判断是否有相邻结点
    if(node.nextElementSibling){
        // 有则返回它的下一个相邻结点
        return node.nextElementSibling;
    }
    // 否则，往上返回它的父结点的下一个相邻元素，相当于上面递归实现里面的for循环的i加1
    while(node.parentNode){
        if(node.parentNode.nextElementSibling) {
            return node.parentNode.nextElementSibling;
        }
        node = node.parentNode;
    }
    return null;
}
</code></pre>
<p>在控制台里面运行这段代码，同样也可以正确地输出结果。不管是非递归还是递归，它们都是深度优先遍历。 实际上 <code>getElementById</code> 浏览器是用的一个哈希 map 存储的，根据 id 直接映射到 DOM 结点，而 <code>getElementsByClassName</code> 就是用的这样的非递归查找。</p>
<h2>分治算法</h2>
<h3>算法策略</h3>
<p>在计算机科学中，分治算法是一个很重要的算法，快速排序、归并排序等都是基于分治策略进行实现的，所以，建议理解掌握它。</p>
<p>分治，顾名思义，就是 <strong>分而治之</strong> ，将一个复杂的问题，分成两个或多个相似的子问题，在把子问题分成更小的子问题，直到更小的子问题可以简单求解，求解子问题，则原问题的解则为阿子问题解的合并。</p>
<h3>适用场景</h3>
<p>当出现满足以下条件的问题，可以尝试只用分治策略进行求解：</p>
<ul>
<li>原始问题可以分成多个相似的子问题</li>
<li>子问题可以很简单的求解</li>
<li>原始问题的解是子问题解的合并</li>
<li>各个子问题是相互独立的，不包含相同的子问题</li>
</ul>
<p><strong>分治的解题策略：</strong></p>
<ul>
<li>第一步：分解，将原问题分解为若干个规模较小，相互独立，与原问题形式相同的子问题</li>
<li>第二步：解决，解决各个子问题</li>
<li>第三步：合并，将各个子问题的解合并为原问题的解</li>
</ul>
<h3><strong>使用分治法求解的一些经典问题</strong></h3>
<ul>
<li>二分查找</li>
<li>归并排序</li>
<li>快速排序</li>
<li>汉诺塔问题</li>
<li>React 时间分片</li>
</ul>
<h3>二分查找</h3>
<p>也称折半查找算法，它是一种简单易懂的快速查找算法。例如我随机写0-100之间的一个数字，让你猜我写的是什么？你每猜一次，我就会告诉你猜的大了还是小了，直到猜中为止。</p>
<p><strong>第一步：分解</strong></p>
<p>每次猜拳都把上一次的结果分出大的一组和小的一组，两组相互独立</p>
<ul>
<li>选择数组中的中间数</li>
</ul>
<pre><code>function binarySearch(items, item) {
    // low、mid、high将数组分成两组
    var low = 0,
        high = items.length - 1,
        mid = Math.floor((low+high)/2),
        elem = items[mid]
    // ...
}
</code></pre>
<p><strong>第二步：解决子问题</strong></p>
<p>查找数与中间数对比</p>
<ul>
<li>比中间数低，则去中间数左边的子数组中寻找；</li>
<li>比中间数高，则去中间数右边的子数组中寻找；</li>
<li>相等则返回查找成功</li>
</ul>
<pre><code>while(low &lt;= high) {
 if(elem &lt; item) { // 比中间数高
  low = mid + 1
 } else if(elem &gt; item) { // 比中间数低
  high = mid - 1
 } else { // 相等
     return mid
 }
}
</code></pre>
<p><strong>第三步：合并</strong></p>
<pre><code>function binarySearch(items, item) {
    var low = 0,
        high = items.length - 1,
        mid, elem
    while(low &lt;= high) {
        mid = Math.floor((low+high)/2)
        elem = items[mid]
        if(elem &lt; item) {
            low = mid + 1
        } else if(elem &gt; item) {
            high = mid - 1
        } else {
            return mid
        }
    }
    return -1
}
</code></pre>
<p>最后，二分法只能应用于数组有序的情况，如果数组无序，二分查找就不能起作用了</p>
<pre><code>function binarySearch(items, item) {
    // 快排
    quickSort(items)
    var low = 0,
        high = items.length - 1,
        mid, elem
    while(low &lt;= high) {
        mid = Math.floor((low+high)/2)
        elem = items[mid]
        if(elem &lt; item) {
            low = mid + 1
        } else if(elem &gt; item) {
            high = mid - 1
        } else {
            return mid
        }
    }
    return -1
}

// 测试
var arr = [2,3,1,4]
binarySearch(arr, 3)
// 2

binarySearch(arr, 5)
// -1
</code></pre>
<h2>贪心算法</h2>
<h3>算法策略</h3>
<p>贪心算法，故名思义，总是做出当前的最优选择，即期望通过局部的最优选择获得整体的最优选择。</p>
<p>某种意义上说，贪心算法是很贪婪、很目光短浅的，它不从整体考虑，仅仅只关注当前的最大利益，所以说它做出的选择仅仅是某种意义上的局部最优，但是贪心算法在很多问题上还是能够拿到最优解或较优解，所以它的存在还是有意义的。</p>
<h3>适用场景</h3>
<p>在日常生活中，我们使用到贪心算法的时候还是挺多的，例如：</p>
<p>从100章面值不等的钞票中，抽出 10 张，怎样才能获得最多的价值？</p>
<p>我们只需要每次都选择剩下的钞票中最大的面值，最后一定拿到的就是最优解，这就是使用的贪心算法，并且最后得到了整体最优解。</p>
<p>但是，我们任然需要明确的是，期望通过局部的最优选择获得整体的最优选择，仅仅是期望而已，也可能最终得到的结果并不一定不能是整体最优解。</p>
<p>那么一般在什么时候可以尝试选择使用贪心算法喃？</p>
<p>当满足一下条件时，可以使用：</p>
<ul>
<li>原问题复杂度过高</li>
<li>求全局最优解的数学模型难以建立或计算量过大</li>
<li>没有太大必要一定要求出全局最优解，“比较优”就可以</li>
</ul>
<p>如果使用贪心算法求最优解，可以按照以下 <strong>步骤求解</strong> ：</p>
<ul>
<li>首先，我们需要明确什么是最优解（期望）</li>
<li>然后，把问题分成多个步骤，每一步都需要满足：</li>
<li>可行性：每一步都满足问题的约束</li>
<li>局部最优：每一步都做出一个局部最优的选择</li>
<li>不可取消：选择一旦做出，在后面遇到任何情况都不可取消</li>
<li>最后，叠加所有步骤的最优解，就是全局最优解</li>
</ul>
<h3>经典案例：活动选择问题</h3>
<p>使用贪心算法求解的经典问题有：</p>
<ul>
<li>最小生成树算法</li>
<li>单源最短路径的 Dijkstra 算法</li>
<li>Huffman 压缩编码</li>
<li>背包问题</li>
<li>活动选择问题等</li>
</ul>
<h2>回溯算法</h2>
<h3>算法策略</h3>
<p>回溯算法是一种搜索法，试探法，它会在每一步做出选择，一旦发现这个选择无法得到期望结果，就回溯回去，重新做出选择。深度优先搜索利用的就是回溯算法思想。</p>
<h3>适用场景</h3>
<p>回溯算法很简单，它就是不断的尝试，直到拿到解。它的这种算法思想，使它通常用于解决广度的搜索问题，即从一组可能的解中，选择一个满足要求的解。</p>
<h3>使用回溯算法的经典案例</h3>
<ul>
<li>深度优先搜索</li>
<li>0-1背包问题</li>
<li>正则表达式匹配</li>
<li>八皇后</li>
<li>数独</li>
<li>全排列</li>
</ul>
<p>这里以正则表达式匹配为例，介绍一下</p>
<h3>正则表达式匹配</h3>
<pre><code>var string = "abbc"
var regex = /ab{1,3}c/
console.log( string.match(regex) )
// \\["abbc", index: 0, input: "abbc", groups: undefined\\]
</code></pre>
<p>它的匹配过程：</p>
<p><img src="https://i0.hdslb.com/bfs/article/dee54169cae4dbc122946a69e4570fe330109107.png" alt="" /></p>
<p>在第 5 步匹配失败，此时 <code>b{1,3}</code> 已经匹配到了两个 <code>b</code> 正在尝试第三个 <code>b</code> ，结果发现接下来是 <code>c</code> 。此时就需要回溯到上一步， <code>b{1,3}</code> 匹配完毕（匹配到了 <code>bb</code> ），然后再匹配 <code>c</code> ，匹配到了 <code>c</code> 匹配结束。</p>
<h2>动态规划</h2>
<h3>算法策略</h3>
<p>动态规划也是将复杂问题分解成小问题求解的策略，与分治算法不同的是，分治算法要求各子问题是相互独立的，而动态规划各子问题是相互关联的。</p>
<p>所以，动态规划适用于子问题重叠的情况，即不同的子问题具有公共的子子问题，在这种情况下，分治策略会做出很多不必要的工作，它会反复求解那些公共子子问题，而动态规划会对每个子子问题求解一次，然后保存在表格中，如果遇到一致的问题，从表格中获取既可，所以它无需求解每一个子子问题，避免了大量的不必要操作。</p>
<h3>适用场景</h3>
<p>动态规划适用于求解最优解问题，比如，从面额不定的100个硬币中任意选取多个凑成10元，求怎样选取硬币才可以使最后选取的硬币数最少又刚好凑够了10元。这就是一个典型的动态规划问题。它可以分成一个个子问题（每次选取硬币），每个子问题又有公共的子子问题（选取硬币），子问题之间相互关联（已选取的硬币总金额不能超过10元），边界条件就是最终选取的硬币总金额为 10 元。</p>
<p>针对上例，也许你也可以说，我们可以使用回溯算法，不断的去试探，但回溯算法是使用与求解广度的解（满足要求的解），如果是用回溯算法，我们需要尝试去找所有满足条件的解，然后找到最优解，时间复杂度为 O(2^n^) ，这性能是相当差的。大多数适用于动态规划的问题，都可以使用回溯算法，只是使用回溯算法的时间复杂度比较高而已。</p>
<p>最后，总结一下，我们使用动态规划求解问题时，需要遵循以下几个重要步骤：</p>
<ul>
<li>定义子问题</li>
<li>实现需要反复执行解决的子子问题部分</li>
<li>识别并求解出边界条件</li>
</ul>
<h3>使用动态规划求解的一些经典问题</h3>
<ul>
<li>爬楼梯问题：假设你正在爬楼梯。需要 n 阶你才能到达楼顶。每次你可以爬 1 或 2 个台阶。你有多少种不同的方法可以爬到楼顶呢？</li>
<li>背包问题：给出一些资源（有总量及价值），给一个背包（有总容量），往背包里装资源，目标是在背包不超过总容量的情况下，装入更多的价值</li>
<li>硬币找零：给出面额不定的一定数量的零钱，以及需要找零的钱数，找出有多少种找零方案</li>
<li>图的全源最短路径：一个图中包含 u、v 顶点，找出从顶点 u 到顶点 v 的最短路径</li>
<li>最长公共子序列：找出一组序列的最长公共子序列（可由另一序列删除元素但不改变剩下元素的顺序实现）</li>
</ul>
<p>这里以最长公共子序列为例。</p>
<h3>爬楼梯问题</h3>
<p>这里以动态规划经典问题爬楼梯问题为例，介绍求解动态规划问题的步骤。</p>
<p><strong>第一步：定义子问题</strong></p>
<p>如果用 <code>dp[n]</code> 表示第 <code>n</code> 级台阶的方案数，并且由题目知：最后一步可能迈 2 个台阶，也可迈 1 个台阶，即第 <code>n</code> 级台阶的方案数等于第 <code>n-1</code> 级台阶的方案数加上第 <code>n-2</code> 级台阶的方案数</p>
<p><strong>第二步：实现需要反复执行解决的子子问题部分</strong></p>
<pre><code>dp[n] = dp[n−1] + dp[n−2]
</code></pre>
<p><strong>第三步：识别并求解出边界条件</strong></p>
<pre><code>// 第 0 级 1 种方案
dp[0]=1
// 第 1 级也是 1 种方案
dp[1]=1
</code></pre>
<p><strong>最后一步：把尾码翻译成代码，处理一些边界情况</strong></p>
<pre><code>let climbStairs = function(n) {
    let dp = [1, 1]
    for(let i = 2; i &lt;= n; i++) {
        dp[i] = dp[i - 1] + dp[i - 2]
    }
    return dp[n]
}
</code></pre>
<p><strong>复杂度分析：</strong></p>
<ul>
<li>时间复杂度：O(n)</li>
<li>空间复杂度：O(n)</li>
</ul>
<p><strong>优化空间复杂度：</strong></p>
<pre><code>let climbStairs = function(n) {
    let res = 1, n1 = 1, n2 = 1
    for(let i = 2; i &lt;= n; i++) {
        res = n1 + n2
        n1 = n2
        n2 = res
    }
    return res
}
</code></pre>
<p>空间复杂度：O(1)</p>
<h2>枚举算法</h2>
<h3>算法策略</h3>
<p>枚举算法的思想是：将问题的所有可能的答案一一列举，然后根据条件判断此答案是否合适，保留合适的，丢弃不合适的。</p>
<h3>解题思路</h3>
<ul>
<li>确定枚举对象、枚举范围和判定条件。</li>
<li>逐一列举可能的解，验证每个解是否是问题的解。</li>
</ul>
<h2>总结</h2>
<p>算法是编程的"里子"，不管你是前端还是后端，作为一名计算机工程师，具备一定的算法能力，是一种基本要求。</p>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2022-09-28T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[函数式编程术语]]></title>
        <id>https://lainbo.dev/posts/functional-programing-jargon/</id>
        <link href="https://lainbo.dev/posts/functional-programing-jargon/"/>
        <updated>2022-08-06T00:00:00.000Z</updated>
        <summary type="html"><![CDATA[函数式编程常见术语的解释和代码示例]]></summary>
        <content type="html"><![CDATA[<ul>
<li><a href="http://www.ruanyifeng.com/blog/2017/02/fp-tutorial.html">函数式编程入门教程</a></li>
<li><a href="https://github.com/MostlyAdequate/mostly-adequate-guide">mostly-adequate-guide (10749 stars)</a></li>
<li><a href="https://github.com/llh911001/mostly-adequate-guide-chinese">mostly-adequate-guide-chinese (602 stars)</a></li>
<li><a href="https://github.com/fantasyland/fantasy-land">fantasy-land</a></li>
</ul>
<p>函数式编程有许多优势，由此越来越受欢迎。然而每个编程范式 (paradigm) 都有自己唯一的术语，函数式编程也不例外。我们提供一张术语表，希望使你学习函数式编程变得容易些。</p>
<p>示例均为 javascript (ES2015)。<a href="https://github.com/hemanth/functional-programming-jargon/wiki/Why-JavaScript%3F">为什么使用JavaScript?</a></p>
<p>如果适用，本篇文档使用定义在 <a href="https://github.com/fantasyland/fantasy-land">Fantasy Land spec</a> 中的术语。</p>
<h2>Arity</h2>
<p>函数参数的个数。来自于单词 unary(一元), binary(二元), ternary(三元) 等等。这个单词是由 -ary 与 -ity 两个后缀拼接而成。例如，加法函数有两个参数，因此它被定义为二元函数(<code>binary function</code>)，或者说它的 <code>arity</code> 是2。它也被那些更喜欢希腊词根而非拉丁词根的人称为 <code>dyadic</code>。同样地，带有可变数量的参数的函数被称为 <code>variadic</code>，而二元函数只能且必须带两个参数，尽管有柯里化(currying)和偏函数应用(partial application)的存在(见下文)。</p>
<pre><code>const sum = (a, b) =&gt; a + b

const arity = sum.length
console.log(arity)        // 2

// 函数sum的arity为2。
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>const sum = (a, b) =&gt; a + bconst arity = sum.lengthconsole.log(arity)        // 2
</code></pre>
</li>
</ul>
<h2>高阶函数 (Higher-Order Function / HOF)</h2>
<p>以函数为参数或/和返回值的函数。</p>
<pre><code>const filter = (predicate, xs) =&gt; xs.filter(predicate)

const is = (type) =&gt; (x) =&gt; Object(x) instanceof type

filter(is(Number), [0, '1', 2, null]) // 0, 2
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>const filter = (predicate, xs) =&gt; xs.filter(predicate)const is = (type) =&gt; (x) =&gt; Object(x) instanceof typeconst results = filter(is(Number), [0, '1', 2, null])console.log(results)  // 0, 2
</code></pre>
</li>
</ul>
<h2>闭包 (Closure)</h2>
<p>闭包是访问在其作用域外的变量的一种方式。正式地说，闭包是一种用于实现词法作用域命名绑定的技术。它是存储一个函数和它的环境的一种方法。</p>
<p>闭包是一个作用域，它会捕获函数的局部变量，因此即使执行过程已经移出了定义它的那个代码块，也可以访问它们。也就是说，它们允许在声明变量的代码块已经执行完成之后，还是可以引用这个作用域。</p>
<pre><code>const addTo = x =&gt; y =&gt; x + y;
var addToFive = addTo(5);
addToFive(3); //返回 8
</code></pre>
<p>函数<code>addTo()</code>返回了一个函数(在内部调用了<code>add()</code>)，我们将它保存在了一个叫做<code>addToFive</code>的变量中，并且柯里化地用一个参数5来调用它。</p>
<p>理想情况下，当函数<code>addTo</code>执行完成后，它的作用域，包括本地变量add(即+)，x，y，都应该无法访问了。但是，<code>addToFive()</code>的调用返回了8。这说明，<code>addTo</code>函数的状态被保存了，即使在代码块已经完成执行之后。否则，就不会知道<code>addTo</code>曾经被<code>addTo(5)</code>这样调用过，且x的值被设为了5。</p>
<p>词法作用域(lexical scoping)是它能找到x和add这两个已经完成执行的父级私有变量的原因。这个值就称为闭包。</p>
<p>栈和函数的词法作用域被以父函数的引用的形式存储。这可以防止闭包和底层的变量被垃圾回收(因为至少有一个对它的有效引用)。</p>
<p>Lambda Vs 闭包：Lambda本质上是一个内联定义的函数，而不是声明函数的标准方法。Lambda经常可以作为对象被传递。</p>
<p>闭包是通过引用其主体外部的字段来将其周围的状态包裹进来的函数。被包裹的状态在闭包调用期间保持不变。</p>
<h2>偏函数应用 (Partial Application)</h2>
<p>“部分地”应用一个函数，即预设原始函数的部分参数来创建一个新的函数。</p>
<pre><code>// 创建偏函数，固定一些参数
const partial = (f, ...args) =&gt;
  // 返回一个带有剩余参数的函数
  (...moreArgs) =&gt;
    // 调用原始函数
    f(...args, ...moreArgs)

const add3 = (a, b, c) =&gt; a + b + c // (c) =&gt; 2 + 3 + c

// 部分地将`2`和`3`应用于`add3`，得到一个只有一个参数的函数
const fivePlus = partial(add3, 2, 3)

fivePlus(4)  // 9
</code></pre>
<p>也可以使用 <code>Function.prototype.bind</code> 实现偏函数。</p>
<pre><code>const add1More = add3.bind(null, 2, 3) // (c) =&gt; 2 + 3 + c
</code></pre>
<p>偏函数应用通过对复杂的函数填充一部分数据来构成一个简单的函数。柯里化就是自动实现的偏函数。</p>
<ul>
<li>
<p>示例</p>
<pre><code>const partical = (f, ...args) =&gt; (...moreArgs) =&gt; f(...args, ...moreArgs)const add3 = (a, b, c) =&gt; a + b + c// (...args) =&gt; add3(2, 3, ...args)// (c) =&gt; 2 + 3 + cconst fivePlus = partical(add3, 2, 3)console.log(fivePlus(4))  // 9const add1More = add3.bind(null, 2, 3)console.log(add1More(4))
</code></pre>
</li>
</ul>
<h2>柯里化 (Currying)</h2>
<p>将一个多元函数转变为一元函数的过程。 每当函数被调用时，它仅仅接收一个参数并且返回带有一个参数的函数，直到传递完所有的参数。</p>
<pre><code>const sum = (a, b) =&gt; a + b

const curriedSum = (a) =&gt; (b) =&gt; a + b

curriedSum(3)(4)         // 7

const add2 = curriedSum(2)

add2(10)     // 12
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>const sum = (a, b) =&gt; a + bconst curriedSum = (a) =&gt; (b) =&gt; a + bconsole.log(curriedSum(3)(4))         // 7const add2 = curriedSum(2)console.log(add2(10))     // 12
</code></pre>
</li>
</ul>
<h2>自动柯里化 (Auto Currying)</h2>
<p>将一个包含多个参数的函数转换成另一个函数，这个函数如果被给到的参数少于正确的数量，就会返回一个接受剩余参数的函数。</p>
<p>lodash &amp; Ramda 有一个<code>curry</code>函数可以做到这一点。</p>
<pre><code>const add = (x, y) =&gt; x + y

const curriedAdd = _.curry(add)

curriedAdd(1, 2)   // 3
curriedAdd(1)(2)   // 3
curriedAdd(1)      // (y) =&gt; 1 + y
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>const _ = require('lodash')const add = (x, y) =&gt; x + yconst curriedAdd = _.curry(add)console.log(curriedAdd(1, 2))   // 3console.log(curriedAdd(1)(2))   // 3// console.log(curriedAdd(1))      // (y) =&gt; 1 + yconst add4 = (a, b, c, d) =&gt; a + b + c + dconst curriedAdd4 = _.curry(add4)console.log(curriedAdd4(1)(2)(3)(4))console.log(curriedAdd4(1, 2)(3, 4))console.log(curriedAdd4(1, 2, 3)(4))// --------- sourece code ------------// curry(add) -&gt; (a) =&gt; (b) =&gt; add(a, b)//            -&gt; (a, b) =&gt; add(a, b)const partical = (f, ...args) =&gt; (...moreargs) =&gt; f(...args, ...moreargs)const curry = function (add, len = add.length) {  return (...args) =&gt; len - args.length === 0 ? add(...args) : curry(partical(add, ...args), len - args.length)}const add6 = (a, b, c, d, e, f) =&gt; a + b + c + d + e + fconsole.log(curry(add6)(1, 2, 3)(4, 5, 6))console.log(curry(add6)(1)(2, 3)(4, 5, 6))console.log(curry(add6)(1, 2)(3)(4, 5, 6))console.log(curry(add6)(1, 2)(3)(4)(5, 6))
</code></pre>
</li>
</ul>
<h2>函数组合 (Function Composition)</h2>
<p>把两个函数放在一起形成第三个函数的行为，一个函数的输入为另一个函数的输出。</p>
<pre><code>const compose = (f, g) =&gt; (a) =&gt; f(g(a))    // 定义
const floorAndToString = compose((val) =&gt; val.toString(), Math.floor) // 使用
floorAndToString(12.12)   // '12'
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>const compose = (...f) =&gt; (a) =&gt; {  const len = f.length  let r = a  for (let i = len - 1; i &gt;= 0; i--)  {    r = f[i](r)  }  return r}const r1 = compose(x =&gt; 3 * x, Number, val =&gt; val.toString(), Math.floor)console.log(r1(12.22))   // '12'
</code></pre>
</li>
</ul>
<h2>Continuation (后续)</h2>
<p>在一个程序执行的任意时刻，尚未执行的代码称为 Continuation。</p>
<pre><code>const printAsString = (num) =&gt; console.log(`Given ${num}`)

const addOneAndContinue = (num, cc) =&gt; {
  const result = num + 1
  cc(result)
}

addOneAndContinue(2, printAsString) // 'Given 3'
</code></pre>
<p>Continuation 在异步编程中很常见，比如当程序需要接收到数据才能够继续执行。请求的响应通常作为代码的剩余执行部分，一旦接收到数据，对数据的处理被作为 Continuation。</p>
<pre><code>const continueProgramWith = (data) =&gt; {
  // 继续执行程序
}

readFileAsync('path/to/file', (err, response) =&gt; {
  if (err) {
    // 错误处理
    return
  }
  continueProgramWith(response)
})
</code></pre>
<h2>纯函数 (Purity)</h2>
<p>输出仅由输入决定，且不产生副作用。</p>
<pre><code>const greet = (name) =&gt; `hello, ${name}`

greet('world')
</code></pre>
<p>以下代码不是纯函数：</p>
<pre><code>window.name = 'Brianne'

const greet = () =&gt; `Hi, ${window.name}`

greet() // "Hi, Brianne"
</code></pre>
<p>以上示例中，函数输出基于在函数外部存储的数据。</p>
<pre><code>let greeting

const greet = (name) =&gt; {
    greeting = `Hi, ${name}`
}

greet('Brianne')
greeting // "Hi, Brianne"
</code></pre>
<p>以上示例中，函数修改了外部状态。</p>
<ul>
<li>
<p>示例</p>
<pre><code>const greet = (name) =&gt; `hello, ${name}`

greet('world')
</code></pre>
</li>
</ul>
<h2>副作用 (Side effects)</h2>
<p>如果一个函数或者表达式除了返回一个值之外，还与外部可变状态进行了交互（读取或写入），则它是有副作用的。</p>
<pre><code>const differentEveryTime = new Date()
</code></pre>
<pre><code>console.log('IO就是一种副作用!')
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>const differentEveryTime = new Date()
</code></pre>
</li>
</ul>
<h2>幂等 (Idempotent)</h2>
<p>如果一个函数执行多次皆返回相同的结果，则它是幂等的。</p>
<pre><code>f(f(x)) ≍ f(x)
</code></pre>
<pre><code>Math.abs(Math.abs(10))
</code></pre>
<pre><code>sort(sort(sort([2, 1])))
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>Math.abs(Math.abs(Math.abs(12.5)))
</code></pre>
</li>
</ul>
<h2>Point-Free 风格 (Point-Free Style)</h2>
<p>定义函数时，不显式地指出函数所带参数。这种风格通常需要柯里化或者高阶函数。也叫 Tacit programming。</p>
<pre><code>// 已知：
const map = (fn) =&gt; (list) =&gt; list.map(fn)
const add = (a) =&gt; (b) =&gt; a + b

// 所以：

// 非Points-Free —— number 是显式参数
const incrementAll = (numbers) =&gt; map(add(1))(numbers)

// Points-Free —— list 是隐式参数
const incrementAll2 = map(add(1))
</code></pre>
<p><code>incrementAll</code> 识别并且使用了 <code>numbers</code> 参数，因此它不是 Point-Free 风格的。 <code>incrementAll2</code> 仅连接函数与值，并不提及它所使用的参数，因为它是 Point-Free 风格的。</p>
<p>Point-Free 风格的函数就像平常的赋值，不使用 <code>function</code> 或者 <code>=&gt;</code>。</p>
<ul>
<li>
<p>示例</p>
<pre><code>const map = (fn) =&gt; (list) =&gt; list.map(fn)
const add = (a) =&gt; (b) =&gt; a + b

// Points-Free   list 是显式参数
const incrementAll = (numbers) =&gt; map(add(1))(numbers)

// Points-Free   list 是隐式参数
const incrementAll2 = map(add(1))
</code></pre>
</li>
</ul>
<h2>断定 (Predicate)</h2>
<p>根据输入返回 true 或 false。通常用在 array filter 的回调函数中。</p>
<pre><code>const predicate = (a) =&gt; a &gt; 2

;[1, 2, 3, 4].filter(predicate)
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>const predicate = (a) =&gt; a &gt; 2

const results = [1, 2, 3, 4].filter(predicate)

console.log(results)
</code></pre>
</li>
</ul>
<h2>契约 (Contracts)</h2>
<p>契约规定了函数或表达式在运行时的行为的职责和保障。它表现为一组规则，这些规则是对函数或表达式的输入和输出的期望。当违反契约时，将抛出一个错误。</p>
<pre><code>// 定义的contract: int -&gt; boolean
const contract = (input) =&gt; {
  if (typeof input === 'number') return true
  throw new Error('Contract Violated: expected int -&gt; int')
}

const addOne = (num) =&gt; contract(num) &amp;&amp; num + 1

addOne(2) // 3
addOne('hello') // 违反了contract: int -&gt; boolean
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>const contract = (input) =&gt; {
  if (typeof input === 'number') return true
  throw new Error('Contract Violated: expected int -&gt; int')
}

const addOne = (num) =&gt; contract(num) &amp;&amp; num + 1

addOne(2)
addOne('hello')
</code></pre>
</li>
</ul>
<h2>范畴 (Category)</h2>
<p>在范畴论中，范畴是指对象集合及它们之间的态射 (morphism)。在编程中，数据类型作为对象，函数作为态射。</p>
<p>一个有效的范畴遵从以下三个原则：</p>
<ol>
<li>必有一个同一态射（identity morphism）将一个对象映射到它自身。即当 <code>a</code> 是范畴里的一个对象时，必有一个函数使 <code>a -&gt; a</code>。</li>
<li>态射必是可组合的。<code>a</code>，<code>b</code>，<code>c</code> 是范畴里的对象，<code>f</code> 是态射 <code>a -&gt; b</code>，<code>g</code> 是 <code>b -&gt; c</code> 态射。<code>g(f(x))</code> 一定与 <code>(g • f)(x)</code> 是等价的。</li>
<li>组合满足结合律。<code>f • (g • h)</code> 与 <code>(f • g) • h</code> 是等价的。</li>
</ol>
<p>由于这些准则是在非常抽象的层面控制着组合方式，因此范畴论对于发现组合的新方法来说是伟大的。</p>
<h2>值 (Value)</h2>
<p>任何可以赋给变量的东西叫做值。</p>
<pre><code>5
Object.freeze({name: 'John', age: 30})
;(a) =&gt; a
;[1]
undefined
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>5Object.freeze({name: 'John', age: 30});(a) =&gt; a;[1]undefined
</code></pre>
</li>
</ul>
<h2>常量 (Constant)</h2>
<p>一旦被定义之后就不可以被重新赋值。</p>
<pre><code>const five = 5
const john = Object.freeze({name: 'John', age: 30})
</code></pre>
<p>常量是<a>引用透明</a>的，也就是说，它们可以被它们所代表的值替代而不影响结果。</p>
<p>对于以上两个常量，以下语句总会返回 true。</p>
<pre><code>john.age + five === ({name: 'John', age: 30}).age + (5)
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>const five = 5const john = Object.freeze({name: 'John', age: 30})john.name = 'xiange'console.log(john)john.age + five === ({name: 'John', age: 30}).age + (5)
</code></pre>
</li>
</ul>
<h2>函子 (Functor)</h2>
<p>函子是一个实现了 <code>map</code> 函数的对象。<code>map</code> 函数会遍历对象中的每个值并生成一个新的对象，遵守两个准则:</p>
<h3>一致性 (Preserves identity)</h3>
<pre><code>object.map(x =&gt; x) ≍ object
</code></pre>
<h3>组合性 (Composable)</h3>
<pre><code>object.map(compose(f, g)) ≍ object.map(g).map(f)  // f, g 为任意函数
</code></pre>
<p>(<code>f</code>, <code>g</code> 是任意的函数)</p>
<p>在 javascript 中一个常见的函子是 Array, 因为它遵守因子的两个准则。</p>
<pre><code>const f = x =&gt; x + 1
const g = x =&gt; x * 2

;[1, 2, 3].map(x =&gt; f(g(x)))
;[1, 2, 3].map(g).map(f)
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>const f = x =&gt; x + 1
const g = x =&gt; x * 2

const a = [1, 2, 3].map(x =&gt; f(g(x)))
const b = [1, 2, 3].map(g).map(f)

console.log(a, b)

const Container = function (x) {
  this.__value = x  
}

Container.of = (x) =&gt; new Container(x) 

// console.log(Container.of(3))
// console.log(Container.of('hello, world'))
// console.log(Container.of(Container.of(3)))

Container.prototype.map = function (f) {
  return Container.of(f(this.__value))
}

// console.log(Container.of(3).map(x =&gt; x + 2))
// console.log(Container.of('hello, world.').map(s =&gt; s.toUpperCase()))
const compose = (f, g) =&gt; x =&gt; f(g(x))

const r1 = Container.of(3).map(x =&gt; x + 2).map(x =&gt; x * 3)
const r2 = Container.of(3).map(compose(x =&gt; x * 3, x =&gt; x + 2))

console.log(r1, r2)
</code></pre>
</li>
</ul>
<h3>指向函子 (Pointed Functor)</h3>
<p>一个对象，拥有一个<code>of</code>函数，可以将一个任何值放入它自身。</p>
<p>ES2015 添加了 <code>Array.of</code>，使 Array 成为了 Pointed Functor。</p>
<pre><code>Array.of(1)
</code></pre>
<h2>抬升 (Lift)</h2>
<p>抬升是指将一个值放进一个对象（如<a>函子</a>）中。如果你将一个函数抬升到一个<a>应用函子</a>中，那么就可以将它作用于该函子中的值。</p>
<pre><code>const liftA2 = (f) =&gt; (a, b) =&gt; a.map(f).ap(b) // 注意这里是 ap 而不是 map.

const mult = a =&gt; b =&gt; a * b

const liftedMult = liftA2(mult) // 这个函数现在可以作用于函子，如Array

liftedMult([1, 2], [3]) // [3, 6]
liftA2(a =&gt; b =&gt; a + b)([1, 2], [3, 4]) // [4, 5, 5, 6]
</code></pre>
<p>抬升并应用一个单参数的函数的作用等同于 <code>map</code>。</p>
<pre><code>const increment = (x) =&gt; x + 1

lift(increment)([2]) // [3]
;[2].map(increment) // [3]
</code></pre>
<h2>引用透明性 (Referential Transparency)</h2>
<p>如果一个表达式能够被它的值替代而不改变程序的行为，则它是引用透明的。</p>
<p>例如我们有 greet 函数：</p>
<pre><code>const greet = () =&gt; 'hello, world.'
</code></pre>
<p>任何对 <code>greet()</code> 的调用都可以被替换为 <code>Hello World!</code>, 因此 greet 是引用透明的。</p>
<h2>等式推理 (Equational Reasoning)</h2>
<p>当一个应用程序由表达式组成并且没有副作用时，我们可以从这些组成部分中得知系统的真相。</p>
<h2>Lambda</h2>
<p>一种可以被视作一个值的匿名函数。</p>
<pre><code>;(function (a) {
    return a + 1
})

;(a) =&gt; a + 1
</code></pre>
<p>Lambda 通常作为参数被传递给高阶函数。</p>
<pre><code>[1, 2].map((a) =&gt; a + 1)
</code></pre>
<p>可以把 Lambda 赋值给一个变量。</p>
<pre><code>const add1 = (a) =&gt; a + 1
</code></pre>
<h2>Lambda演算 (Lambda Calculus)</h2>
<p>数学的一个分支，使用函数创造 <a href="https://en.wikipedia.org/wiki/Lambda_calculus">通用计算模型</a></p>
<h2>惰性求值 (Lazy evaluation)</h2>
<p>惰性求值是一种按需调用的求值机制，它将表达式的求值延迟到需要它的值为止，在函数式语言中，允许类似无限列表这样的结构存在，而这在非常重视命令顺序的命令式语言中通常是不可用的。</p>
<pre><code>const rand = function* () {
  while (true) {
    yield Math.random()  
  } 
}

const randIter = rand()
randIter.next() // 每次执行产生一个随机值，表达式会在需要时求值。
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>const f = x =&gt; x + 1
const g = x =&gt; x * 2

const a = [1, 2, 3].map(x =&gt; f(g(x)))
const b = [1, 2, 3].map(g).map(f)

console.log(a, b)

const Container = function (x) {
  this.__value = x  
}

Container.of = (x) =&gt; new Container(x) 

// console.log(Container.of(3))
// console.log(Container.of('hello, world'))
// console.log(Container.of(Container.of(3)))

Container.prototype.map = function (f) {
  return Container.of(f(this.__value))
}

// console.log(Container.of(3).map(x =&gt; x + 2))
// console.log(Container.of('hello, world.').map(s =&gt; s.toUpperCase()))
const compose = (f, g) =&gt; x =&gt; f(g(x))

const r1 = Container.of(3).map(x =&gt; x + 2).map(x =&gt; x * 3)
const r2 = Container.of(3).map(compose(x =&gt; x * 3, x =&gt; x + 2))

console.log(r1, r2)
</code></pre>
</li>
</ul>
<h2>幺半群 (Monoid)</h2>
<p>一个对象，它拥有一个函数，这个函数用来与另一个相同类型的对象“结合”。对象的类型（半群）必须具有一个“identity”值。</p>
<p>数值加法是一个简单的幺半群:</p>
<pre><code>1 + 1   // 2
</code></pre>
<p>以上示例中，数是对象而 <code>+</code> 是函数。</p>
<p>当任何一个值与“identity”值结合时，结果一定是原始的值。“identity”也是可换位的（即排列次序不影响结果）。</p>
<p>加法的特征值是 0。</p>
<pre><code>1 + 0   // 1
</code></pre>
<p>操作的组合不会影响结果（必须满足结合律）:</p>
<pre><code>1 + (2 + 3) === (1 + 2) + 3 // true
</code></pre>
<p>数组的结合也是幺半群:</p>
<pre><code>;[1, 2].concat([3, 4]) // [1, 2, 3, 4]
</code></pre>
<p><code>identity</code> 值为空数组</p>
<pre><code>;[1, 2].concat([])
</code></pre>
<p>减法作为一个反例，不形成幺半群，因为不存在可以换位的“identity”值。</p>
<pre><code>0 - 4 === 4 - 0 // false
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>Array.empty = () =&gt; []

[1, 2, 3].concat(Array.empty())
</code></pre>
</li>
</ul>
<h2>单子 (Monad)</h2>
<p>拥有 <code>of</code> 和 <code>chain</code> 函数的对象即为单子。<code>chain</code> 很像 <code>map</code>， 不同的是它可以展平嵌套数据。</p>
<pre><code>Array.prototype.chain = function (f) {
  return this.reduce((acc, it) =&gt; acc.concat(f(it)), [])  
}

// 使用
;Array.of('cat,dog', 'fish,bird').chain(s =&gt; s.split(',')) // ['cat', 'dog', 'fish', 'bird']

// 和 map 相比
;Array.of('cat,dog', 'fish,bird').map(s =&gt; s.split(',')) // [['cat', 'dog'], ['fish', 'bird']]
</code></pre>
<p>在有些函数式语言中，of也称为return, chain也称为flatmap与bind</p>
<ul>
<li>
<p>示例</p>
<pre><code>Array.prototype.chain = function (f) {
  return this.reduce((acc, it) =&gt; acc.concat(f(it)), [])  
}

Array.prototype.ap = function (xs) {
  return this.reduce((acc, f) =&gt; acc.concat(xs.map(f)), [])
}

// ['cat', 'dog', 'fish', 'bird']
const a = Array.of('cat,dog', 'fish,bird').chain(s =&gt; s.split(','))

// Derived from chain and of
const animals = Array.of('cat,dog', 'fish,bird')
const f = s =&gt; s.split(',')

const b = animals.map(f)
const c = animals.chain(x =&gt; {
  return Array.of(f(x))
})
const d = [f].ap(animals)

// map :: function(f) { return this.chain(a =&gt; this.of(f(a))); }
console.log(a, b, c, d)
</code></pre>
</li>
</ul>
<h2>余单子 (Comonad)</h2>
<p>拥有 <code>extract</code> 与 <code>extend</code> 函数的对象。</p>
<pre><code>const CoIdentity = (v) =&gt; ({
  val: v,
  extract () {
    return this.val  
  },
  extend (f) {
    return CoIdentity(f(this))  
  }
})
</code></pre>
<p>Extract 将值从余单子中取出。</p>
<pre><code>CoIdentity(1).extract() // 1
</code></pre>
<p>Extends 在余单子上运行一个函数。这个函数会返回和余单子相同的类型。</p>
<pre><code>CoIdentity(1).extend(x =&gt; x.extract() + 1) // CoIdentity(2)
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>const CoIdentity = (v) =&gt; ({
  val: v,
  extract () {
    return this.val  
  },
  extend (f) {
    return CoIdentity(f(this))  
  }
})

const a = CoIdentity(1).extract()
const b = CoIdentity(1).extend(x =&gt; x.extract() + 1)

console.log(a, b)
</code></pre>
</li>
</ul>
<h2>应用函子 (Applicative Functor)</h2>
<p>一个拥有 <code>ap</code> 函数的对象称为应用函子。<code>ap</code> 将对象中的函数应用于另一个同样类型的对象中的值。</p>
<pre><code>// 实现
Array.prototype.ap = function (xs) {
    return this.reduce((acc, f) =&gt; acc.concat(xs.map(f)), [])
}

// 示例
;[(a) =&gt; a + 1].ap([1]) // [2]
</code></pre>
<p>如果你有两个对象，并需要对他们的元素执行一个二元函数，这将会很有用。</p>
<pre><code>// 你想要组合的两个数组
const arg1 = [1, 3]
const arg2 = [4, 5]

// 组合函数 - 必须要柯里化
const add = (x) =&gt; (y) =&gt; x + y

const partiallyAppliedAdds = [add].ap(arg1) // [(y) =&gt; 1 + y, (y) =&gt; 3 + y]
</code></pre>
<p>由此得到了一个函数数组，并且可以调用 <code>ap</code> 函数得到结果。</p>
<pre><code>partiallyAppliedAdds.ap(arg2) // [5, 6, 7, 8]
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>Array.prototype.ap = function (xs) {
  return this.reduce((acc, f) =&gt; acc.concat(xs.map(f)), [])  
}

const r1 = [(a) =&gt; a + 1].ap([1])

console.log(r1)

const arg1 = [1, 3, 5]
const arg2 = [4, 5]

const add = x =&gt; y =&gt; x + y
const mult = x =&gt; x * 3

const r2 = [add].ap(arg1)
const r3 = r2.ap(arg2)

const r4 = [add].ap(arg1).ap(arg2)
const r5 = arg1.map(add).ap(arg2)
const r6 = arg2.map(add).ap(arg1)

console.log(r3, r4, r5, r6)

// derived from chain
Array.prototype.chain = function (f) {
  return this.reduce((acc, it) =&gt; acc.concat(f(it)), [])  
}

const adds = [x =&gt; x + 1, x =&gt; x * 2]
const r7 = adds.ap(arg2)
const r8 = adds.chain(f =&gt; arg2.chain(f))

console.log(r7, r8)
</code></pre>
</li>
</ul>
<h2>态射 (Morphism)</h2>
<p>一个变形函数。</p>
<h3>Endomorphism (自同态)</h3>
<p>输入输出是相同类型的函数。</p>
<pre><code>// uppercase :: String -&gt; String
const uppercase = (str) =&gt; str.toUpperCase()

// decrement :: Number -&gt; Number
const decrement = (x) =&gt; x - 1
</code></pre>
<h3>Isomorphism (同构)</h3>
<p>两个不用类型的对象之间的变换，保持结构并且不丢失数据。</p>
<p>例如，一个二维坐标既可以表示为数组 <code>[2, 3]</code>，也可以表示为对象 <code>{x: 2, y: 3}</code>。</p>
<pre><code>// 提供函数在两种类型间互相转换
const pairToCoords = (pair) =&gt; ({x: pair[0], y: pair[1]})

const coordsToPair = (coords) =&gt; [coords.x, coords.y]

coordsToPair(pairToCoords([1, 2])) // [1, 2]

pairToCoords(coordsToPair({x: 1, y: 2})) // {x: 1, y: 2}
</code></pre>
<h3>Homomorphism (同态)</h3>
<p>同态只是一个保持结构的映射，实际上，函子只是<a>范畴</a>之间的同态，因为它在映射下保持了原范畴的结构。</p>
<pre><code>A.of(f).ap(A.of(x)) == A.of(f(x))

Either.of(_.toUpper).ap(Either.of("oreos")) == Either.of(_.toUpper("oreos"))
</code></pre>
<h3>Catamorphism</h3>
<p>一个 <code>reduceRight</code> 函数，它应用于累加器(accumulator)和数组中的每个值（从右到左），来将其缩减为一个单一的值。</p>
<h3>Anamorphism</h3>
<p>一个 <code>unfold</code> 函数。<code>unfold</code> 是 <code>fold</code>（<code>ruduce</code>）的反面。它从一个值生成一个列表。</p>
<pre><code>const unfold = (f, seed) =&gt; {
  function go(f, seed, acc) {
    const res = f(seed);
    return res ? go(f, res[1], acc.concat([res[0]])) : acc;
  }
  return go(f, seed, [])
}
</code></pre>
<pre><code>const countDown = n =&gt; unfold((n) =&gt; {
  return n &lt;= 0 ? undefined : [n, n - 1]
}, n)

countDown(5) // [5, 4, 3, 2, 1]
</code></pre>
<h3>Hylomorphism</h3>
<p>Anamorphism 和 catamorphism 的结合。</p>
<h3>Paramorphism</h3>
<p>一类类似于 <code>reduceRight</code> 的函数，不过还是有区别的：</p>
<p>在Paramorphism中，reducer的参数是当前的值、所有先前的值的缩减(reduction，即reduce的结果)、以及形成该缩减的值的列表。</p>
<pre><code>// 包含 undefined 对于列表来说显然是不安全的，
// 但是足以说明问题。
const para = (reducer, accumulator, elements) =&gt; {
  if (elements.length === 0)
    return accumulator

  const head = elements[0]
  const tail = elements.slice(1)

  return reducer(head, tail, para(reducer, accumulator, tail))
}

const suffixes = list =&gt; para(
  (x, xs, suffxs) =&gt; [xs, ... suffxs],
  [],
  list
)

suffixes([1, 2, 3, 4, 5]) // [[2, 3, 4, 5], [3, 4, 5], [4, 5], [5], []]
</code></pre>
<p>上面的例子中的 reducer（<code>[x, ... xs]</code>）的第三个参数有点像一个“如何达到你当前的 acc 值”的历史记录。</p>
<h3>Apomorphism</h3>
<p>paramorphism 的反面。就像 anamorphism 是 catamorphism 的反面一样。对于 paramorphism，我们结合了对累加器的访问和已经累加的东西，而apomorphism让我们可以 unfold（展开）并且具有提早return的可能性。</p>
<h2>Setoid</h2>
<p>拥有 <code>equals</code> 函数的对象。<code>equals</code> 可以用来和其它相同类型的对象比较。</p>
<pre><code>Array.prototype.equals = function (arr) {
  const len = this.length
  if (len !== arr.length) {
    return false
  }
  for (let i = 0; i &lt; len; i++) {
    if (this[i] !== arr[i]) {
      return false
    }
  }
  return true
}

;[1, 2].equals([1, 2])   // true
;[1, 2].equals([3, 4])   // false
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>Array.prototype.equals = function (arr) {
  const len = this.length
  if (len !== arr.length) {
    return false
  }
  for (let i = 0; i &lt; len; i++) {
    if (this[i] !== arr[i]) {
      return false
    }
  }
  return true
}

const a = [1, 2].equals([1, 2]) // true
const b = [1, 2].equals([0]) // false

console.log(a, b)
</code></pre>
</li>
</ul>
<h2>半群 (Semigroup)</h2>
<p>一个拥有 <code>concat</code> 函数的对象。<code>concat</code> 可以连接相同类型的两个对象。</p>
<pre><code>;[1].concat([2]) // [1, 2]
</code></pre>
<ul>
<li>
<p>示例</p>
<pre><code>js const x = [1, 2, 3] const y = [4, 5, 6] const z = [7, 8, 9] const r1 = x.concat(y).concat(z) const r2 = x.concat(y.concat(z)) console.log(r1, r2)
</code></pre>
</li>
</ul>
<h2>可折叠性 (Foldable)</h2>
<p>一个拥有 <code>reduce</code> 函数的对象具有可折叠性。<code>reduce</code> 可以把一种类型的对象转化为另一种类型。</p>
<pre><code>const sum = (list) =&gt; list.reduce((acc, val) =&gt; acc + val, 0)
sum([1, 2, 3])        // 6
</code></pre>
<h2>透镜 (Lens)</h2>
<p>Lens是一种结构（通常是一个对象或者函数），他为其他数据结构对 getter 和非可变的 setter 进行配对。</p>
<pre><code>// 使用 [Ramda's lens](http://ramdajs.com/docs/#lens)
const nameLens = R.lens(
  // 一个对象的 name 属性的 getter
  (obj) =&gt; obj.name,
  // name 属性的 setter
  (val, obj) =&gt; Object.assign({}, obj, {name: val})
)
</code></pre>
<p>为给定的数据结构设置 <code>get</code> 和 <code>set</code> 可以实现一些关键特性。</p>
<pre><code>const person = {name: 'Gertrude Blanch'}

// 调用 getter
R.view(nameLens, person) // 'Gertrude Blanch'

// 调用 setter
R.set(nameLens, 'Shafi Goldwasser', person) // {name: 'Shafi Goldwasser'}

// 将函数应用于结构中的值
R.over(nameLens, uppercase, person) // {name: 'GERTRUDE BLANCH'}
</code></pre>
<p>lens 也是可以组合的。这让我们可以对深度嵌套的数据进行简单的不可变更新。</p>
<pre><code>// 这个 lens 关注一个非空数组中的第一个元素
const firstLens = R.lens(
  // 获取数组的第一个元素
  xs =&gt; xs[0],
  // 数组的第一个元素的非可变 setter
  (val, [__, ...xs]) =&gt; [val, ...xs]
)

const people = [{name: 'Gertrude Blanch'}, {name: 'Shafi Goldwasser'}]

// 无论你怎么想，lens 是从左到右合成的
R.over(compose(firstLens, nameLens), uppercase, people) // [{'name': 'GERTRUDE BLANCH'}, {'name': 'Shafi Goldwasser'}]
</code></pre>
<p>其他实现:</p>
<p><a href="https://github.com/calmm-js/partial.lenses">partial.lenses</a> - “好吃”的语法糖和很多强大功能</p>
<p><a href="http://www.kovach.me/nanoscope/">nanoscope</a> - 流畅接口</p>
<h2>类型签名 (Type Signatures)</h2>
<p>通常 js 中的函数会在注释中指出参数与返回值的类型。</p>
<p>在整个社区内存在很大的差异，但通常遵循以下模式：</p>
<pre><code>// functionName :: firstArgType -&gt; secondArgType -&gt; returnType

// add :: Number -&gt; Number -&gt; Number
const add = (x) =&gt; (y) =&gt; x + y

// increment :: Number -&gt; Number
const increment = (x) =&gt; x + 1
</code></pre>
<p>如果函数接受其他函数作为参数，那么这个函数需要用括号括起来。</p>
<pre><code>// call :: (a -&gt; b) -&gt; a -&gt; b
const call = (f) =&gt; (x) =&gt; f(x)
</code></pre>
<p>字符 <code>a</code>, <code>b</code>, <code>c</code>, <code>d</code> 表明参数可以是任意类型。以下版本的 <code>map</code> 的函数类型的参数 <code>f</code>，把一种类型 <code>a</code> 的数组转化为另一种类型 <code>b</code> 的数组。</p>
<pre><code>// map :: (a -&gt; b) -&gt; [a] -&gt; [b]
const map = (f) =&gt; (list) =&gt; list.map(f)
</code></pre>
<h2>代数数据类型 (Algebraic data type)</h2>
<p>一种由其他类型组合而成的复合类型。两种常见的代数类型是sum和product。</p>
<h3>和类型 (Sum type)</h3>
<p>和类型是将两种类型组合成另一种类型。之所以称为和，是因为结果类型的可能的值的数目是两种输入类型的值的数目的和。</p>
<p>js 中没有这种类型，但是我们可以用 set 来假装：</p>
<pre><code>// 想象这些不是 set，而是仅包含这些值的某种类型。
const bools = new Set([true, false])
const halfTrue = new Set(['half-true'])

// 这个 weakLogic 类型包含 bools 类型和 halfTrue 类型的和。
const weakLogicValues = new Set([...bools, ...halfTrue])
</code></pre>
<p>和类型有时也称作联合类型（union type）、区分联合（discriminated union）或标记联合（tagged unions）。</p>
<p>JS中有一些库可以帮助定义和使用联合类型。</p>
<p>流（flow）包括联合类型，而TypeScript具有提供相同能力的枚举（enum）。</p>
<h3>Product type</h3>
<p>用一种你可能更熟悉的方式把数据类型联合起来:</p>
<pre><code>// point :: (Number, Number) -&gt; {x: Number, y: Number}
const point = (x, y) =&gt; ({x: x, y: y})
</code></pre>
<p>之所以称之为积，是因为数据结构的总的可能值是不同值的乘积。许多语言都有 tuple 类型，这是积类型的最简单形式。</p>
<p>另见 <a href="https://en.wikipedia.org/wiki/Set_theory">Set theory</a></p>
<h2>可选类型 (Option)</h2>
<p>Option 是一种联合类型，它有两种情况，<code>Some</code> 或者 <code>None</code>。</p>
<p>Option对于一些可能不会返回值的组合函数非常有用。</p>
<pre><code>// 简单的定义
const Some = (v) =&gt; ({
  val: v,
  map (f) {
    return Some(f(this.val))
  },
  chain (f) {
    return f(this.val)
  }
})

const None = () =&gt; ({
  map (f) {
    return this
  },
  chain (f) {
    return this
  }
})

// maybeProp :: (String, {a}) -&gt; Option a
const maybeProp = (key, obj) =&gt; typeof obj[key] === 'undefined' ? None() : Some(obj[key])
</code></pre>
<p>使用 <code>chain</code> 可以序列化返回 <code>Option</code> 的函数。</p>
<pre><code>// getItem :: Cart -&gt; Option CartItem
const getItem = (cart) =&gt; maybeProp('item', cart)

// getPrice :: Item -&gt; Option Number
const getPrice = (item) =&gt; maybeProp('price', item)

// getNestedPrice :: cart -&gt; Option a
const getNestedPrice = (cart) =&gt; getItem(obj).chain(getPrice)

getNestedPrice({}) // None()
getNestedPrice({item: {foo: 1}}) // None()
getNestedPrice({item: {price: 9.99}}) // Some(9.99)
</code></pre>
<p>在其它的一些地方，<code>Option</code> 也称为 <code>Maybe</code>，<code>Some</code> 也称为 <code>Just</code>，<code>None</code> 也称为 <code>Nothing</code>。</p>
<p><a href="https://github.com/shfshanyue/fp-jargon-zh/blob/master/demos/option.js">示例 option.js</a> <a href="https://github.com/shfshanyue/fp-jargon-zh/blob/master/demos/maybe.js">示例 maybe.js</a></p>
<h2>Function</h2>
<p>一个函数 <code>f :: A =&gt; B</code> 是一个表达式，通常称为 arrow 或者 lambda 表达式——只能有<strong>一个</strong>（这点是不可变的）的 <code>A</code> 类型参数和<strong>一个</strong> <code>B</code> 类型返回值。该返回值完全取决于参数，使函数独立于上下文，或者说引用透明。这里暗示的是一个函数不能产生任何隐藏的副作用——根据定义，函数总是纯的。这些属性使函数易于使用：它们是完全确定的，因此也是可以预测的。函数可以将代码作为数据进行处理，对行为进行抽象：</p>
<pre><code>// times2 :: Number -&gt; Number
const times2 = n =&gt; n * 2

[1, 2, 3].map(times2) // [2, 4, 6]
</code></pre>
<h2>偏函数 (Partial function)</h2>
<p>偏函数是没有为全部参数定义的函数——它可能返回意料之外的结果或者永远不会终止。偏函数增加了认知开销，它们更难推理，并可能导致运行时错误。一些例子：</p>
<pre><code>// 例1: 列表的和
// sum :: [Number] -&gt; Number
const sum = arr =&gt; arr.reduce((a, b) =&gt; a + b)
sum([1, 2, 3]) // 6
sum([]) // TypeError: Reduce of empty array with no initial value

// 例2: 获取列表的第一个值
// first :: [A] -&gt; A
const first = a =&gt; a[0]
first([42]) // 42
first([]) // undefined
// 甚至更糟: 
first([[42]])[0] // 42
first([])[0] // Uncaught TypeError: Cannot read property '0' of undefined

// 例3: 将函数重复 N 次
// times :: Number -&gt; (Number -&gt; Number) -&gt; Number
const times = n =&gt; fn =&gt; n &amp;&amp; (fn(n), times(n - 1)(fn))
times(3)(console.log)
// 3
// 2
// 1
times(-1)(console.log)
// RangeError: Maximum call stack size exceeded
</code></pre>
<h3>处理偏函数</h3>
<p>偏函数是危险的，它们需要被非常谨慎地对待。你可能会得到意料之外的（错误的）结果或遇到运行时错误。有时偏函数可能根本不会返回。意识到并相应地处理所有这些边缘情况可能会变得非常乏味。幸运的是，部分函数可以转换为常规函数。我们可以提供默认值或使用 guard 来处理偏函数未定义的输入。利用 option 类型，我们可以在可能会出现意外行为的地方使用 yield <code>Some(value)</code> 或 <code>None</code>:</p>
<pre><code>// 例1: 列表的和
// 我们可以提供默认值，使它总会返回结果
// sum :: [Number] -&gt; Number
const sum = arr =&gt; arr.reduce((a, b) =&gt; a + b, 0)
sum([1, 2, 3]) // 6
sum([]) // 0

// 例2: 获取列表的第一个值
// 将结果改为 Option
// first :: [A] -&gt; A
const first = a =&gt; a.length ? Some(a[0]) : None()
first([42]).map(a =&gt; console.log(a)) // 42
first([]).map(a =&gt; console.log(a)) // console.log 不会执行
//我们之前的糟糕情况
first([[42]]).map(a =&gt; console.log(a[0])) // 42
first([]).map(a =&gt; console.log(a[0])) // 不会执行，所以不会有 error
// 更重要的是，通过返回类型 (Option) ，我们会知道：
// 我们应该使用 .map 方法来访问数据，所以我们不会忘记检查输入，
// 因为这样的检查会被内建在函数中。

// 例3: 将函数重复 N 次
// 我们需要通过改变条件来确保函数总会终止: 
// times :: Number -&gt; (Number -&gt; Number) -&gt; Number
const times = n =&gt; fn =&gt; n &gt; 0 &amp;&amp; (fn(n), times(n - 1)(fn))
times(3)(console.log)
// 3
// 2
// 1
times(-1)(console.log)
// 不会再执行
</code></pre>
<p>将偏函数改成全函数可以防止此类运行时错误。总是返回一个“值”也会使得代码更容易维护和推理。</p>
<h2>在 js 中的函数式编程库</h2>
<ul>
<li><a href="https://github.com/swannodette/mori">mori</a></li>
<li><a href="https://github.com/facebook/immutable-js/">Immutable</a></li>
<li><a href="https://github.com/immerjs/immer">Immer</a></li>
<li><a href="https://github.com/ramda/ramda">Ramda</a></li>
<li><a href="https://github.com/char0n/ramda-adjunct">ramda-adjunct</a></li>
<li><a href="http://folktalejs.org/">Folktale</a></li>
<li><a href="https://cwmyers.github.io/monet.js/">monet.js</a></li>
<li><a href="https://github.com/lodash/lodash">lodash</a></li>
<li><a href="https://github.com/jashkenas/underscore">Underscore.js</a></li>
<li><a href="https://github.com/dtao/lazy.js">Lazy.js</a></li>
<li><a href="https://github.com/sjsyrek/maryamyriameliamurphies.js">maryamyriameliamurphies.js</a></li>
<li><a href="https://github.com/casualjavascript/haskell-in-es6">Haskell in ES6</a></li>
<li><a href="https://github.com/sanctuary-js/sanctuary">Sanctuary</a></li>
<li><a href="https://github.com/evilsoft/crocks">Crocks</a></li>
<li><a href="https://github.com/fluture-js/Fluture">Fluture</a></li>
<li><a href="https://github.com/gcanti/fp-ts">fp-ts</a></li>
</ul>
]]></content>
        <author>
            <name>Lainbo</name>
            <uri>https://lainbo.dev/</uri>
        </author>
        <published>2022-08-06T00:00:00.000Z</published>
    </entry>
</feed>